8.3 技术融合:MPC 与 HE、ZKP、DP 混编
8.3 技术融合:MPC 与 HE、ZKP、DP 混编
本节摘要:成熟系统里 MPC 很少独奏:同态加密帮它造预处理材料、零知识证明帮它堵输入造假的口子、差分隐私帮它给输出加保护垫。本节把第 2.5 节的分工表落到三种成熟的组合模式,并给出每种模式的适用判据。
定位:本节解决什么
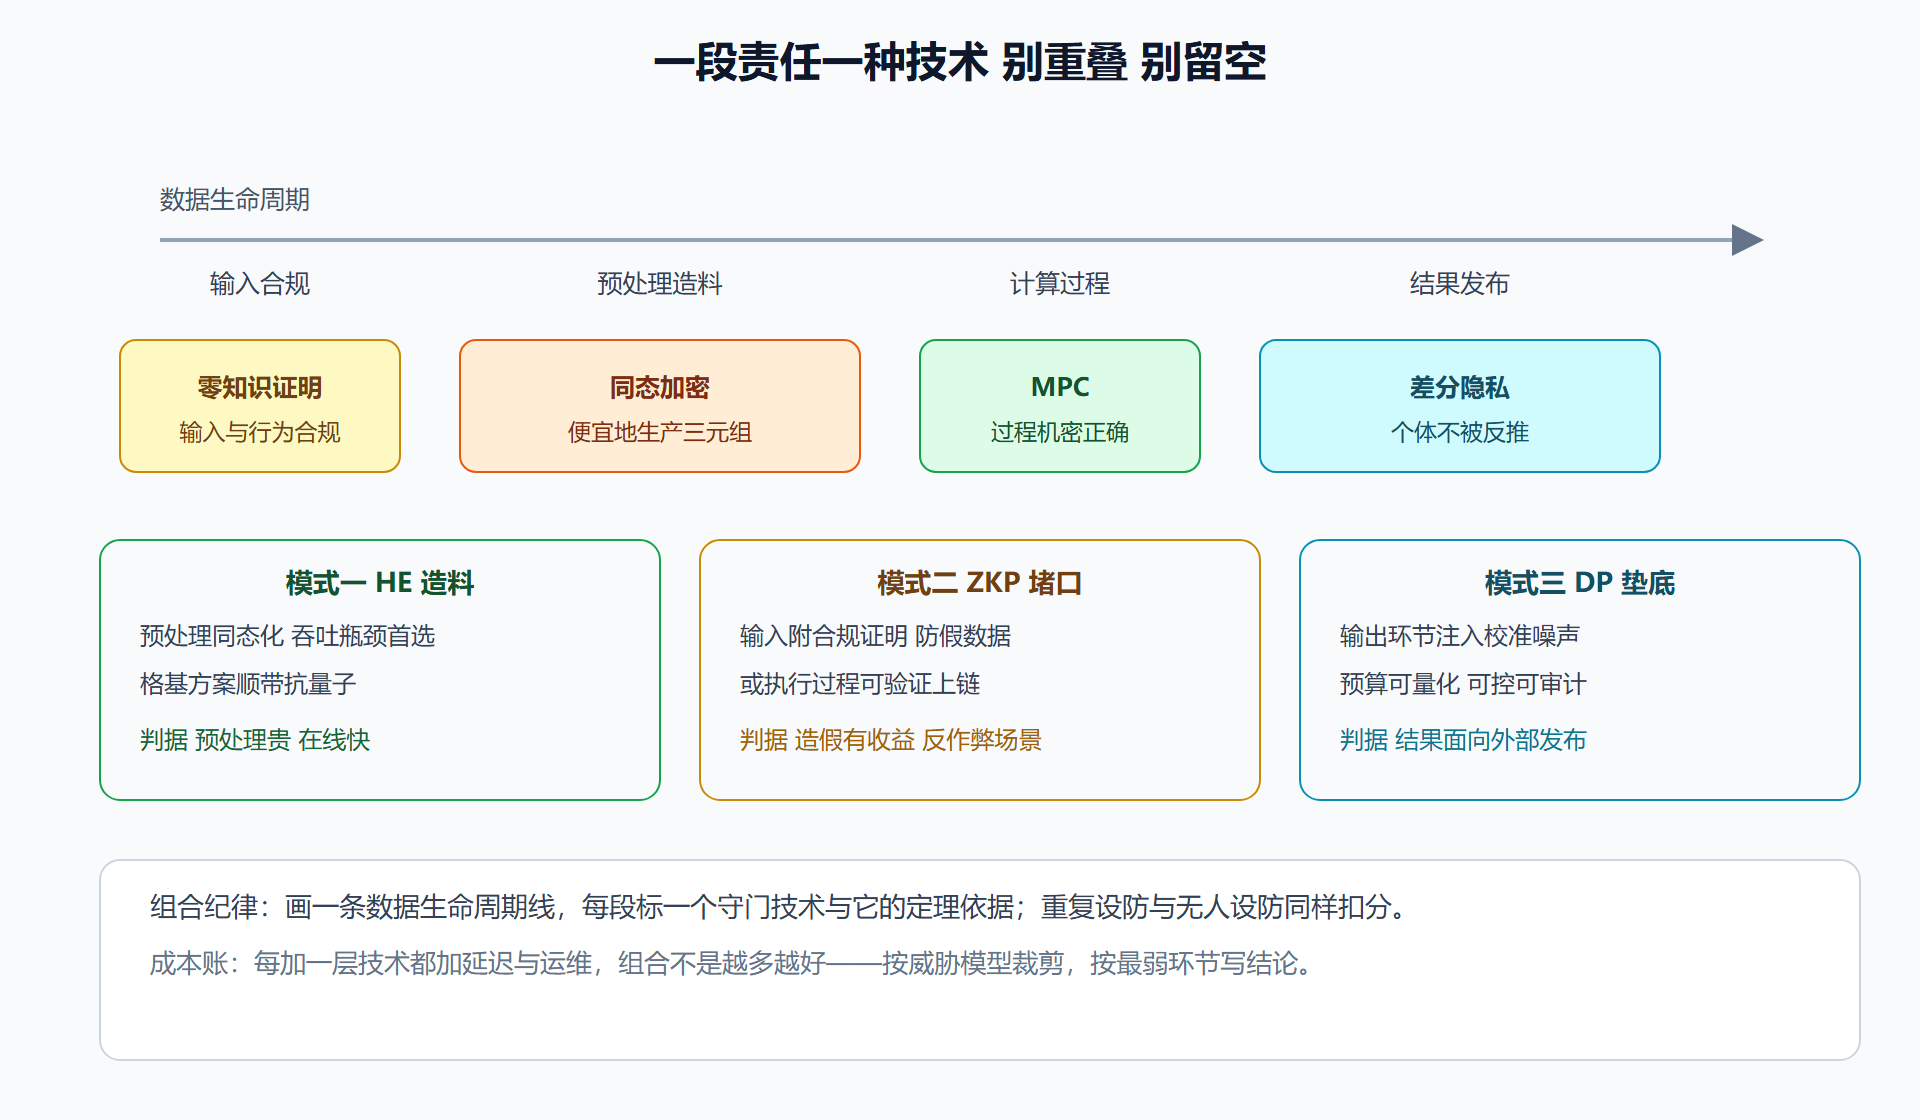
前两章反复出现"混合架构"这个词,本节把它讲系统化。单个技术各有短板:MPC 不防输入造假(参与方提交假数据骗联合结果)、输出本身可能泄露个体(统计结果的差分攻击)、预处理造料太贵。这三块短板恰好是三样技术的长板:零知识证明管"输入与行为合规"、差分隐私管"输出统计安全"、同态加密管"预处理便宜"。组合的设计纪律只有一条:每种技术守一段明确的责任边界,别让两种技术守同一段(浪费),更别留没人守的段(漏洞)。
核心概念:三种成熟组合模式
模式一:HE 造料 + MPC 在线(最普遍)。 SPDZ 预处理的三元组用加法同态加密生产:各方加密自己的随机数并同态相乘,省掉大量在线交互(5.1 节提过)。格基同态方案还顺带解决量子安全(8.1 节)。适用判据:预处理吞吐是瓶颈、在线延迟敏感——绝大多数生产部署的实际形态。模式二:MPC + ZKP 堵输入口(恶意场景标配)。 MPC 保证"输入在协议内不被偷",但防不了"输入本身是假的"——刷量方提交伪造特征骗联合评分。补法:各参与方对自己的输入附零知识证明,证明"输入来自我方真实数据库的合规提取"而不泄露输入内容;或在结果输出时对执行过程附可验证计算证明。适用判据:输入造假有明确收益的场景(营销反作弊、补贴风控、保险理赔)。模式三:MPC + DP 双层输出保护(统计发布标配)。 MPC 保证过程安全,但对"结果本身"无能为力——精确到个人的统计结果可能被差分攻击反推。补法:在 MPC 的输出环节注入校准噪声(噪声也可在密域内以分享形式加入),以可量化的隐私预算保护个体。适用判据:对外发布统计量、数据个体价值极高的场景(医疗统计、人口分析)。
图:责任边界划分与三种模式
动手演练:MPC 输出加差分噪声
import random, math def laplace_noise(sensitivity, epsilon): """拉普拉斯机制:尺度 b 等于敏感度除以 epsilon(可逆均匀采样法)。""" b = sensitivity / epsilon u = random.random() - 0.5 # 均匀变量 return -b * math.copysign(1, u) * math.log(1 - 2 * abs(u)) true_mean_income = 8600.0 noisy = true_mean_income + laplace_noise(sensitivity=500.0, epsilon=1.0) print(round(noisy, 1)) # 例 8384.7 每次发布都不同 无法反推个体
会话输出一个围绕真实均值、按拉普拉斯分布抖动的数字。生产实现里噪声在 MPC 内部以分享形式生成并融入结果,发布值既过统计关也过隐私预算关。
工程实践要点
先画责任线再写代码:评审一套混合方案,先要那张"生命周期线加守门技术"的图——画不出来的方案,九成存在重复设防或无人设防。噪声要进密域:对外发布统计时,差分噪声应在 MPC 内部生成并融入结果,若在明文侧由单方加噪,加噪方成了新的信任锚点。证明的粒度选择:ZKP 补输入合规时,证明"提取过程合规"比证明"数据为真"可行得多——后者退化成数据溯源问题,超出密码学管辖。
💡 关键直觉:混合架构的价值不在"技术多",在"每段责任的定理依据清楚"。把每种技术当成一名只守一段的哨兵,部署图就是排班表。
本节要点:三种模式各守一段责任边界;组合纪律是每段一个守门技术与定理依据;噪声进密域、证明管合规这两处是最常踩的细节。下一节直面 MPC 自己的边界。
组合反模式清单
正向模式之外,负向清单同样有价值。四种常见的组合反模式。反模式一:装饰性技术堆叠。 方案里同时宣称 MPC 加 TEE 加区块链加 AI,每项技术都出现在 PPT、没有一项出现在责任边界图上——组合的意义在守责任,不在凑名词。反模式二:噪声外挂。 差分噪声在明文侧由单一运营方加入(8.3 节说过,这里再记一笔),加噪方获得了"决定加多少噪"的权力,保护承诺随之打折。反模式三:证明空转。 零知识证明证明的是"计算过程合规",但若输入提取环节本身没有合规审计,证明守着一段无威胁的边界,真正的口子敞着。反模式四:双重设防不同档。 同一段责任叠了两层技术,一层恶意安全一层半诚实,预算翻倍而安全仍按弱者计——组合的边际收益要按最弱环节算。
四种反模式的共同病因:先定技术清单再找责任边界,顺序反了。正确的动线永远是先画数据生命周期线、再为每段选守门技术——评审混合方案时,先要那张线图,没有线图的方案一票退回。
混编系统的测试策略
组合系统比单体系统多出一类独有缺陷:接缝缺陷——单段正确、拼接出错。四条针对接缝的测试策略。边界穿越用例:为每段责任边界构造恰好压线的输入(落在输出粒度边界的值、隐私预算恰好耗尽的发布),接缝处的舍入、截断、噪声叠加最容易在压线值上出错。段间中间值对账:把每段的输出存档,与下一段的输入核对——格式、精度、编码任何一处不一致都是潜在缺陷,对账脚本是混编系统的标配基建。降级演练:逐段摘除非核心层(关掉噪声层、跳过证明层),确认系统在降级模式下行为可预期且有明确告警——防止某层静默失效而无人察觉。端到端预算复核:隐私预算、性能预算逐段累加后与承诺值核对,段段达标、总体超标是最常见的算术陷阱。
四条策略的共同前提:混编系统的测试范围是"接缝数加一段",而不是各段测试的简单相加。评审供应商的测试报告时,看它有没有接缝测试章节,比看功能用例数量更能判断工程成熟度——这一条同样适用于你自己团队交付的每一份混合方案。
混编方案的汇报话术
混编方案向非技术决策层汇报时,一套经过验证的话术结构:先讲业务问题("两家机构要联合算一个指标"),再讲泄露顾虑("直接交换会暴露什么"),然后给责任边界图("每一段由哪项技术把守"),最后给代价("速度是明文的几十分之一,但换来的是不需要互信")。全程零密码学名词——同态、混淆、仿真一个都不提。这不是回避深度,而是 respect 决策层的注意力结构:决策者要的是边界与代价,名词是工程师之间的通讯协议。两套话语自由切换,是混编时代工程师的最后一块拼图。