2.1 缺失值处理:dropna 与 fillna 的取舍
2.1 缺失值处理:dropna 与 fillna 的取舍
本节摘要:缺失值是择菜间最日常的活——dropna 负责扔,fillna 负责补,interpolate 负责按趋势插值。本节按食谱卡讲透这组函数的参数与取舍:什么时候删得起,什么时候必须补,补又该用均值、前后值还是插值。承接第 1 章的类型验收,通往 2.2 的异常值侦缉。
某天早上交过来的坑
某天早上,运营把一张销售明细丢过来,第一句话是"数字好像有点空"。打开一看:渠道列空着零星几格,金额列空了一片,时间列还缺了整段上午。空格的处理方式直接决定当天所有结论的方向——全删可能删掉一半样本,全填零会把"未知"伪装成"没卖"。本节要建立的,就是面对空格时的处置次序:先量缺失的规模与分布,再决定删、填还是插值。它是择菜间五道工序的头一道,往前接第 1 章的验收(缺失率就写在验收单上),往后把干净些的数据交给 2.2 去揪异常。
适用场景:删、填、插,各有各的料
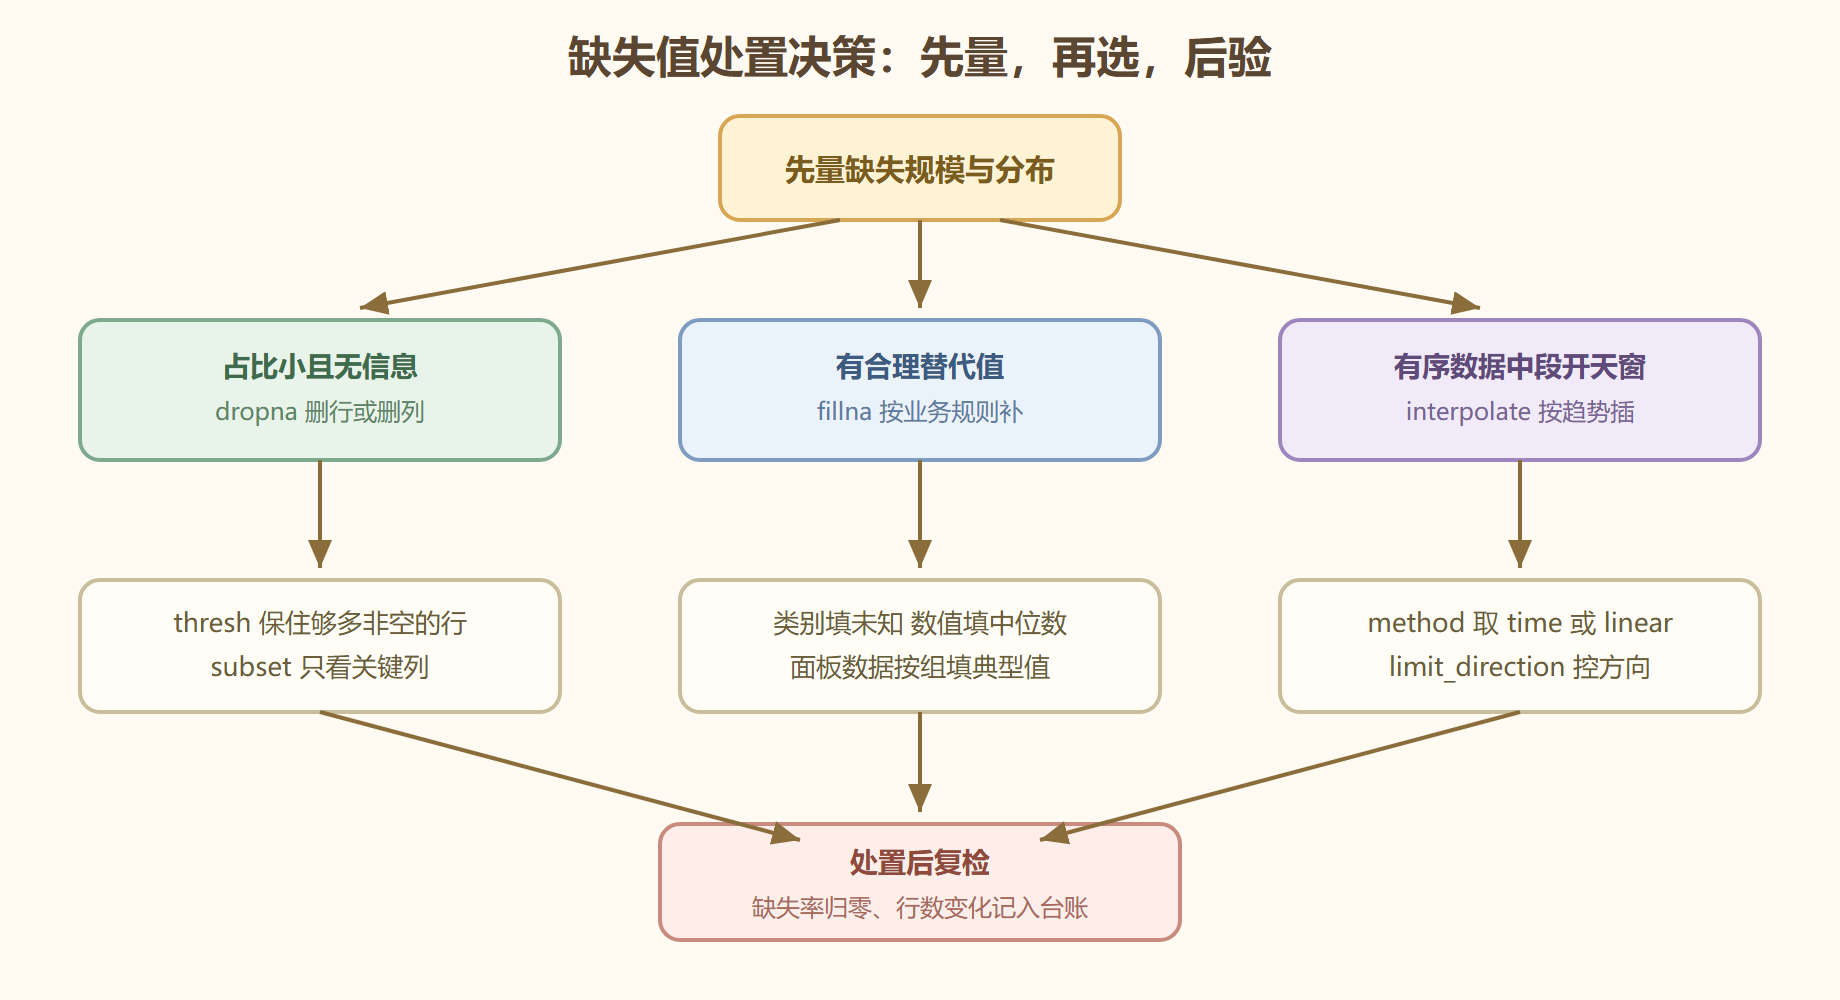
dropna 适合缺失占比小、且缺失本身无信息的场合——一百行缺两行,删了不心疼;缺失若意味着"没转化",删掉反而毁掉业务含义。fillna 适合缺失有合理替代值的场合——类别列填"未知"、数值列填均值或中位数、面板数据按组填同组的典型值。interpolate 适合有序数据——时间序列前后都有值,中间空一格,按趋势插一条最合理。先想清楚空格的业务含义,再挑工具,次序不能反。
图 缺失值处置决策流程
参数拆解:火候旋钮逐个拧
**dropna(axis=0, how='any', subset=None, thresh=None)**:how='any' 是"有一个空就删",how='all' 是"全空才删";subset 把检查范围缩到关键列——只认订单号和金额,备注列空着不管;thresh 是"至少留够几个非空值",thresh=2 表示非空不足的行才删,比 how 精细。**fillna(value, method=None, limit=None)**:value 可以是标量、字典(按列给不同填充值)或 Series(按索引对齐填充);method='ffill' 顺着把上一个非空值往下带,'bfill' 反着来;limit 限制最多连续补多少格。新版本 pandas 更推荐直接用 df.ffill() 与 df.bfill() 这两个短函数,fillna 的 method 参数已进入弃用流程。**interpolate(method='linear', limit_direction='forward')**:linear 按线性补,time 按时间间隔加权;对时间序列记得先排好序再插,否则插出来的趋势是乱的。
import pandas as pd import numpy as np df = pd.DataFrame({ "订单号": ["A1", "A2", "A3", "A4"], "渠道": ["直营", np.nan, np.nan, "分销"], "金额": [120.0, np.nan, 88.0, np.nan], }) # 各列缺失体检 print(df.isna().mean().round(2)) # 渠道 0.50 # 金额 0.50 # 删:只看关键列"金额",且至少保留非空值 print(df.dropna(subset=["金额"], thresh=1)) # 订单号 渠道 金额 # 0 A1 直营 120.0 # 2 A3 NaN 88.0
实操示例:一套完整的缺失处置
把"先量、再选、后验"走成一段可复用的流程。场景:渠道是低基数的类别列,填"未知";金额按渠道分组填同渠道中位数——比全表中位数更贴近业务;时间留到 2.4 再矫正。
# 填:类别列给"未知" df["渠道"] = df["渠道"].fillna("未知") # 填:金额按渠道分组,用组内中位数(transform 保证对齐回原行) df["金额"] = df["金额"].fillna(df.groupby("渠道")["金额"].transform("median")) # 验:处置后复检 print(df.isna().mean()) # 全为 0.0 print(df) # 订单号 渠道 金额 # 0 A1 直营 120.0 # 1 A2 未知 88.0 <- 未知组只有它缺,回落到全列中位数 # 2 A3 未知 88.0 # 3 A4 分销 88.0 <- 分销组无样本,同样回落
注意末两行的细节:分组中位数填充并非万能——某组全是空值时,transform 的结果也是空,fillna 会回落到"没得填",此时要再兜一层全列中位数。这个组合拳写成一行:先组内、后全列,两次 fillna 叠着用。
坑点与翻车
**翻车一:fillna(df.mean()) 的对齐魔法与陷阱。**给 fillna 传一个 Series,pandas 会按索引(对列来说按列名)对齐填充——所以 df.fillna(df.mean()) 是"每列填各列的均值"。但若 DataFrame 行索引不是默认整数(比如刚 merge 过),行为就容易超出直觉;稳妥做法是显式按列写:df["金额"] = df["金额"].fillna(df["金额"].median())。
**翻车二:删除前不算账。**dropna() 一把梭,回头发现删掉了将近一半的行,样本结构变形。删除永远是最后手段,动手前先 print(len(df)) 与 df.dropna().shape 对个账,删多少要心里有数。
**翻车三:时间序列乱序插值。**interpolate 按行的先后位置算趋势,数据没排序就插,等于用乱序的刻度画平滑曲线——先 sort_values 再 interpolate,是时间列的固定纪律。
替代方案
sklearn 的 SimpleImputer(strategy 取 mean、median、most_frequent 或 constant)与 pandas 的 fillna 干同样的活,好处是能塞进 Pipeline,把"训练集学到的填充值"原封不动套到测试集上,避免数据泄漏。填充之外还有一招"留痕":加一列 是否缺失 的布尔标记,把"缺失"本身作为信息交给下游模型——有时比填什么值都管用。
本节要点回顾
- 先量再选:isna().mean() 量化缺失,分布决定删、填、插的方向;
- dropna 三参数:subset 圈范围,thresh 定底线,how 选宽严;
- fillna 对齐:传 Series 按索引对齐,按列显式写最稳;新版用 ffill、bfill 短函数;
- 分组填充:groupby + transform(median) 是面板数据的标配,注意空组回落;
- 替代方案:SimpleImputer 进流水线防泄漏;缺失标记列是第四条路。
空格处理完,下一道工序盯那些"数值离谱"的记录:2.2 用分位数与 Z 分数两把尺,把异常值请出来审。