2.2 异常值处理:分位数与 Z 分数两把尺
2.2 异常值处理:分位数与 Z 分数两把尺
本节摘要:异常值是择菜间最考手艺的活——判得准是清洗,判错了是毁证。本节给出 IQR 与 Z 分数两把尺的用法与宽严差别,再把处置拆成删除、截尾、分箱三道闸,强调动手前先过业务复核。承接 2.1 的缺失处置,通往 2.3 的重复清理。
为什么均值会离谱到这一步
一份日常客单价不过几十的报表,均值怎么就飙到了上万?多半不是顾客突然豪气,而是混进了录错单位的订单、刷单的测试数据、或者小数点点错位的金额。异常值的麻烦在于它特别能带节奏——均值、方差、连回归的系数都会被它拽偏。所以清洗阶段必须过一遍"离谱侦缉"。本节承接 2.1:缺失处理完,数据里还剩那些"数值在但不合理"的记录;本节结束时,你手里会多两把尺和三道闸,通往 2.3 之前,先把离谱的数安置妥当。
适用场景:两把尺各量什么
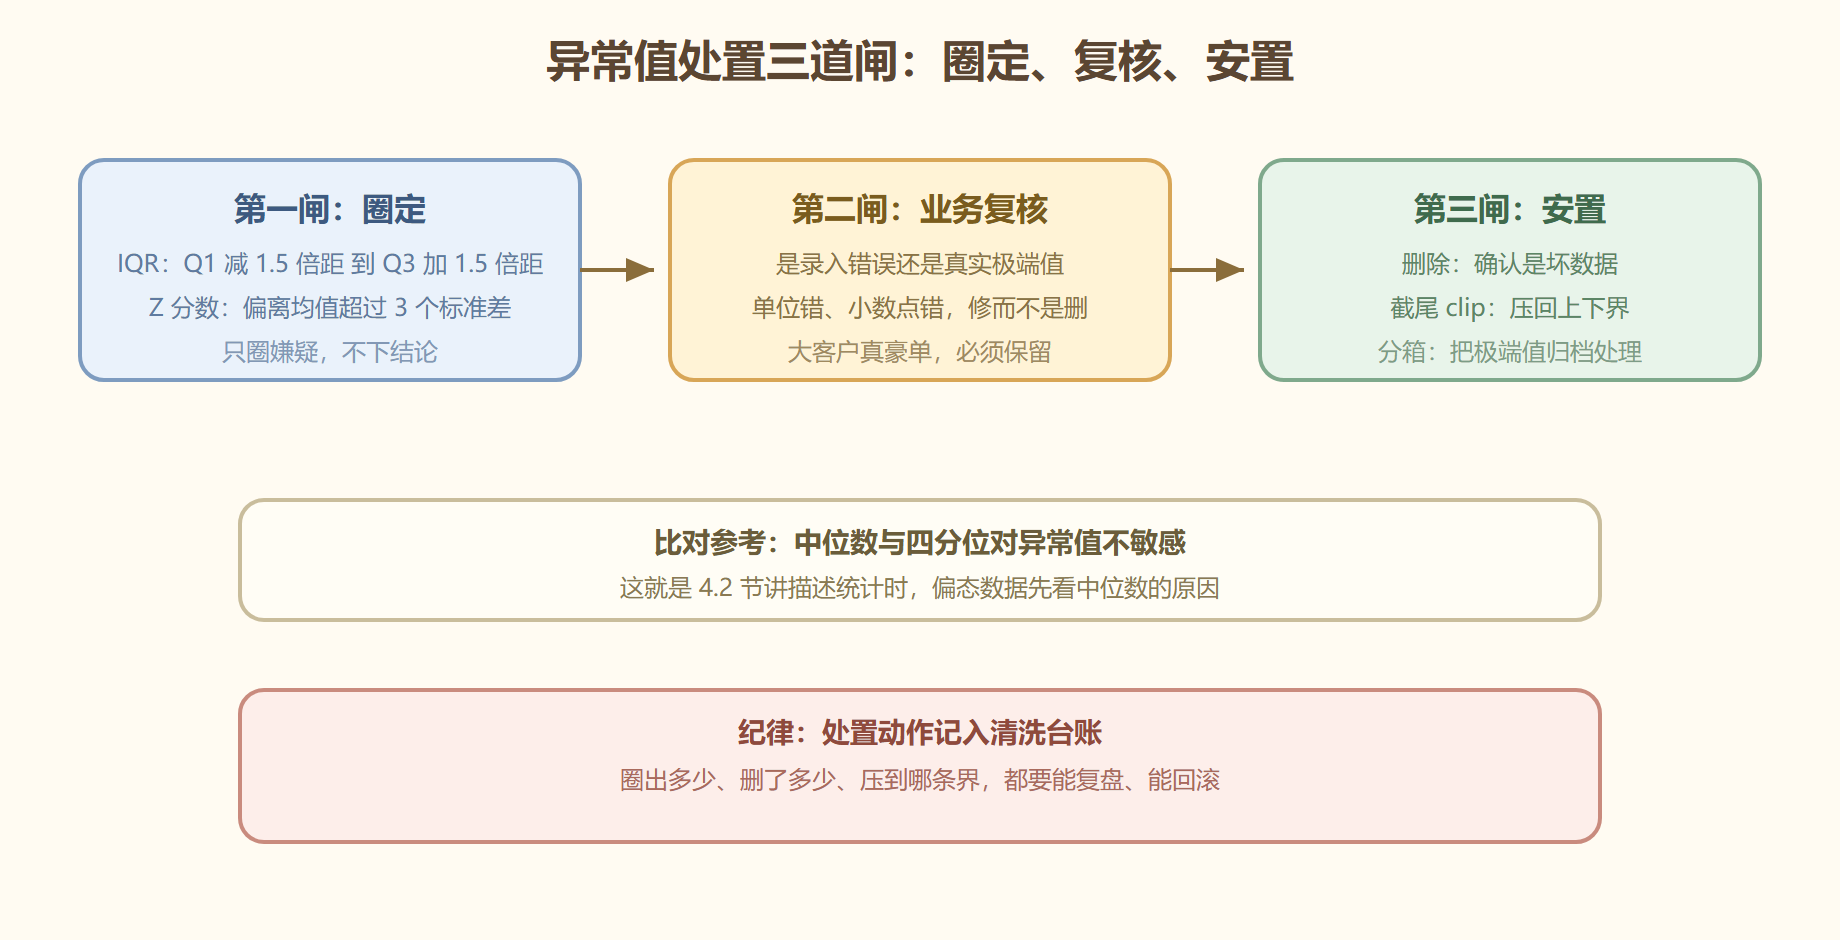
IQR(四分位距)法不依赖均值方差,只看分位数,对偏态分布更稳:低于 Q1 减 1.5 倍 IQR 或高于 Q3 加 1.5 倍 IQR 的值判可疑。Z 分数法假设数据大体对称:偏离均值超过 3 个标准差的值判可疑。经验法则是——分布偏(金额、时长这类右偏数据)用 IQR;分布对称且近似正态(身高、误差)用 Z 分数。两把尺都只是"嫌疑圈定",圈出来不等于有罪,先复核再处置。
图 异常值处置三道闸
参数拆解:尺子与闸门的旋钮
Series.quantile(q):q 给 0.25 与 0.75 得四分位,IQR 即两者之差;它默认跳过缺失,不受 NaN 干扰。scipy.stats.zscore(数据, nan_policy='omit'):nan_policy 必须显式给,否则遇缺失直接返回一列 NaN;也可以手写 (x - x.mean()) / x.std(),注意 pandas 的 std 默认 ddof=1(样本标准差),NumPy 默认 ddof=0,两种口径数值略有差异。**Series.clip(lower, upper)**:把越界值压回边界,适合"保留样本但削弱影响"的场合;给 inplace=False 的习惯,别让截尾悄悄改了原表。
import pandas as pd import numpy as np from scipy import stats amount = pd.Series([56, 62, 48, 71, 55, 49, 6800, 58, 63, 52.0]) # 第一把尺:IQR q1, q3 = amount.quantile(0.25), amount.quantile(0.75) iqr = q3 - q1 lo, hi = q1 - 1.5 * iqr, q3 + 1.5 * iqr print(lo, hi) # 约 33.1 与 87.9 print(amount[(amount < lo) | (amount > hi)]) # 圈出 6800.0 # 第二把尺:Z 分数 z = stats.zscore(amount, nan_policy="omit") print(amount[np.abs(z) > 3].tolist()) # 圈出 6800.0(本例两尺结论一致)
实操示例:圈定之后,过三道闸
圈出 6800 之后直接删是新手动作,正确次序是复核再安置。假设业务确认 6800 是录错的单位(元记成了分),应当修;若是真实大单,应当留;只有确认无法修复的坏数据才删。下面演示"复核后选择截尾"与"确认坏数据后删除"两种结局。
# 结局一:真实极端值,截尾压界(保留样本、削弱影响) clipped = amount.clip(lo, hi) print(clipped.max()) # 87.9 <- 6800 被压回上界 # 结局二:确认录错且无法回溯修复,删除 cleaned = amount[(amount >= lo) & (amount <= hi)] print(len(cleaned), cleaned.mean().round(1)) # 9 57.1 <- 删除前后均值对比要记入台账 # 处置台账:删除比例必须可交代 print(f"圈定 {sum((amount < lo) | (amount > hi))} 条,删除 {len(amount) - len(cleaned)} 条")
坑点与翻车
**翻车一:Z 分数在偏态数据上大面积误伤。**金额类右偏分布里,长尾本身正常,用"偏离均值 3 个标准差"去量,会把一批真实大单全圈成异常。看到分布先想形状:右偏就换 IQR,或者先取对数再量。**翻车二:把"异常"当"错误"删。**风控、反欺诈场景里,最值钱的信息恰恰藏在异常里——一刀删下去,等于把线索也销毁了。**翻车三:clip 的边界用了测试集的极值。**训练时截尾用的界,必须来自训练数据本身;拿全量数据定的界再套回训练集,属于轻度数据泄漏,第 7 章讲 sklearn 预处理时会再点一次名。
进阶组合:分组内的异常圈定
全表一把尺在大业务里会误伤:餐饮渠道的单价天然高于零售,用同一道闸,等于拿一把尺量所有菜系。正确姿势是"分组量尺"——按渠道分组算各自的分位边界,再用 transform 回填到每一行。这是 2.1 分组填充思路在异常侦缉里的复用,也是第 4 章汤锅区的一次提前点名。
import pandas as pd df = pd.DataFrame({ "渠道": ["餐饮", "餐饮", "餐饮", "零售", "零售", "零售"], "金额": [320.0, 280.0, 9000.0, 45.0, 52.0, 700.0], }) grp = df.groupby("渠道")["金额"] q1, q3 = grp.transform(lambda s: s.quantile(0.25)), grp.transform(lambda s: s.quantile(0.75)) iqr = q3 - q1 suspect = (df["金额"] > q3 + 1.5 * iqr) | (df["金额"] < q1 - 1.5 * iqr) print(df[suspect]) # 渠道 金额 # 2 餐饮 9000.0 # 5 零售 700.0 <- 各组各自的"离谱",互不干扰
餐饮渠道的边界按自己的分布算,零售的七百元大单才会现形——若用全表统一尺,餐饮的高基线会把零售的问题完全掩盖。分组量尺的代价是每组样本要够:小组没几行,分位数本身就不稳,这时退回全表尺加人工复核更诚实。
替代方案
不想删也不想压,还有条温和路线:pd.cut 分箱,把连续值切成档位,极端值自动归进最高档,降低它对下游的拉扯(cut 与 qcut 的详细用法在 2.5)。对严格右偏的金额,对数变换能先把长尾"压扁"再分析。而最优先的替代方案永远是业务规则:如果业务明确"单笔超过某阈值必为测试单",直接按规则过滤,比任何统计尺都可靠。
收档清单
- 两把尺:IQR 稳、Z 快;偏态用 IQR,对称用 Z;
- 三道闸:圈定、复核、安置,跳过复核就是毁证;
- 安置三选:删、clip 截尾、分箱,各自记台账;
- 口径提醒:pandas 的 std 默认 ddof=1,NumPy 默认 ddof=0;
- 优先级:业务规则 > 统计尺子,能修的错别删。
离谱的安置完,接着清"一模一样"的:2.3 用 drop_duplicates 处理重复记录,重点讲清 keep 参数保哪条、索引空洞怎么补。