2.4 数据类型转换:astype 与 to_* 翻译官
2.4 数据类型转换:astype 与 to_* 翻译官
本节摘要:类型错的数据,算不动、连不上、排不准。本节讲清类型矫正的分工——干净的列用 astype 直转,混着脏值的列交给 to_numeric、to_datetime 翻译,缺失场景交给可空类型。承接 2.3 的去重,通往 2.5 的缩放与编码。
不是所有"看起来像数字"的值都能直接转
不是列里印着数字,它就能按数字算——Excel 导出的金额带着千分位逗号,系统日志里的数字混着"未知",时间列干脆是一串格式各异的文本。类型矫正踩的坑,大多源于一个假设:astype 一转就完事。现实里它只在数据干净时好使;脏一点,就会当着你的面抛异常,或者悄悄把整列变成 object。本节的任务是把矫正这件事分好工:谁来转干净的,谁来转脏的,谁来兜缺失的。往前接 2.3 清好的表,往后把规整类型的料交给 2.5 做形态加工。
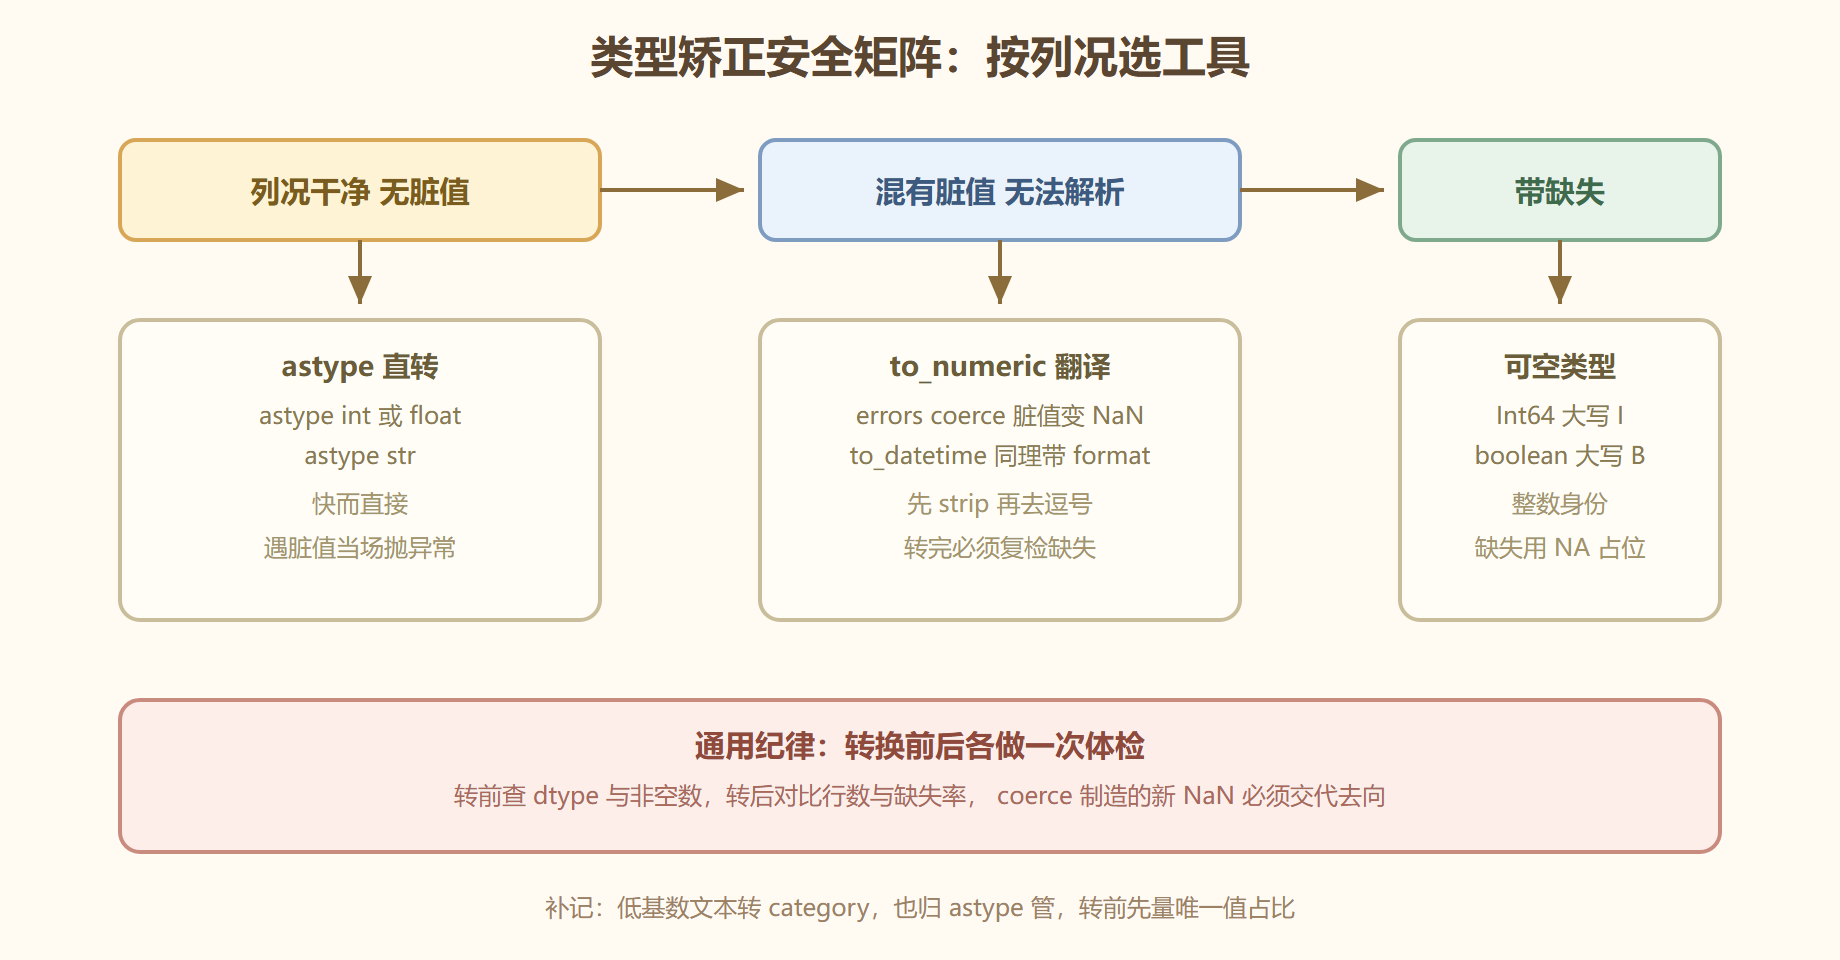
图 类型转换安全矩阵
参数拆解:翻译官的旋钮
astype(dtype):直转,不商量——astype("int")、astype("float")、astype("str")、astype("category");列里有一个转不动的值就抛异常,这正是它"干净列专用"的原因。pd.to_numeric(s, errors='raise' | 'coerce' | 'ignore', downcast=None):errors='coerce' 把转不动的值改成 NaN(最常用);'raise' 遇脏值抛异常;'ignore' 原样不动(已不推荐);downcast='integer' 或 'float' 顺手把类型压小省内存。**pd.to_datetime(s, format=None, errors='raise', unit=None)**:format 显式给格式串,既快又避免歧义;unit='s' 或 'ms' 处理 Unix 时间戳数字;unit='D' 能接 Excel 的日期序列值。**astype("Int64")**(大写 I):可空整型,整数身份与缺失共存;同族的还有 boolean。
实操示例:一列脏金额的完整矫正
场景:Excel 导出的金额列,混着千分位逗号、货币符号和"未知"。流程固定为四步:先看、再洗文本、后翻译、终复检。
import pandas as pd s = pd.Series(["1,280.00", "¥96.5", "未知", "2,040", "77"], name="金额") # 第一步:看 —— 确认是 object,脏点在哪 print(s.dtype) # object # 第二步:洗文本 —— 去逗号、去货币符号、去空白 cleaned = s.str.replace(",", "", regex=False).str.replace("¥", "", regex=False).str.strip() # 第三步:翻译 —— 转不动的一律变 NaN num = pd.to_numeric(cleaned, errors="coerce") print(num) # 0 1280.0 # 1 96.5 # 2 NaN <- "未知" 的去向,必须交代 # 3 2040.0 # 4 77.0 # 第四步:复检 —— coerce 制造了几个新缺失 print(f"新缺失数:{num.isna().sum()}") # 1,衔接 2.1 的缺失处置流程
时间列同理:pd.to_datetime(df["下单时间"], format="%Y-%m-%d %H:%M:%S", errors="coerce"),转完同样复检。format 别偷懒不给——不给时 pandas 逐行猜格式,大数据量上慢得离谱,还可能把"05-06"猜反。
一张转换速查表
类型矫正用熟之后,剩下的都是"查表"功夫。下面这张表按"从什么转成什么"组织,右列是标准动作与一句提醒,遇到拿不准的场景先来这里对号。
| 从 \ 到 | 数值 | 时间 | 类别 | 可空整型 |
|---|---|---|---|---|
| 带脏值的文本 | to_numeric 配 coerce | to_datetime 配 format 与 coerce | astype category | 先 to_numeric 再 astype |
| 干净的文本 | astype float | to_datetime 配 format | astype category | astype Int64 |
| 含缺失的浮点 | downcast 压小 | 不适用 | 不适用 | astype Int64 |
| 数字时间戳 | 保留数值本身 | to_datetime 配 unit | 不适用 | 降级防溢出 |
表里最有用的行动路线是第一行:脏文本永远走 to_* 家族而不是 astype,让"转不动"变成显式的 NaN 而不是异常中断;转完拿 2.1 的缺失体检收尾,新空值立刻就有去处。而最后一行是 Excel 用户的老朋友——五位数日期用 unit 与 origin 翻译,翻完拿 strftime 抽查一行,确认没把年份翻成几十年后。
坑点与翻车
**翻车一:astype 遇 NaN 崩整段脚本。**astype("int") 对含缺失的列直接抛异常,因为 NaN 是浮点世界的居民,住不进整型。解法看需求:允许缺失用 astype("Int64"),不允许则先用 2.1 的手法把缺失处置掉再转。**翻车二:coerce 制造的 NaN 无人认领。**errors='coerce' 不是"洗掉问题"而是"把问题集中成 NaN"——转完不复检,下游就在毫不知情里丢了样本。coerce 之后的 isna().sum() 是固定动作。**翻车三:Excel 日期变成五位数。**Excel 的日期本质是"距基准日的天数",读进来是一串整数,按 to_datetime 加 unit="D" 与起始日 origin="1899-12-30" 翻译才对。
替代方案
懒得逐列指定时,df.convert_dtypes() 让 pandas 自动推断更合理的类型(字符串、可空整型、时间),适合快速整理;但它推断的口径不一定合业务,关键列还是手动指定。读文件阶段还有更省事的路:pd.read_csv 的 dtype 参数在进口时就定好类型,dtype={"订单号": "string"},从源头省掉矫正——源头能定的,别留到清洗阶段。
收档清单
- 分工:干净用 astype,脏值用 to_numeric 与 to_datetime,缺失配 Int64;
- coerce 有代价:脏值变 NaN 不是消失,转后必须复检;
- format 必给:时间翻译显式给格式,快且不歧义;
- Excel 日期:unit='D' 加 origin 才是正解;
- 源头优先:read_csv 的 dtype 参数能定就早定。
型正了,最后一道腌制:2.5 把量纲统一(标准化、归一化)、把连续切档(分箱)、把类别摊开(独热编码),给下游模型上菜前定妆。