2.5 标准化、归一化与特征编码:上菜前定妆
2.5 标准化、归一化与特征编码:上菜前定妆
本节摘要:清洗的收尾是"腌制与定妆"——把量纲不一的数值缩到同一把尺上(标准化与归一化),把连续值切档(分箱),把类别摊开成模型可消化的形式(独热编码)。本节按食谱卡讲 StandardScaler、pd.cut、get_dummies 三件套的参数与纪律,顺带交代特征预加工的边界。承接 2.4 的类型矫正,为整个择菜间收官。
回顾手工报表时代的一桩悬案
回顾早年做报表的日子,有个经典悬案:同一个模型,喂"年龄(20 到 60)"和"收入(3000 到 90000)",训练出来的结果总偏向收入一侧——不是收入更重要,而是它的数字大,量纲把距离的发言权全抢走了。让各列回到同一把尺上,就是缩放要解决的事;而"连续的年龄切成青年、中年档位""省份文字摊成 0 与 1 的列",则是分箱与编码的活。这三件事合起来,是择菜间的最后一道工序:料已洗净,上锅之前定个妆。承接 2.4 的正型,本节之后,整个第 2 章的清洗链路就闭环了。
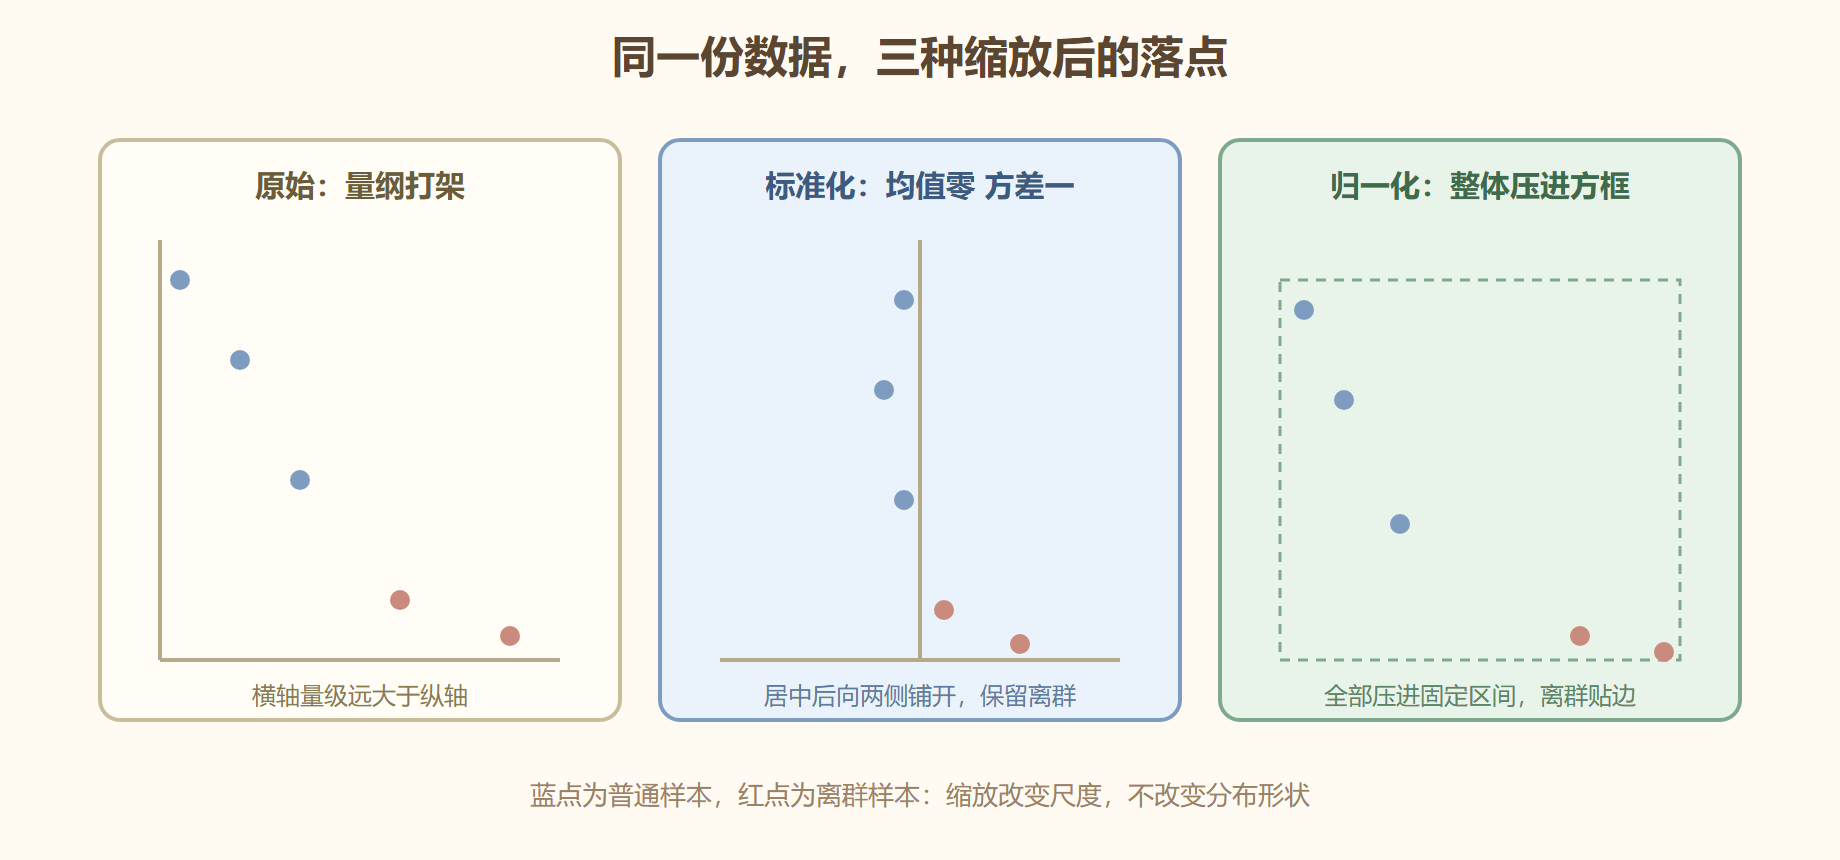
图 三种缩放的几何效果对照
参数拆解:三件套的旋钮
**StandardScaler(with_mean=True, with_std=True)**:减均值除标准差,结果均值归零、方差为一;with_mean=False 留给稀疏矩阵场景。**MinMaxScaler(feature_range=(0, 1))**:线性压进指定区间,受极值影响大——数据里有 2.2 圈过的异常时慎用。**pd.cut(s, bins, labels=None, right=True)**:等宽分箱,bins 给整数是自动等宽切几段,给列表是手工定边界;right=True 表示左开右闭。**pd.qcut(s, q)**:等频分箱,按分位数切,每段样本量接近;数据偏态时它比 cut 均匀。**pd.get_dummies(df, columns=None, drop_first=False, dummy_na=False)**:把指定类别列摊成 0 与 1 的列;drop_first=True 掉一根柱子避免完全共线;dummy_na=True 给缺失单独一根柱。
import pandas as pd from sklearn.preprocessing import StandardScaler, MinMaxScaler df = pd.DataFrame({ "年龄": [22, 35, 41, 28, 52], "收入": [3200, 8800, 15000, 5600, 22000], }) print(StandardScaler().fit_transform(df).round(2)) # [[-1.13 -0.86] # [-0.03 -0.37] # [ 0.68 0.32] # [-0.61 -0.63] # [ 1.08 1.54]] <- 两列回到同一把尺 print(MinMaxScaler().fit_transform(df).round(2)) # [[0. 0. ] # [0.37 0.3 ] # [0.57 0.63] # [0.18 0.13] # [0.93 1. ]] <- 全部压进 0 到 1
实操示例:分箱与编码的组合应用
场景:把"消费天数"切成活跃档位(分箱),把"渠道"摊成 0 与 1(编码),两步产出的宽表即可交给下游模型。
df = pd.DataFrame({ "活跃天数": [2, 15, 88, 30, 45, 8, 120, 60], "渠道": ["搜索", "推荐", "搜索", "直购", "推荐", "搜索", "直购", "推荐"], }) # 分箱:手工档位(业务口径优先),右开右闭自行声明 df["活跃档"] = pd.cut(df["活跃天数"], bins=[0, 7, 30, 90, 365], labels=["沉默", "低频", "活跃", "铁杆"], right=True) # 等频对照:每档样本量接近,适合偏态数据 df["消费分位"] = pd.qcut(df["活跃天数"], q=4, labels=["Q1", "Q2", "Q3", "Q4"]) # 编码:渠道摊开,drop_first 去一根基准柱 wide = pd.get_dummies(df["渠道"], prefix="渠道", drop_first=True) print(pd.concat([df[["活跃档", "消费分位"]], wide], axis=1)) # 活跃档 消费分位 渠道_推荐 渠道_直购 # 0 沉默 Q1 False False # 1 低频 Q2 True False # 2 活跃 Q4 False False # ...
分箱把连续值翻译成业务语言,编码把类别翻译成机器语言;两者产物都是"规整形",正是下游最爱吃的那口。
坑点与翻车
**翻车一:在全量数据上 fit。**scaler.fit(全量) 再 transform,测试集的信息已经渗进均值方差——这是数据泄漏的经典款。纪律:fit 只在训练集上做,测试集只 transform;生产管线里用 7.3 的 Pipeline 把两步锁死。**翻车二:cut 与 qcut 用混。**等宽切在偏态数据上会出现"一档挤满、一档空仓";等频切则可能把业务上不该同档的值并到一起。先想清楚要的是"等宽的边界"还是"等量的桶"。**翻车三:标准化治不了偏态。**标准化只做平移与缩放,右偏的长尾形状原样保留——想压长尾请用对数变换,两者解决的是不同问题。
替代方案
异常较多的列,RobustScaler(用中位数与 IQR 缩放)比 StandardScaler 稳,正好接上 2.2 的圈定结果;金额类右偏列先 np.log1p 再标准化,双保险。有序类别(学历、满意度档位)别用独热——astype("category") 配有序类别参数或 OrdinalEncoder 保住次序信息。生产环境的编码交给 sklearn 的 OneHotEncoder:它能记住训练时的类别清单,线上出现没见过的类别时按 handle_unknown 规则兜底,比 get_dummies 更耐撞。
本节要点回顾
- 缩放两式:StandardScaler 居中铺开,MinMaxScaler 压进区间,异常多换 RobustScaler;
- 分箱两刀:cut 等宽凭业务口径,qcut 等频抗偏态;
- 编码一条:get_dummies 快速出活,生产管线换 OneHotEncoder;
- fit 的边界:只在训练集 fit,这是不可妥协的纪律;
- 定妆不是整容:缩放不改变分布形状,压长尾得靠对数。
择菜间五道工序到此收官。下一章进切配台:洗好腌好的料,要按下锅的形状切——筛选、排序、字符串与时间的精加工,见 3.1。