4.1 分组聚合:groupby 的拆算合三步
4.1 分组聚合:groupby 的拆算合三步
本节摘要:groupby 是汤锅区的主灶——按键拆开、各组各算、结果合并,英文行话叫 split-apply-combine。本节讲清单键与多键分组、agg 的三种形态、transform 的回填本事,以及"分组后列没了"这类报错的来历。承接切配台的齐料,通往 4.2 的描述统计。
为什么两个人的月报对不上
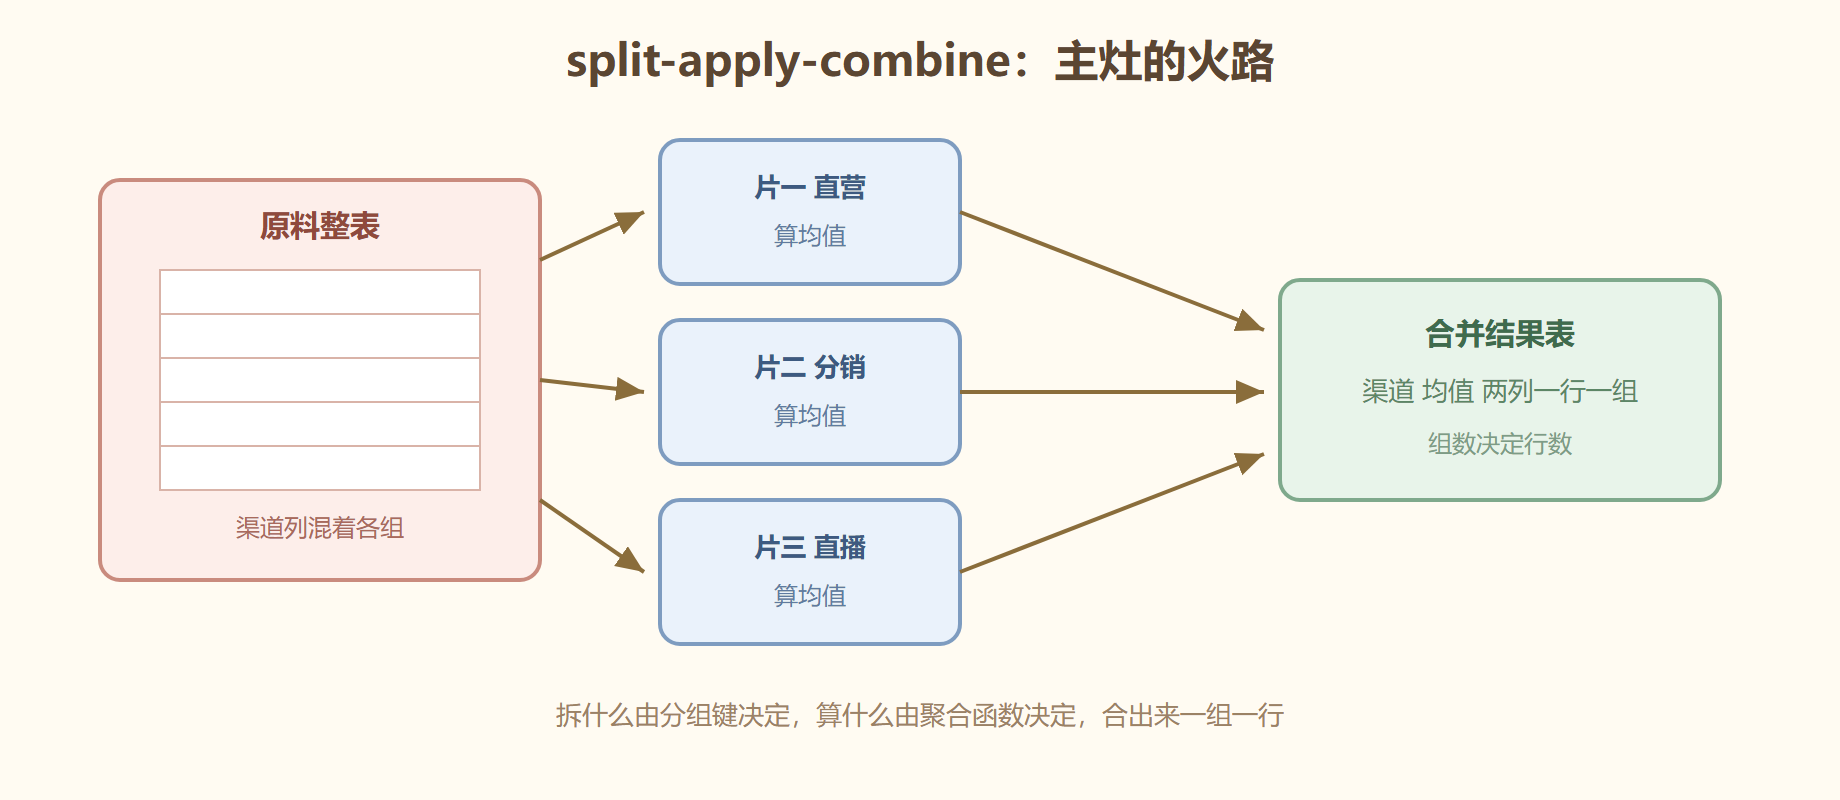
为什么同一份流水,两个人算出的"各渠道月均"能差出一截?多半是有人把"先算总量再相除"和"先算各组均值再平均"混为一谈——这正是没吃透 groupby 的典型症状。聚合的所有纠结,都可以拆回三个动作:按分组键把表拆成小片;对每个小片各算各的统计量;把小结果拼回一张表。三步想清楚,参数就只是口味调节。本节往前接切配台的干净分组键,往后把聚合产物交给 4.2 做整体体检。
图 拆、算、合三步示意
参数拆解:旋钮逐个拧
**df.groupby(by, as_index=True, sort=True, dropna=True)**:by 给单列名或列名列表;as_index=False 让分组键保留成普通列,下游直接用,省掉事后 reset_index;sort=False 保持组首次出现的顺序,比默认排序快一点;dropna 默认把分组键里的缺失丢掉——想让"未知渠道"也成一组,记得 dropna=False。**聚合三形态**:g.agg("mean") 单函数;g.agg(["mean", "max"]) 多函数出多列;命名聚合 g.agg(均价=("金额", "mean"), 最高=("金额", "max")),列名自己起,最推荐。**g.transform("mean")**:与 agg 的区别在形状——agg 一组一行,transform 按原表逐行回填,2.1 填缺失时它已经亮过相。**df.groupby 多键**:by 给列表即多级分组,结果索引是多层的,配合 5.2 的 unstack 能展开成宽表。
import pandas as pd df = pd.DataFrame({ "渠道": ["直营", "分销", "直营", "直播", "分销", "直播"], "月份": ["5月", "5月", "6月", "5月", "6月", "6月"], "金额": [120.0, 88.0, 150.0, 210.0, 95.0, 180.0], }) out = (df.groupby(["渠道", "月份"], as_index=False) .agg(单数=("金额", "count"), 总额=("金额", "sum"), 均价=("金额", "mean"))) print(out) # 渠道 月份 单数 总额 均价 # 0 直播 6月 1 180.0 180.0 # 1 直播 5月 1 210.0 210.0 # 2 分销 5月 1 88.0 88.0 # ...
实操示例:从流水到指标表
场景:把订单流水做成"渠道月报"——每组算单量、总额、均价与客单占比,一次 agg 全部产出,最后加一列占比回填。
monthly = (df.groupby(["渠道", "月份"], as_index=False) .agg(单量=("金额", "size"), 总额=("金额", "sum"))) # 各渠道占当月总额的比例:transform 把组总额逐行回填再相除 monthly["渠道占比"] = (monthly["总额"] / df.groupby("月份")["金额"].transform("sum").values).round(3) print(monthly) # size 与 count 的差别:前者连缺失也计数,后者只数非空
这里同时出现了 size 与 count:size 数所有行,count 只数非空——对账时用哪个,取决于"缺失算不算一笔业务"。把这个口径写进报表脚注,月报对不上的悬案就少了一大半。
多键分组与结果整形
单键分组是入门,报表里更常见的是多键:渠道配月份、门店配品类。多键结果的索引是多层,直接打印能看到层级,但下游往往要"平"的表——两个出口:as_index=False 让键留在普通列,或者 groupby 后接 reset_index 摊平。想直接出"行是渠道、列是月份"的二维表,则是 groupby 配 unstack 的连招,完整展开在 5.2 与 5.3。
multi = df.groupby(["渠道", "月份"])["金额"].sum() print(multi.reset_index()) # 多层索引摊平成普通表 print(multi.unstack(fill_value=0)) # 内层键抬成列,二维报表成形
两条路线产出同一份数据的两种形态——先想清楚下游要"长表还是宽表",再决定选 reset_index 还是 unstack,这比事后改形省事得多。
分组键的质量决定一切
聚合结果可信的前提,是分组键本身干净——这一站的上游正是择菜间与切配台。键里混着"直营"与"直营 "(尾随空格),分组直接裂成两组,报表凭空多出一行"幽灵渠道";键里的缺失默认被 dropna 丢弃,少了多少组毫不知情。所以聚合前的固定动作有两条:对键列跑一遍 value_counts 看看有没有"长得像"的类别;确认缺失键的去向(dropna 还是成组)写进了口径。键是汤的骨架,骨架歪一口锅,整锅汤都倒。
坑点与翻车
**翻车一:groupby 后直接取列报 KeyError。**df.groupby("渠道").金额 的写法依赖列存在性,若前面 as_index=False 或重命名过,键名对不上就报错;稳妥写法是 groupby 之后统一用中括号选列,或用命名聚合把输出列名定死。**翻车二:聚合列里混着文本。**对整组调 mean 时,组里的文本列要么被丢弃要么报错——聚合前先选好数值列,或者用 agg 指明每列的算法。**翻车三:迭代 groupby 当列表用。**for key, g in df.groupby("渠道") 里 key 是元组(多键时尤其容易忘),直接按单值解包会炸。翻车四:先聚合再筛选的次序错误。"总额过万的渠道"必须先聚合出总额再筛,反着来等于用单行金额筛组,口径全错。
替代方案
轻量场景不必上 groupby:s.value_counts() 一行给出各类计数(等价于分组计数),s.nunique() 给去重数;想要透视表形态的二维聚合,pd.pivot_table 直接到位(5.3 展开),本质是 groupby 加 unstack 的打包;复杂的多列各自聚合,命名聚合仍是首选,比事后改列名干净。
收档清单
- 三步心法:拆什么看键,算什么看函数,合出来一组一行;
- agg 三形态:单函数、函数列表、命名聚合,命名聚合最稳;
- transform 回填:组统计量按原表形状回填,占比与填充的标配;
- 口径两处:size 与 count 差一个"缺失算不算",写进脚注;
- 键的去留:as_index=False 省事,dropna 决定缺失成不成组。
主灶之外还有一口快手锅:4.2 的 describe 一键端出整表描述统计,先看看你的数长什么样。