4.2 描述性统计:describe 与统计量族
4.2 描述性统计:describe 与统计量族
本节摘要:动手分析前先看一眼数据长什么样——describe 一锅端出计数、均值、分位数、极值;单用的时候,mean、median、std、quantile 各有口径与脾气。本节讲透这些统计量的参数与误读点。承接 4.1 的聚合火路,通往 4.3 的累计滚动。
凌晨对账,先端哪口锅
凌晨对账,面对一张几十列的流水,第一反应不该是画图,也不该是建模型,而是端一口快手汤:describe 一句话,整表的计数、均值、四分位、极值全在一张小表里。哪些列量级不对劲、哪些列存在离谱极值、哪些列根本是空壳,一眼扫完。本节讲的就是这口锅与锅里的每味料:describe 怎么调,mean 与 median 差在哪,std 的自由度口径怎么回事。往前接 4.1 的分组聚合——describe 也常常配着 groupby 用;往后 4.3 的滚动计算,滚的就是本节这些统计量。
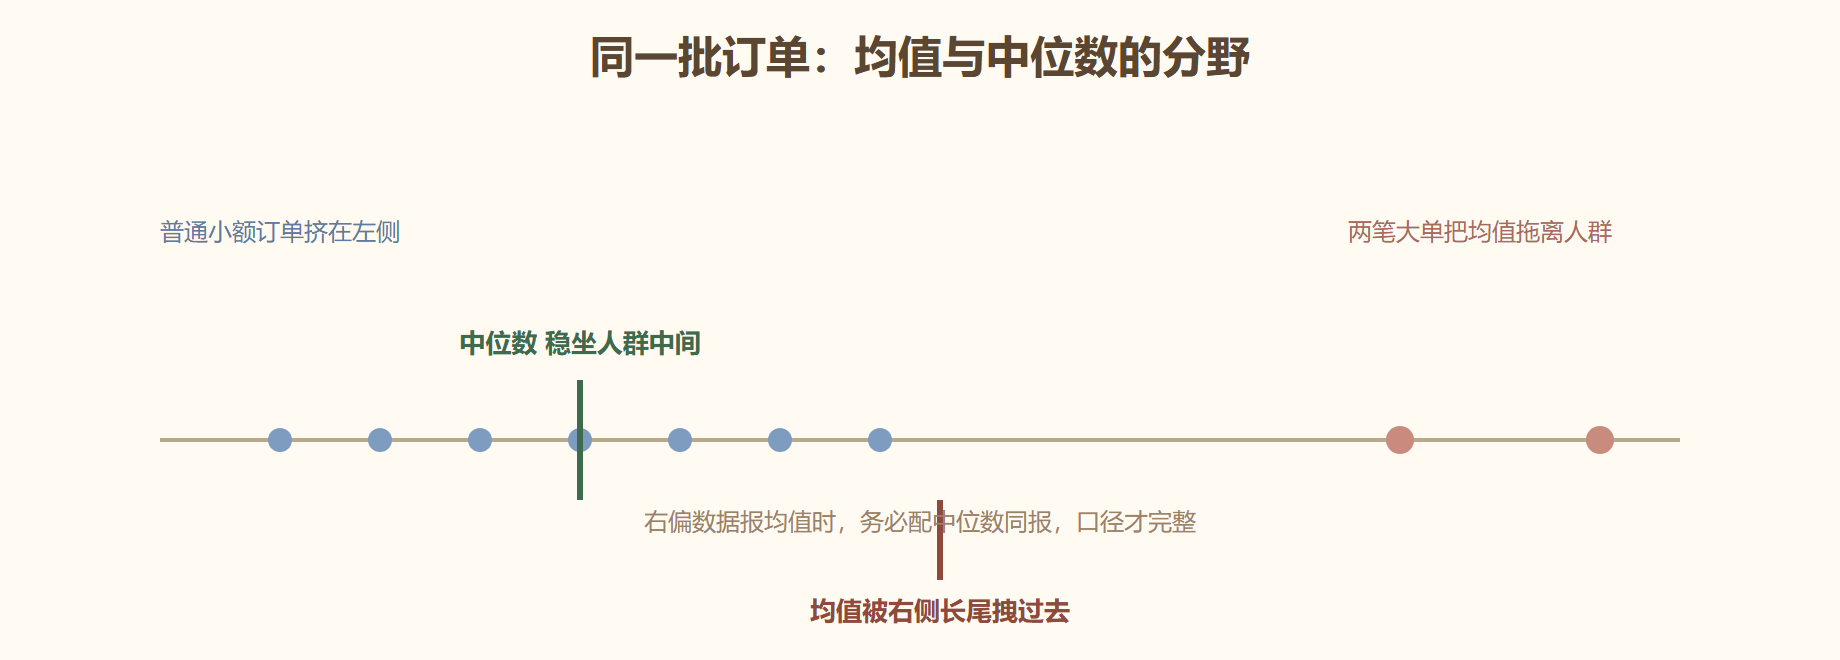
图 均值与中位数:谁被长尾拽走
参数拆解:旋钮逐个拧
**df.describe(percentiles=None, include=None, exclude=None)**:数值列默认给计数、均值、标准差、最小值、四分位与最大值;include="all" 把文本列也拉进来(此时给的是计数、唯一数、众数);percentiles 自定义分位列表。**s.mean(axis=None, skipna=True, numeric_only=False)** 与同族的 median、std、var、max、min:skipna 默认跳过缺失——这意味着"均值"其实是"非空样本的均值",口径要心里有数;std 与 var 有 ddof 参数,pandas 默认 ddof=1(样本口径,除以 n 减 1),NumPy 同名函数默认 ddof=0(总体口径),两库对数必查此项。**s.quantile(q)**:q 给 0.5 即中位数,给列表返回多个分位。**s.mode()**:众数,可能返回多个值——并列众数会全部返回,别假设它只有一个。
import pandas as pd import numpy as np s = pd.Series([56, 62, 48, 71, 55, 49, 6800, 58, 63, 52], name="金额") print(s.describe().round(1)) # count 10.0 # mean 741.4 <- 被 6800 拽飞 # std 2130.5 # min 48.0 # 50% 57.0 <- 中位数依然朴实 # max 6800.0 print(s.median()) # 57.0 print(s.std(), np.std(s)) # 口径差异:pandas 除以 n-1,numpy 除以 n
实操示例:分组描述统计的完整用法
场景:给 4.1 的渠道月报补一张"各渠道金额画像",看各组的分布形态而不只是均值。
df = pd.DataFrame({ "渠道": ["直营", "分销", "直营", "直播", "分销", "直播"], "金额": [120.0, 88.0, 260.0, 210.0, 95.0, 180.0], }) pic = df.groupby("渠道")["金额"].describe() print(pic[["count", "mean", "50%", "max"]]) # count mean 50% max # 渠道 # 直营 2.0 190.0 190.0 260.0 # 分销 2.0 91.5 91.5 95.0 # 直播 2.0 195.0 195.0 210.0 # 自定义分位:P90 常用于看头部 print(df["金额"].quantile([0.5, 0.9]).tolist()) # [150.0, 244.0]
mean 与 50% 两列一对照,分布偏不偏立见——直营组均值与中位数齐平,说明组内没有大单拉扯;如果均值远高于中位数,就该回头翻 2.2 的异常台账了。描述统计的真正用途,是给后续每一步处理提供"对不对劲"的参照。
相关与协整的一步速查
除单列画像外,describe 家族还有个"矩阵视角":df.corr() 一句话给出数值列两两的相关系数矩阵,df.cov() 给协方差。它们常用于建模前的粗筛——哪些列跟目标同向、哪些特征之间高度重复(高度相关的特征对往往留一个就够)。读矩阵时盯两点:绝对值看强弱,正负看方向;对角线恒为一,不用看。
num = pd.DataFrame({ "金额": [120, 88, 210, 95, 132], "数量": [3, 2, 5, 2, 4], "折扣": [0.9, 1.0, 0.8, 1.0, 0.85], }) print(num.corr().round(2))
相关矩阵同样会被异常值绑架——先做完 2.2 的异常处置再算相关,否则一笔大单能把相关系数拽到面目全非。本册到此为止,相关背后的显著性判断不展开,那是统计专册的事。
坑点与翻车
**翻车一:把 describe 的输出当最终报表。**默认只覆盖数值列,文本列被静默略过——include="all" 才是全家福;而文本列那几项(唯一数、众数)读法与数值列不同,混排一张表容易误读。**翻车二:ddof 口径对不上。**pandas 的 std 与 NumPy 的 std 默认口径不同,A 同学报的标准差与 B 同学的差那么一点,不是谁算错,是分母一个用 n、一个用 n 减 1。跨工具核对时,显式传 ddof 统一口径。**翻车三:全缺失列的均值是 NaN。**skipna 跳过所有缺失后无可计算,返回 NaN 而不是报错——上游字段改名的第二天,报表里那一栏悄然变空,就是这类静默 NaN 干的。**翻车四:对偏态数据只报均值。**2.2 的图已演示过均值如何被长尾绑架——金额、时长类指标,均值与中位数必须成对出现。
替代方案
偏态数据的稳健三件:median、quantile、IQR(2.2 的两把尺就是它们的应用);类别变量不走 describe,走 value_counts 与 nunique;分组画像除了 groupby 加 describe,还可以用 agg 挑几个关心的统计量(4.1 的命名聚合),输出更清爽。需要"截尾均值"这类抗极值统计时,scipy.stats 里也有现成函数,7.3 会路过。
收档清单
- describe 两面:数值列给六项,include="all" 才带上文本;
- skipna 默认开:均值是非空均值,口径要写明;
- ddof 双轨:pandas 默认样本口径,NumPy 默认总体口径,对数先统一;
- 偏态纪律:均值与中位数成对报,单报均值是半张嘴;
- 分组画像:groupby 加 describe 看分布,agg 命名聚合出定制版。
统计是"看整锅",下一节换小火慢煨:4.3 的累计与滚动窗口,让指标随时间边走边算。