5.1 数据合并与连接:concat 与 merge
5.1 数据合并与连接:concat 与 merge
本节摘要:多表合一有两路——concat 管拼接(不需要键,只对齐列),merge 管连接(按键对位,四种 how 定去留)。本节讲清两路的分工、行数校验的纪律,以及键重复导致的笛卡尔积爆炸。承接摆盘区的开篇,通往 5.2 的长宽变身。
两张报表为什么越拼越长
为什么把月报表拼进总表,行数凭空翻了一倍?多半是混用了两路手法:该摞表的活用了按键连接,或者按键时键列里藏着重复。合并的全部要领可以压缩成两问:这是"上下摞"还是"左右对位"?对位用的键干净吗?第一问决定用 concat 还是 merge,第二问决定结果能不能看。本节往前接摆盘区的键意识,往后把拼好的表交给 5.2 调整站姿。
适用场景:摞与对位
concat 管摞:两个月度明细上下接成季度明细(axis=0),或把两张同行的特征表左右并成一宽表(axis=1)。它不看内容,只对齐列名(或索引),所以列名一致是前提。**merge 管对位**:订单表按用户编号去用户表补姓名、按商品编号去商品表补类目——键是唯一的对位凭据,四种 how 决定两边行去留。摞与对位也常组合出现:先把各月明细摞成总表,再按键补齐维度信息。
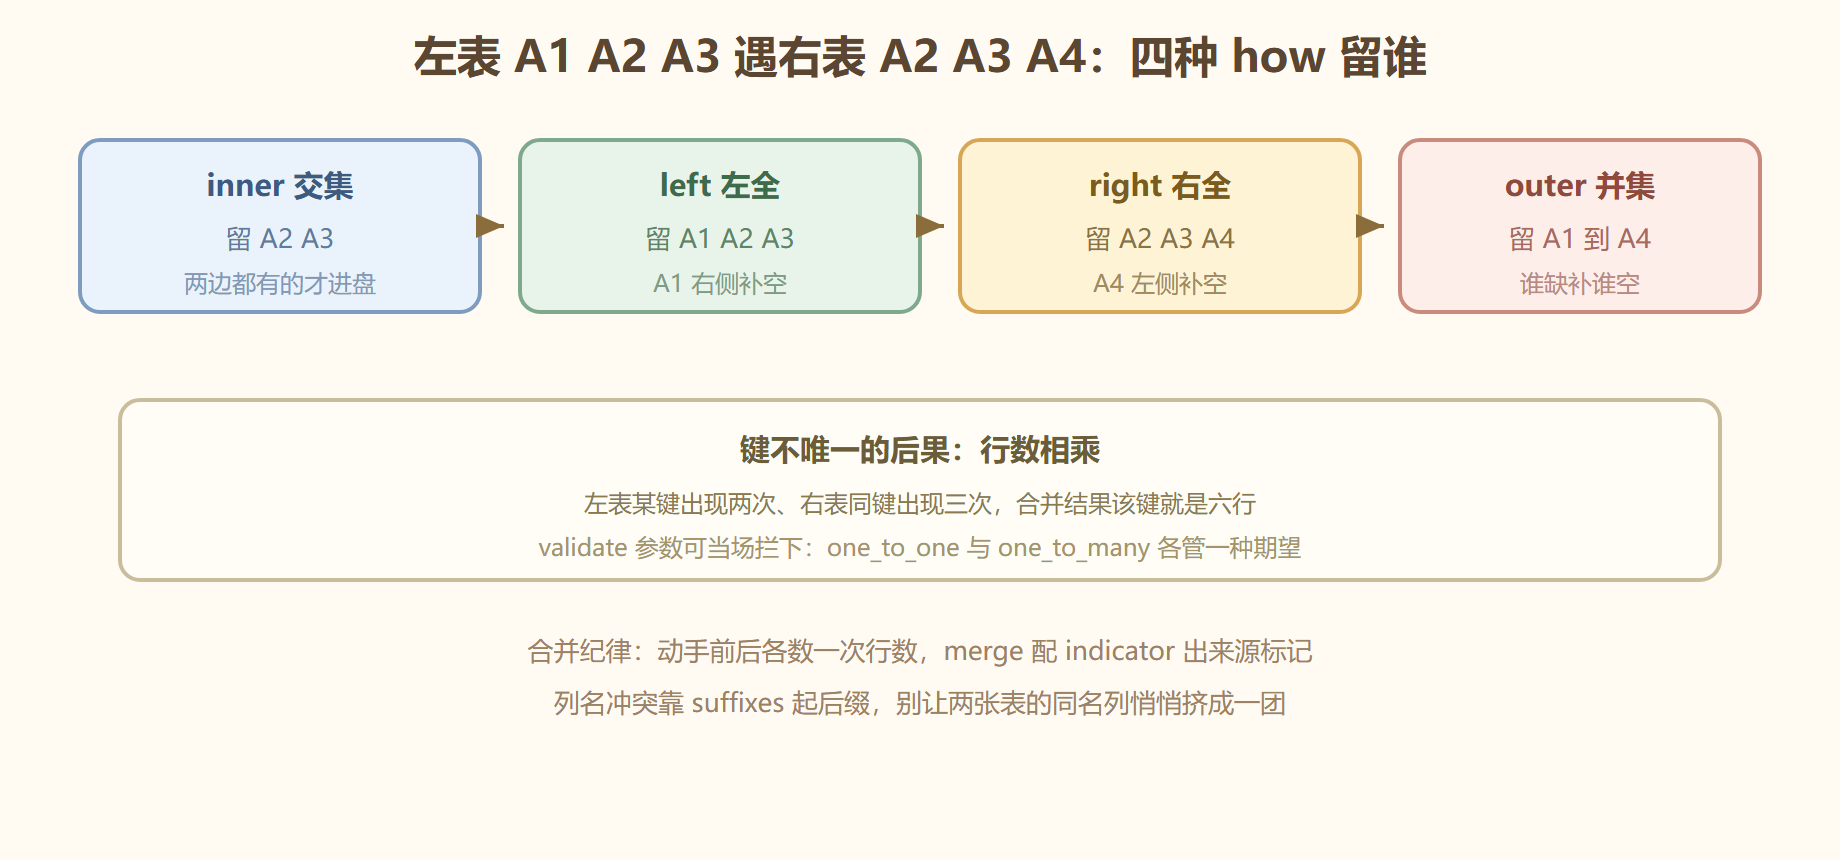
图 merge 四种 how 的对位结果
参数拆解:旋钮逐个拧
**pd.concat(objs, axis=0, join='outer', ignore_index=False)**:objs 传表列表;axis=0 纵向摞、axis=1 横向拼;join='inner' 只留交集列,'outer' 并集缺处补空;ignore_index=True 重排索引——纵向摞表必开,否则索引成串重复。**pd.merge(left, right, on=None, how='inner', suffixes=('_x', '_y'), validate=None)**:on 给键列名(两表列名不一致时用 left_on 与 right_on 各指各的);how 四选一;suffixes 给同名列起后缀;validate 填 'one_to_one' 或 'one_to_many',键不干净当场报错,是防爆炸的保险丝。**df.merge(right, ...)**:DataFrame 的方法版,链条式合并写着最顺。
import pandas as pd orders = pd.DataFrame({"单号": ["S1", "S2", "S3"], "客户": ["C1", "C2", "C1"]}) users = pd.DataFrame({"客户": ["C1", "C2", "C3"], "城市": ["上海", "北京", "广州"]}) # inner:只留两表都有的客户 print(orders.merge(users, on="客户", how="inner")) # 单号 客户 城市 # 0 S1 C1 上海 # 1 S2 C2 北京 # 2 S3 C1 上海 # left:订单全保留,没档案的客户补空 print(orders.merge(users, on="客户", how="left"))
实操示例:摞表加补维的完整摆盘
场景:五月、六月的流水分表,先摞成总表,再按键补渠道名,最后做行数校验。三步都是本章的手艺。
may = pd.DataFrame({"单号": ["M1", "M2"], "渠道号": ["Q1", "Q2"], "金额": [120.0, 88.0]}) jun = pd.DataFrame({"单号": ["J1"], "渠道号": ["Q1"], "金额": [210.0]}) ch = pd.DataFrame({"渠道号": ["Q1", "Q2"], "渠道名": ["直营", "分销"]}) # 第一步:摞表,索引重排 total = pd.concat([may, jun], ignore_index=True) before = len(total) # 第二步:按键补维度,保险丝上好 total = total.merge(ch, on="渠道号", how="left", validate="many_to_one") # 第三步:行数校验——many_to_one 不增行,前后必须相等 assert len(total) == before, "合并后行数变了,键有问题" print(total) # 单号 渠道号 金额 渠道名 # 0 M1 Q1 120.0 直营 # 1 M2 Q2 88.0 分销 # 2 J1 Q1 210.0 直营
合并前后的对账三连
合并的最终保险是一套固定的对账动作,写成三行惯性反射:合并前数左表与右表的行数与键的唯一数;合并后数结果行数,按 how 预期核对;用 indicator=True 的来源列看每一行的出身——left_only、right_only、both 各有多少,直接暴露键错位的规模。
m = orders.merge(users, on="客户", how="left", indicator=True) print(m["_merge"].value_counts()) # both 3 <- 全部对上了键 # left_only 0
left_only 出现非零,说明有订单没找到客户档案——是上游少数据还是键不规范,答案就在这三行对账里。
坑点与翻车
**翻车一:键里有重复,行数爆炸。**左表同键出现两次、右表出现三次,结果该键十二行起步——金额一加全错。防线上两条:合并前对维度表按键 drop_duplicates(回 2.3),合并时开 validate 当保险丝。**翻车二:concat 忘开 ignore_index。**纵向摞表后索引大量重复,.loc[2] 取出多行,后续按标签的赋值整片误伤。**翻车三:on 与 left_on 混着用。**两表键名不同还硬传 on,报错算走运;更糟的是恰好存在同名列,错键合并成功,数据彻底串味。**翻车四:how 的默认值悄悄生效。**merge 默认 inner,"少了几个客户"的流失往往就是它干的——维度补全一律显式 how='left',把意图写进代码。
替代方案
按键索引对齐的场合,df.join 默认按索引连接,写法更短;两表结构完全一致的小批量合并,df1.add(df2, fill_value=0) 一类算术合并也顺手;SQL 语感的团队可把 merge 直接读作 join——on 是 using,how 是 left join 语义,一一对应。合并之后的字段挑选与改名,配 3.1 的 loc 一步到位。
收档清单
- 两路分工:concat 管摞只对列,merge 管对位靠键;
- 四种 how:inner 留交集、left 保左表、right 保右表、outer 全都要;
- 防爆炸三件:键先去重、validate 保险丝、前后点行数;
- 参数显式:how 别依赖默认值,ignore_index 记得开;
- 来源可查:indicator=True 出 merge 来源列,对账利器。
拼好的表还得调站姿:5.2 用 pivot 与 melt 在长宽两态之间自由变身。