5.2 长宽表重塑:pivot、melt 与 stack
5.2 长宽表重塑:pivot、melt 与 stack
本节摘要:同一份数据有两种站姿——行式长表利于存储与聚合,列式宽表利于阅读与展示。本节讲 pivot 与 melt 的双向变身、stack 与 unstack 的层级交换,以及"索引重复"这个最高频报错的来龙去脉。承接 5.1 的多表合一,通往 5.3 的汇总报表。
某次汇报会上的站姿之争
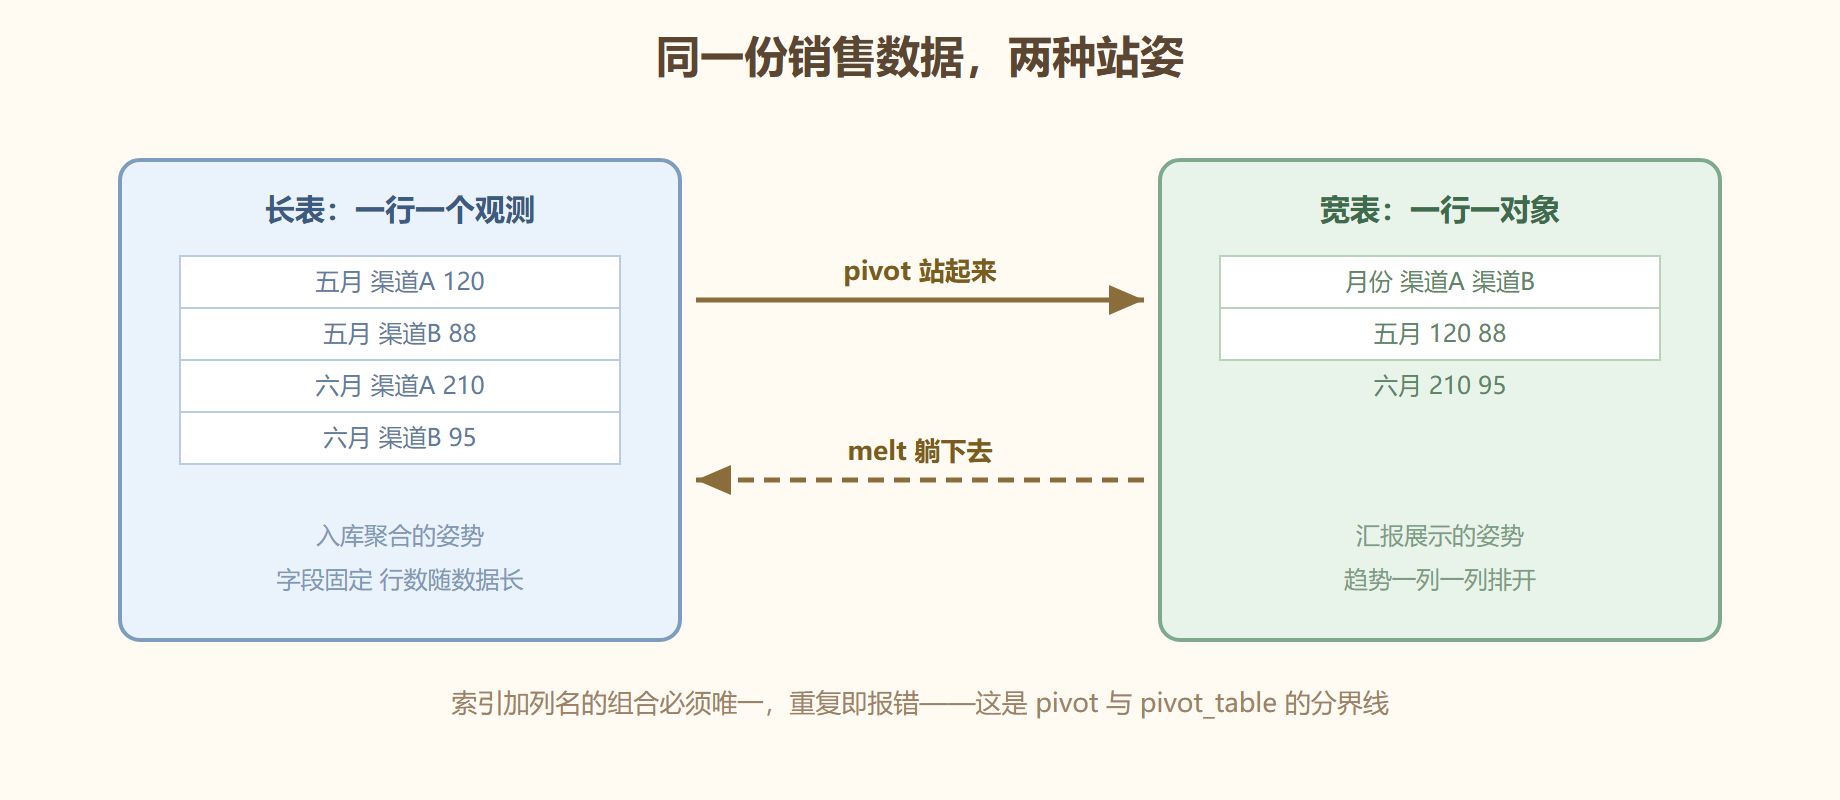
某次汇报会上,业务方看着投影皱眉:"我要每个月一列的表,你这流水怎么每个月一行?"——数据没变,站姿不合口味。分析系统喜欢长表:一行一条记录,字段少、好入库、好聚合;人眼喜欢宽表:一行一个对象、一列一个月份,一眼看尽趋势。两种站姿没有对错,只有场合。本节就是站姿变换器:pivot 把长站成宽,melt 把宽躺成长,stack 与 unstack 则在最内层做同样的交换。往前接 5.1 拼好的表,往后 5.3 的汇总报表正是"聚合加变身"的合体。
图 长表与宽表的互变
参数拆解:旋钮逐个拧
df.pivot(index, columns, values):三参数各司其职——index 留在行上、columns 摊成列、values 填进格子;它只重排不计算,索引加列名的组合重复了就抛异常。pd.melt(df, id_vars, value_vars, var_name, value_name):反向操作,id_vars 是"钉在行上的标识列",value_vars 是"要躺倒的数值列";var_name 与 value_name 给新生成的两列起名,不起就默认叫 variable 与 value。df.stack() 与 df.unstack():在多层索引上做同样的交换——stack 把最内层列压进行索引(宽转长),unstack 把最内层行索引抬回列(长转宽);level 参数可选交换哪一层。
import numpy as np import pandas as pd long_df = pd.DataFrame({ "月份": ["五月", "五月", "六月", "六月"], "渠道": ["A", "B", "A", "B"], "金额": [120.0, 88.0, 210.0, 95.0], }) # 长转宽 wide = long_df.pivot(index="月份", columns="渠道", values="金额") print(wide) # 渠道 A B # 月份 # 五月 120.0 88.0 # 六月 210.0 95.0 # 宽转长:melt 把 A、B 两列躺倒 back = pd.melt(wide.reset_index(), id_vars=["月份"], value_vars=["A", "B"], var_name="渠道", value_name="金额") print(back.sort_values(["月份", "渠道"]).to_string(index=False))
实操示例:从流水到对比表
场景:渠道月报要"月份为行、渠道为列"的对比表,顺带把缺失渠道显示为短横线而不是空白。
# 加一点缺失:六月没有 C 渠道数据 long_df2 = pd.concat([long_df, pd.DataFrame({"月份": ["六月"], "渠道": ["C"], "金额": [np.nan]})], ignore_index=True) wide2 = long_df2.pivot(index="月份", columns="渠道", values="金额") print(wide2.fillna("-")) # 渠道 A B C # 月份 # 五月 120.0 88.0 - # 六月 210.0 95.0 -
如果六月凑巧有两条 C 渠道记录,pivot 会当场抛"索引含重复条目"——这不是事故,是它在提醒你:重排之前该先聚合。这时换 5.3 的 pivot_table,报错位置变成聚合动作,问题自然消解。
多层索引的两步走
当分组键超过两个,unstack 出的表自带多层结构,这时"一次摊平"往往不是最优解。惯用节奏分两步:先 unstack 看最内层的展开效果,确认无误后再决定要不要 reset_index 摊平或者保留多层。多层索引的显示虽然起初劝退,但它让"渠道下分品类、品类下分规格"的层级报表有了自然载体——5.3 的 pivot_table 也走同一套索引体系,学一次两边通用。
multi = df.groupby(["月份", "渠道"])["金额"].sum() wide = multi.unstack(fill_value=0) # 第一步:内层变列 flat = wide.reset_index() # 第二步:确认后摊平 print(flat)
坑点与翻车
**翻车一:pivot 遇重复组合。**同月同渠道有两条记录,pivot 直接 ValueError。记住因果:pivot 是"搬运工"不是"记账员",带重复就要先 groupby 聚合或改用 pivot_table。**翻车二:melt 忘写 id_vars。**不指定标识列,melt 会把所有列都躺倒,标识信息混进 value 里,出来一张无法使用的表——先用 id_vars 钉住谁不动,再谈谁躺下。**翻车三:stack 之后 NaN 凭空出现。**unstack 展开时,行与列组合不全的位置自动补 NaN(宽表里的空洞),stack 回去可能比原表更长——这些 NaN 是"组合缺失"的记录,不是误差,处理办法回看 2.1。**翻车四:多层索引下 unstack 拿错层。**默认只动最内层,想动别的层要显式传 level;调多层重塑时,print 一次 index 看清层级再动手,比盲试快得多。
替代方案
聚合与变身一步到位的需求,pivot_table 与 crosstab 是打包好的合体工具(5.3 展开);多层索引的组内展开,groupby 加 unstack 常比 pivot 更顺手——聚合口径自己定义,展开只是最后一步;多列变长的复杂场景还有 pd.wide_to_long 这门专用工具;而只是想把汇总结果"摆好看",styler 与导出工具的事就别让重塑函数代劳。
收档清单
- 两种站姿:长表利存储聚合,宽表利阅读展示,场合定形态;
- pivot 三参:index 留行、columns 摊列、values 填格,只搬不算;
- melt 四参:id_vars 钉住标识,value_vars 指定躺倒,两列记得起名;
- 重复即报错:pivot 的报错是善意提醒,带重复改用 pivot_table;
- 层级交换:stack 压列进行,unstack 抬行进列,默认只动最内层。
变身的终点是出报表:5.3 用 pivot_table 与 crosstab,把"聚合加变身"一次打包端出。