3.3 字符串操作:str 访问器手法集
3.3 字符串操作:str 访问器手法集
本节摘要:地址、邮箱、备注、单号——文本是表格里最"散"的料。str 访问器把 Python 的字符串功夫平移到整列上:拆分、提取、替换、判断、补位,本节按"流水线"次序讲全常用手法,并给正则开关立好规矩。承接 3.2 的排序,通往 3.4 的时间解析。
从纸质地址簿到结构化字段
从纸质地址簿到数据库字段,人类整理文本花了上百年;数据表里的文本至今仍然最不听话——"北京市 朝阳区 望京街道"与"朝阳区望京"指同一处却长得不一样;邮箱里藏着姓名与域名;单号里编着仓库与批次。字符串处理的日常,就是把这类散料切成结构化的列。本节的手法都挂在 str 访问器下面:对任何一列字符串写 s.str.方法名(),Python 字符串的功夫就能整列施展。往前接 3.2 排好序的表,往后 3.4 的时间列,常常正是字符串里"切"出来的。
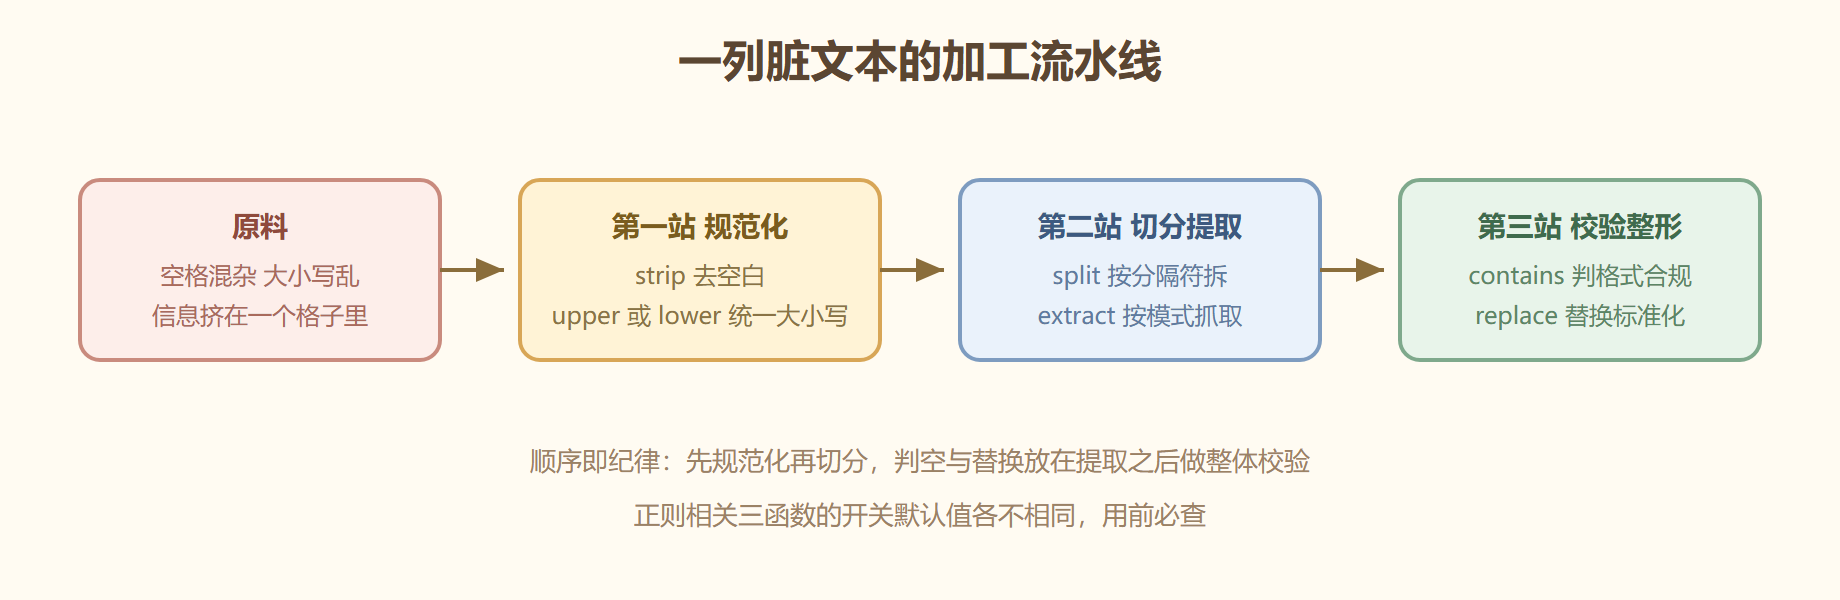
图 文本加工流水线
参数拆解:旋钮逐个拧
**s.str.split(pat, n=-1, expand=False, regex=None)**:按分隔符拆,expand=True 拆成多列(最有用的形态),n 限制拆的刀数;正则开关以实际版本文档为准。**s.str.extract(pat, expand=True)**:按正则分组抓取,一组一列——圆括号就是抓取范围,命名分组还顺手命名列。**s.str.contains(pat, case=True, na=False, regex=True)**:判断是否包含,返回布尔列;na 参数决定原缺失位置的返回值,筛选时给 False 避免空值捣乱;regex 默认 True。**s.str.replace(pat, repl, regex=False)**:pandas 里这个函数默认按字面替换,要正则必须显式 regex=True——与 Python 原生 str.replace 的心智完全一致,但与 6.2 的 re.sub 味道不同。**s.str.len()、upper()、lower()、strip()、zfill(宽度)、slice(起, 止)**:计量、统一、清洁、补零、裁片,都是单列直来直去的手法。
import pandas as pd s = pd.Series([" Alice@mail.com ", "bob@corp.cn", None, "CARL@mail.com"], name="邮箱") # 第一站:规范化 s1 = s.str.strip().str.lower() # 第二站:切分——expand 拆成两列 parts = s1.str.split("@", expand=True) parts.columns = ["用户名", "域名"] print(parts) # 用户名 域名 # 0 alice mail.com # 1 bob corp.cn # 2 NaN NaN <- 缺失一路传染,符合预期 # 3 carl mail.com
实操示例:从单号里拆出仓库与批次
场景:单号形如"WH03-B2024-0057",前段是仓库码,中段含年份,尾段是流水号。用 extract 一把抓出三列。
orders = pd.Series(["WH03-B2024-0057", "WH12-B2023-1108", "bad-format"]) info = orders.str.extract(r"(WH\d{2})-B(\d{4})-(\d{4})") info.columns = ["仓库码", "年份", "流水号"] print(info) # 仓库码 年份 流水号 # 0 WH03 2024 0057 # 1 WH12 2023 1108 # 2 NaN NaN NaN <- 不合式的抓不到,交 2.4 的 coerce 思路处理 # 校验:合规率一句话出 print(f"合规率:{info['仓库码'].notna().mean():.0%}")
extract 的返回值对不上的行是 NaN——"抓不到"本身就是一种检测结果,这个性质让 extract 兼职当了格式校验员。
常用手法速查
str 访问器下的方法几十个,日常高频的其实就一掌之数:split 与 extract 管拆,replace 管换,contains、startswith、endswith 管判,len、strip、upper、lower、zfill 管整,slice、str[起止] 管裁。记不全没关系,记一条检索规律——凡是"对每个字符串做的事",Python 字符串有什么方法,s.str 下面九成有同名的,整列自动铺开。拿邮箱演示一遍"判、拆、裁"三连:
emails = pd.Series(["alice@mail.com", "bob@corp.cn", None]) print(emails.str.endswith(".com")) # 判后缀:True False NaN print(emails.str.slice(0, 5).tolist()) # 裁前五位:alice、bob@、NaN
缺身的行照旧透传 NaN——速查表再熟,也替代不了对缺失去向的清醒。
坑点与翻车
**翻车一:contains 的正则默认开着。**s.str.contains("(待定)") 里的小括号被当成分组语法,匹配结果和直觉完全两样。想按字面找特殊字符,要么转义,要么 regex=False。**翻车二:把 Python 的 replace 经验直接搬来。**s.str.replace("a.b", "X") 默认按字面替换——这与多数人"点号匹配任意字符"的预期相反,方向和 contains 恰好一个默认开、一个默认关。两个开关各记各的,拿不准就显式写。**翻车三:缺失值传染。**str 系方法遇到 NaN 一律返回 NaN,链式调用中间任何一环有缺失,后面的环节全空——长链加工前先想清楚缺失该在哪一环处理,或提前 fillna。**翻车四:对非字符串列点 str。**数字列点 str 访问器直接抛异常——先 astype(str) 或回头做 2.4 的类型矫正,这是切配台与择菜间的接力处。
替代方案
复杂逻辑超出正则表达能力时,用 apply 挂自定义函数最灵活(代价是慢,第 8 章细算这笔账);需要"一段文本里的全部匹配"而不是首匹配,用 extractall;要"整列拼接"用 str.cat(sep="、")。至于带分组命名的正则,(?P<列名>模式) 能让 extract 直接产出带名字的列,省掉事后改列名。
本节要点回顾
- 访问器统一入口:s.str.方法(),Python 字符串功夫整列施展;
- 拆与抓:split(expand=True) 按分隔符出列,extract 按分组捕获出列;
- 开关双例:contains 默认正则开,replace 默认正则关,方向相反;
- 缺失传染:str 链路里 NaN 一路透传,长链先定缺失策略;
- 兼职校验:extract 抓不到即 NaN,天然能查格式合规率。
文本切好了,还剩最难缠的软料——时间。3.4 用 to_datetime 与 dt 访问器,把时间从字符串里解放出来。