3.4 日期时间操作:to_datetime 与 dt 访问器
3.4 日期时间操作:to_datetime 与 dt 访问器
本节摘要:时间是数据里最讲规矩的料——转不成时间类型,月报做不了、留存算不出。本节讲透 to_datetime 的入料与 dt 访问器的拆解:抽年月日、算星期、生成时间轴、按月归拢,并把月末、时区、格式符三处高频翻车点提前拆掉。承接 3.3 的字符串精加工,为切配台收官。
月底结算为什么总在时间列上翻车
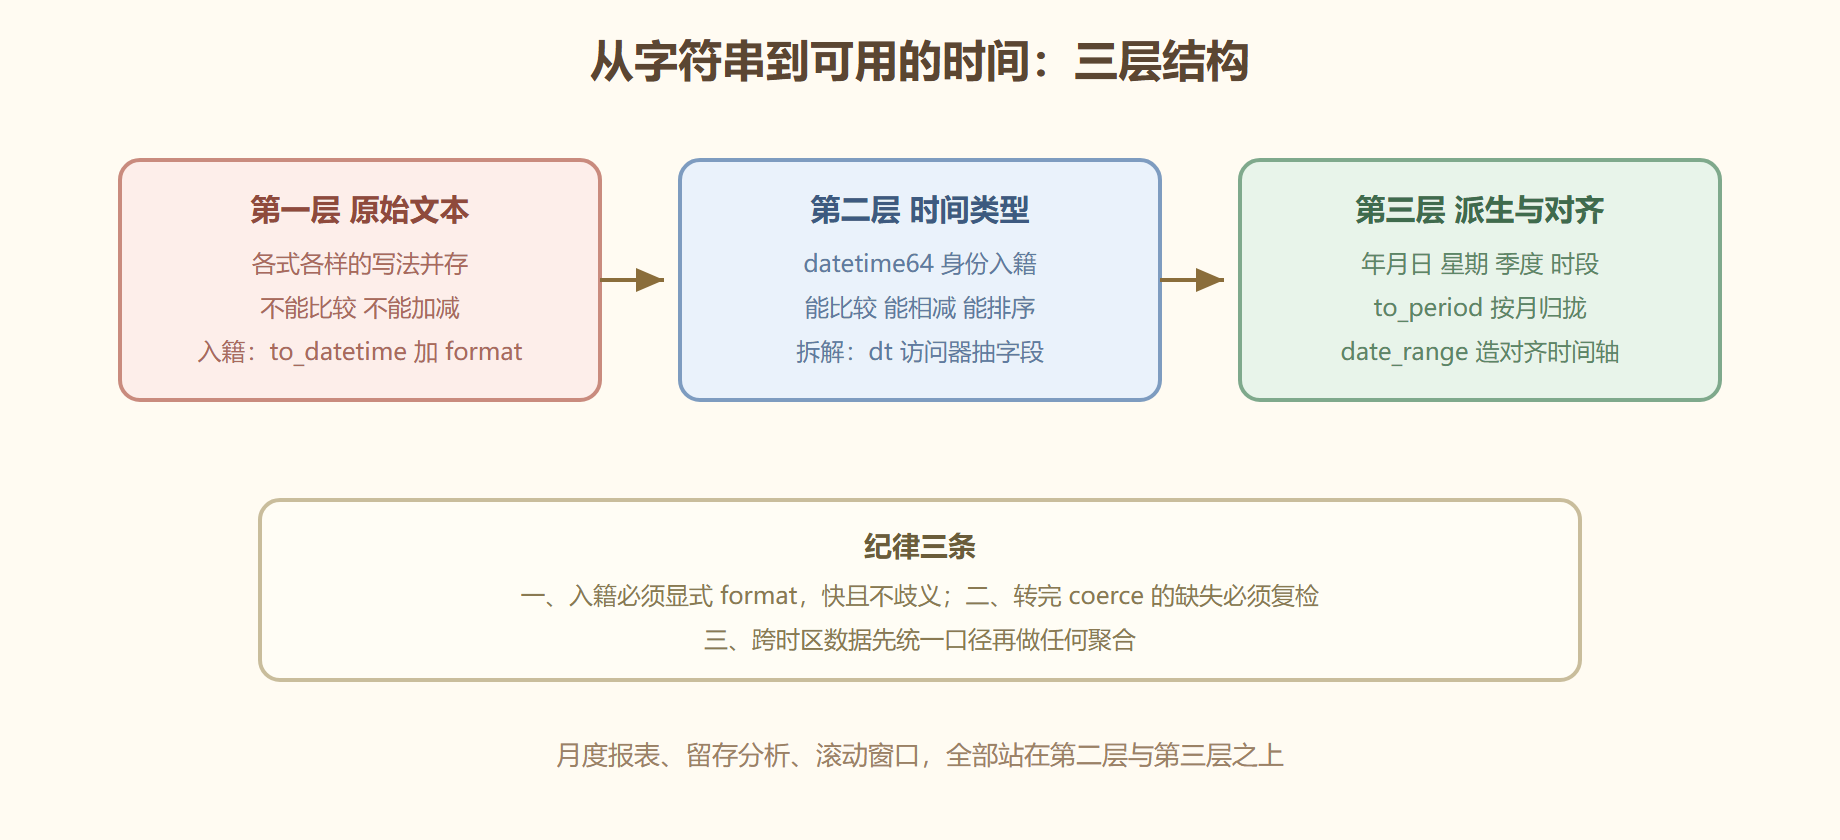
月底赶结算报表,出事最多的偏偏是时间列:日期格式五花八门,"05/06/2024"到底六月还是五月没人说得清;算"隔了多少天"拿字符串做减法,当场报错;按月汇总时,同一月份被拆成好几行。根源都一样——时间还躺在文本里,没有获得时间类型的身份。本节的任务是把这个身份问题一次解决:to_datetime 负责入籍,dt 访问器负责拆解使用,date_range 负责造时间轴。往前接 3.3 的文本手法(时间多半从文本里来),往后 4.3 的滚动窗口要靠它排队进场。
图 时间数据的解析与使用层次
参数拆解:旋钮逐个拧
pd.to_datetime(s, format, errors, unit, origin):2.4 已立过规矩——format 显式给、errors 用 coerce 转完复检;这里补一把刀:unit 与 origin 专治数字型时间(Unix 时间戳与 Excel 序列日)。dt 访问器:s.dt.year、month、day、hour 取字段;s.dt.dayofweek 给星期(零代表周一);s.dt.quarter 给季度;s.dt.strftime("%Y年%m月") 直接格式化成展示文本。s.diff():相邻两行相减,时间列上得到时长差,留存与间隔分析的起点。pd.date_range(start, end, periods, freq):造时间轴,freq 常用取值——'D' 按天、'W' 按周、'ME' 按月末、'MS' 按月初、'h' 按小时;pandas 新版本用 'ME' 表示月末(旧的 'M' 写法已逐步移交 Period 语义)。s.dt.to_period('M'):把时刻归拢成月份周期,是月度聚合的前置步骤。
import pandas as pd s = pd.Series(["2024-05-01 09:30", "2024-05-03 14:00", "2024-05-08 20:15"]) t = pd.to_datetime(s, format="%Y-%m-%d %H:%M") print(t.dt.dayofweek.tolist()) # [2, 4, 2] <- 0 是周一,2 即周三 print(t.diff().dt.days.tolist()) # [nan, 2.0, 5.0] 相邻间隔天数
实操示例:月度汇总的完整链路
场景:一张订单流水,要求按月统计单量。链路固定:入籍、归拢、聚合(聚合本身在 4.1 展开,这里先走到归拢)。
df = pd.DataFrame({ "下单时间": ["2024-04-28 21:10", "2024-05-02 10:00", "2024-05-31 23:45", "2024-06-01 00:05"], "金额": [199.0, 259.0, 88.0, 129.0], }) # 入籍:显式格式 df["下单时间"] = pd.to_datetime(df["下单时间"], format="%Y-%m-%d %H:%M") # 归拢:时刻变月份周期 df["月份"] = df["下单时间"].dt.to_period("M").astype(str) # 展示:也可以直接格式化成中文年月 df["月份标签"] = df["下单时间"].dt.strftime("%Y年%m月") print(df[["月份", "月份标签"]]) # 月份 月份标签 # 0 2024-04 2024年04月 # 1 2024-05 2024年05月 # 2 2024-05 2024年05月 # 3 2024-06 2024年06月
注意月末那笔 23:45 的单子归在五月、次日 00:05 的单子归在六月——跨月边界全靠时间类型的比较语义,字符串永远做不到这么稳。
时段与频率的两组常用件
月报之外还有两件高频活。时段切分:把"几点几分"归入早中晚班,用 dt.hour 配 4.4 的 np.select 即可,时段字段是运营报表最常用的维度之一。频率对齐:date_range 的 freq 除了按天按月,还有按工作日('B' 跳过周末)、按小时('h')与按分钟——造轴之后用 reindex 把稀疏的流水对齐到完整时间轴,缺口一目了然,这是时间序列预处理的标准动作。
axis = pd.date_range("2024-05-01", "2024-05-07", freq="D") flow = pd.Series([12.0, 9.0, np.nan, 30.0], index=axis[[0, 1, 3, 4]]) print(flow.reindex(axis)) # 缺的那几天自动补 NaN,缺口多大一目了然
对齐出的 NaN 不是误差,是"没有发生"的记录——要不要补零、插值还是留空,回 2.1 的处置决策按业务定。
坑点与翻车
**翻车一:对 object 列点 dt。**dt 访问器只认时间类型,文本列直接报错——先 to_datetime,这也是 3.3 与本节的接口。**翻车二:星期从零还是从一。**pandas 的 dayofweek 以零代表周一;numpy 与部分语言的惯例不同,跨库对数时先对口径。翻车三:加月份想用天数凑。"下个月今天"不能用 Timedelta(days=30) 硬凑——大小月天数不同,三个月后准错位;加月份要用 DateOffset(months=1) 或干脆用 Period 的加减。**翻车四:格式符大小写。**%Y 是四位年份,%y 是两位;%M 是分钟、%m 才是月份——大小写错一位,解析出的日期面目全非,这就是坚持显式 format 后还要"抽查一行结果"的原因。
替代方案
不需要"时刻"只需要"月份"时,直接用 pd.PeriodIndex 或读入时 converters 转 Period,省一层转换;只要工作日的时间轴,用 bdate_range 一步跳过周末;处理带时区的时间戳,tz_localize 与 tz_convert 两步走——先给本地时区、再转到目标时区,顺序反了会对错小时。跨库交换数据时,ISO 标准格式的字符串是最稳的通用语。
收档清单
- 入籍第一:to_datetime 加显式 format,是所有时间操作的前提;
- dt 拆解:字段抽取、星期口径零为周一、strftime 出展示文本;
- diff 量间隔:相邻相减得时长,留存分析的起点;
- 加月份:用 DateOffset 或 Period,别拿天数凑;
- 时间轴:date_range 造轴,freq 认清月初月末写法。
切配台四把刀到此交齐。下一章进汤锅区:分组、聚合、统计与窗口,把切好的料真正下锅熬味——先见 4.1 的 groupby。