4.4 条件计算:np.where、np.select 与 clip
4.4 条件计算:np.where、np.select 与 clip
本节摘要:按条件变值是汤锅的最后一道调味——达标打标、分层定价、越界截断。本节讲 np.where 的两分支、np.select 的多分支、df.where 与 mask 的保留式写法,以及 clip 与 2.2 截尾的呼应,并给"分支方向相反"这个经典陷阱立牌。承接 4.3 的滚动列,汤锅区在此收官。
别急着写循环套判断
别急着把"逐行检查再加标记"写成 for 加 if 的三层嵌套——那是在向量化的后厨里生火做饭。条件计算的每一种需求,都有现成的整列手法:两分支用 np.where,多分支用 np.select,"保留满足的、替换不满足的"用 df.where,越界压界用 clip。本节往前接 4.3 滚出来的数值列——达不达标正是在滚动列上判定;往后,第 5 章摆盘时的数据校验,也要靠这些手法打标。
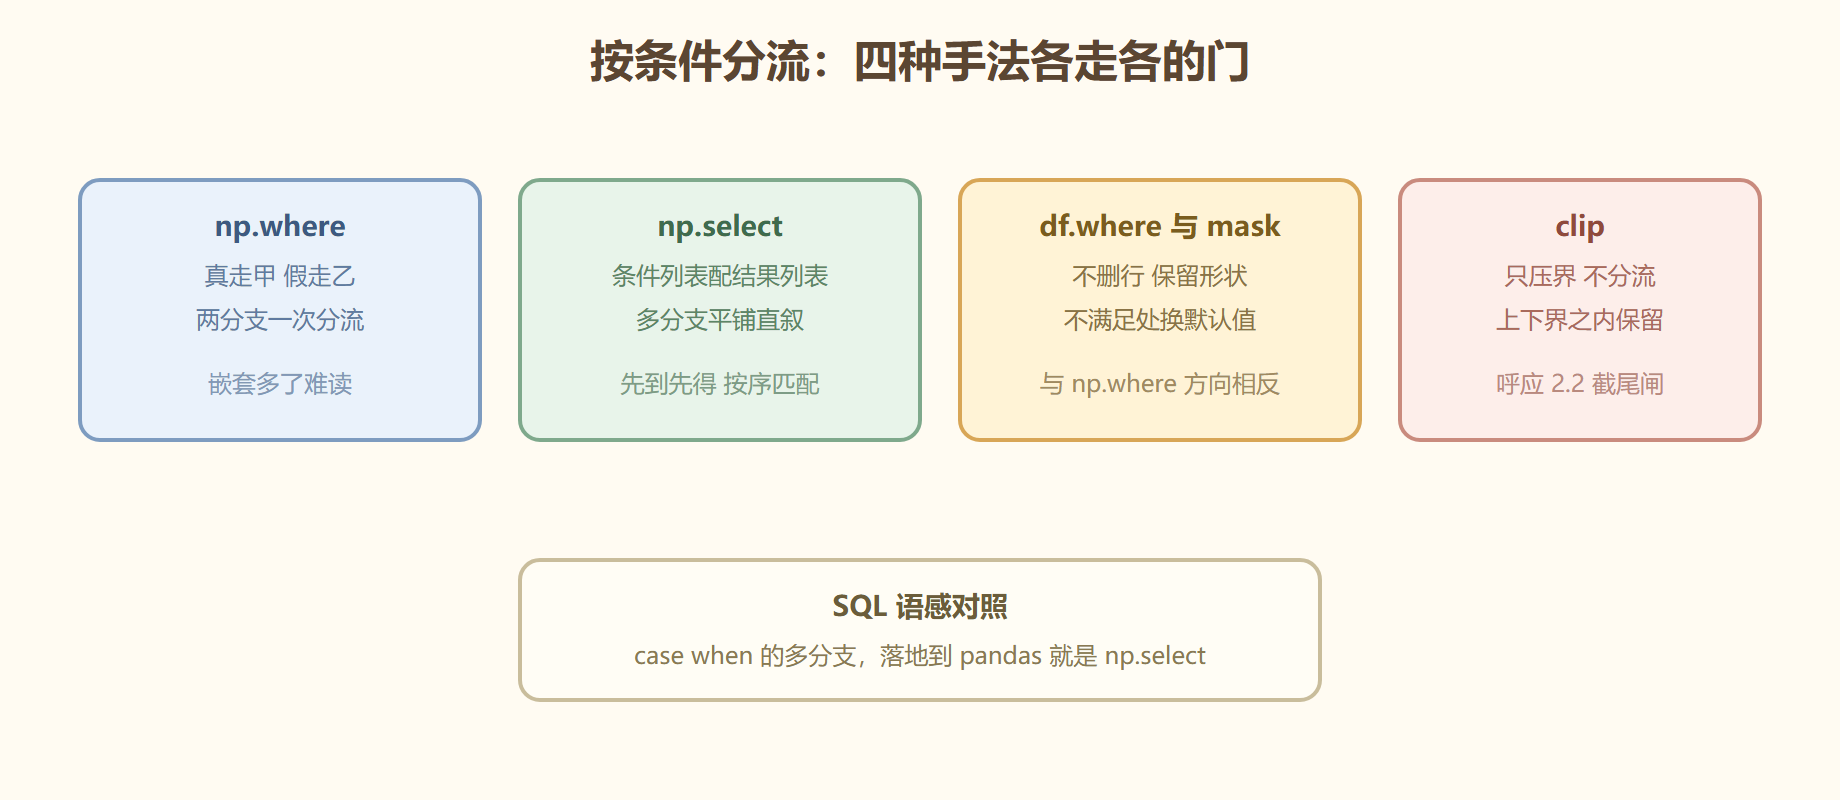
图 条件分流的四种路径
参数拆解:旋钮逐个拧
np.where(cond, x, y):cond 为真取 x、为假取 y,x 与 y 可以是标量也可以是同形数组;只传 cond 时返回满足位置的坐标元组,那是另一个用途,别混。np.select(condlist, choicelist, default=0):condlist 是条件列表,choicelist 是对应的结果列表,从上到下先到先得,全不中走 default——两个列表长度必须对齐。df.where(cond, other):语义是"条件为真的位置保留原值,为假的位置换成 other",注意这与 np.where 的"为真取 x"方向相反,是全节最大的坑。df.mask(cond, other):与 where 互补——"条件为真的位置换成 other"。s.clip(lower, upper):越界压回边界,就是 2.2 那道截尾闸的函数本体。
import pandas as pd import numpy as np df = pd.DataFrame({"商品": ["甲", "乙", "丙", "丁"], "库存": [5, 40, 120, 8]}) # 两分支:np.where df["补货"] = np.where(df["库存"] < 10, "要补", "不用") # 多分支:np.select,先到先得 conds = [df["库存"] < 10, df["库存"] < 50, df["库存"] < 100] df["水位"] = np.select(conds, ["告急", "健康", "偏高"], default="积压") print(df) # 商品 库存 补货 水位 # 0 甲 5 要补 告急 # 1 乙 40 不用 健康 # 2 丙 120 不用 积压 # 3 丁 8 要补 告急
实操示例:达标线与分层定价
场景:给 4.3 的销量表加一列"是否达标"(滚动均值过二十算达标),再按金额区间定价。两步都是条件计算的典型活。
df = pd.DataFrame({ "销量": [12, 25, 18, 30, 8], "金额": [99.0, 259.0, 88.0, 320.0, 45.0], }) # 达标判定:条件为真取"达标",否则"待改进" df["状态"] = np.where(df["销量"] > 20, "达标", "待改进") # 分层定价:区间多分支 conds = [df["金额"] < 100, df["金额"] < 200, df["金额"] < 300] prices = ["低价", "中价", "高价"] df["档位"] = np.select(conds, prices, default="豪华档") # 保留式:只留达标的销量,其余变空——where 方向提醒 df["达标销量"] = df["销量"].where(df["销量"] > 20) print(df[["销量", "状态", "档位", "达标销量"]]) # 销量 状态 档位 达标销量 # 0 12 待改进 低价 NaN # 1 25 达标 高价 25.0
条件计算的组合套路
实战里的条件往往不是单层:先按条件分流、再在分支内二次判定。套路是把 4.4 的三件当积木叠:np.select 出档位、布尔面具筛子集、clip 压边界,三层各管一段。以会员权益为例——按消费分档,档内再按活跃天数给加成,最后把极端值压回权益上限:
df["档位"] = np.select([df["金额"] > 300, df["金额"] > 100], ["金卡", "银卡"], default="普卡") 加成 = np.where(df["销量"] > 20, 1.2, 1.0) df["权益"] = np.select([df["档位"] == "金卡", df["档位"] == "银卡"], [200, 100], default=50) * 加成 print(df["权益"].clip(upper=240).tolist())
读这段代码的顺序就是执行的顺序:档位是行分支,加成是列系数,clip 是收口——每一层都可以单独验数,比一个五层嵌套的 if 好查得多。
坑点与翻车
**翻车一:where 的方向记反。**想"把不达标的改成零"却写成 df["销量"].where(df["销量"] > 20, 0)——where 是"为真保留原值",所以这条恰好是对的;但换 np.where 思维写成"为真取 0"就全反了。两套函数方向相反,写完拿一行数据验一次,成本远低于排查半小时。**翻车二:select 的条件顺序随意。**np.select 先到先得,条件列表必须从严到宽排——若把"库存小于 100"放在"小于 10"前面,告急档永远轮不到出场。**翻车三:mask 原表误伤。**df.mask(...) 返回新表,但配上 inplace=True 或把结果赋回同名变量,原数据就"被整容"了;管道式写法里,每一步的返回值去向要清楚。**翻车四:np.where 里再套 np.where。**三层嵌套还能读,五层就是灾难——多分支请交给 np.select,条件与结果各占一列,肉眼可审。
替代方案
枚举值映射(如渠道编码转中文名)不必动用条件计算,map 配字典更直接(6.1 展开);连续区间的分层,2.5 的 pd.cut 比手写条件列表更规范,边界与标签一目了然;SQL 语感的团队写 case when 再落地成 np.select,语义一一对应;而需要按条件"整行剔除"时,那不是条件计算的活——回 3.1 用布尔面具筛。
收档清单
- 两分支:np.where 三参数,真取 x 假取 y;
- 多分支:np.select 条件与结果成对,先到先得,从严到宽排;
- 方向相反:df.where 为真保留、mask 为真替换,与 np.where 语义相逆;
- clip 压界:不分流只截断,2.2 截尾闸的函数本体;
- 枚举映射:字典配 map,比条件计算更轻。
汤锅区四道菜到此齐了。下一章摆盘:多锅菜怎么合成一桌席——合并、连接与重塑,见 5.1。