4.3 累计与滚动窗口:cumsum 与 rolling
4.3 累计与滚动窗口:cumsum 与 rolling
本节摘要:有些指标不是"一眼看全锅",而是"边走边算"——累计到当前是多少,最近一段窗口内是多少。本节讲透 cumsum 家族的累计手法与 rolling 滚动窗口的参数联动,顺带交代 expanding 与 ewm 两味延伸汤料。承接 4.2 的整锅统计,通往 4.4 的条件计算。
「rolling」这口锅跟别的锅差在哪
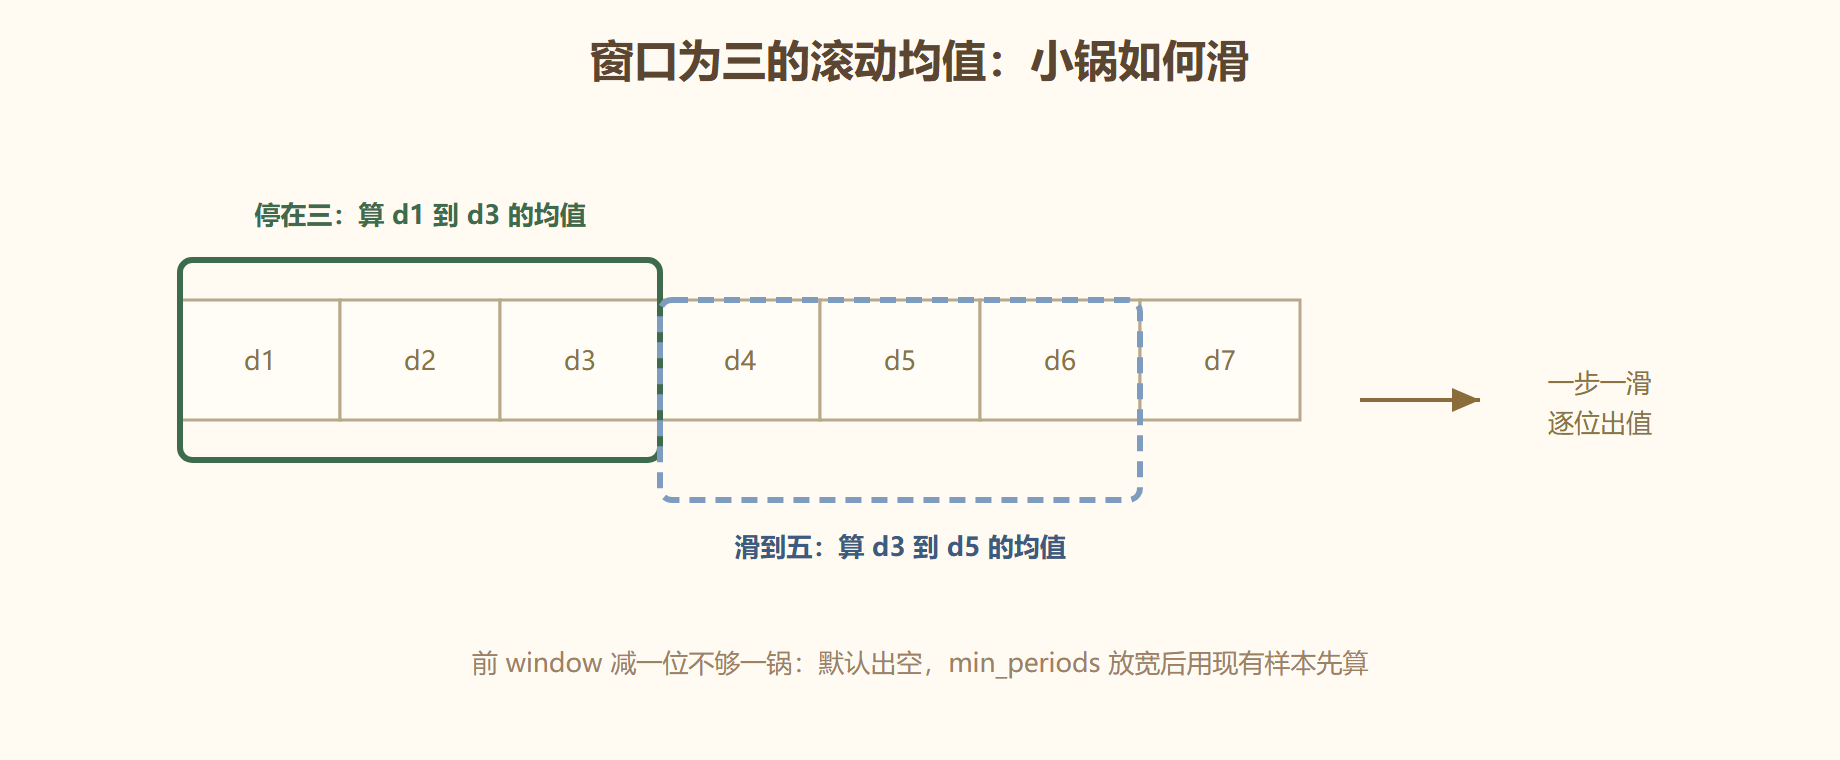
「rolling」,滚动窗口——它跟 4.2 那口"全表一锅出"的锅根本不同:4.2 把所有料倒进锅里算一个数,rolling 则端着一口小锅沿数据滑过去,每停一步就用锅里最近那几行算一个数。日报里的"近七天滚动销售额"、监控里的"滑动平均延迟"、复盘里的"年内累计成交",全是这口小锅的产物。本节往前接 4.2 的统计量——滚动算的正是它们;往后 4.4 的条件计算,常在滚动列上再画一道达标线。
图 滚动窗口的滑动方式
参数拆解:旋钮逐个拧
s.cumsum()、cummax()、cummin()、cumprod():累计家族,从头加(或取大取小、连乘)到当前位置,结果与原序列等长。**s.rolling(window, min_periods=None, center=False)**:window 给整数按行数开窗,给偏移量字符串(如"7D")按时间开窗——用时间开窗的前提是索引为时间类型;min_periods 是"最少要有几个样本才出数",默认等于 window(前几行为空),设小一点能让序列更早出值;center=True 让窗口以当前点居中。**s.expanding()**:从起点累计扩展的窗口,等价于"到目前为止"的全历史统计。**s.ewm(span=N)**:指数加权,越近的样本话语权越大,趋势敏感场景比等权滚动更跟手。
import pandas as pd s = pd.Series([10, 20, 15, 30, 25, 40]) print(s.cumsum().tolist()) # [10, 30, 45, 75, 100, 140] print(s.rolling(3).mean().round(1).tolist()) # [nan, nan, 15.0, 21.7, 23.3, 31.7] <- 前两位不够一锅 print(s.rolling(3, min_periods=1).mean().round(1).tolist()) # [10.0, 15.0, 15.0, 21.7, 23.3, 31.7] <- 放宽后提前出值
实操示例:七日滚动与月度累计
场景:给日销流水补两列——"近七天滚动均值"与"当月累计",这是日报的两个常客。先把索引换成时间(3.4 的手艺),再开锅。
df = pd.DataFrame({ "日期": pd.date_range("2024-05-01", periods=10, freq="D"), "销量": [12, 15, 9, 22, 18, 30, 25, 14, 19, 28], }).set_index("日期") # 滚动:按行数开窗 df["七日均量"] = df["销量"].rolling(7, min_periods=1).mean().round(1) # 累计:按月分组 cumsum,每月从零重新累计 df["月累计"] = df.groupby(df.index.to_period("M"))["销量"].cumsum() print(df[["销量", "七日均量", "月累计"]].head(8)) # 销量 七日均量 月累计 # 2024-05-01 12 12.0 12 # 2024-05-02 15 13.5 27 # ... ... # 2024-05-08 14 19.0 145
留意两列的差异:滚动列前几行依赖 min_periods 的宽容度,累计列则永远从第一行就有值。日报出数前,这两列的口径说明比数字本身更重要。
滚动指标的两种读法
同一列滚动均值,报表上可以有截然相反的两种读法,写脚本前要想清楚口径。读法一,看趋势:滚动线抹平单日毛刺,斜率说明走势,此时窗口越长越平滑;读法二,看异动:当日值与滚动基线的偏离才是重点,偏离超阈值触发告警,此时基线窗口要匹配业务的节奏(周节奏用七天,月节奏用三十天附近)。两种读法对应的窗口参数完全不同——参数不是数学题,是业务口径题。
df["基线"] = df["销量"].rolling(7, min_periods=1).mean() df["偏离"] = (df["销量"] - df["基线"]) / df["基线"] print(df[["销量", "基线", "偏离"]].round(2).tail(3))
偏离列就是"异动读法"的落地:滚动算基线、相除算偏离、超阈值进 8.4 的告警台账——汤锅与后厨动线在这里接上了头。
坑点与翻车
**翻车一:数据没排序就滚动。**rolling 沿行的先后位置滑,时间乱序时"近七天"就成了玄学——先 sort_index,这口锅才转得对。**翻车二:cumsum 遇缺失断不断。**累计家族跳过 NaN 继续累计,但结果位置上 NaN 依然保留为 NaN;下游若直接拿去相除,会收获一批意外空值——累计前先想好缺失的处置(回看 2.1)。**翻车三:window 的单位想当然。**rolling(7) 是"最近七行"不是"最近七天",一天三笔的数据里两者天差地别;要按时间就老老实实传 "7D" 并把索引换成时间类型。**翻车四:ewm 的 span 与 alpha 混用。**两者是一枚硬币的两面(alpha 等于 2 除以 span 加 1),同时给会报错;写报表脚本时选其一并注释口径。
替代方案
不滑窗口、只看"从开始到现在",用 expanding().mean(),起点更稳;要"近强远弱"的加权,ewm 比手工构造权重省事;多维的同时滚动(多列各自滚)直接对整个 DataFrame 调 rolling,不必逐列循环。而"分组内滚动"——每个门店各自的七日均线——是 groupby 与 rolling 的接力:df.groupby("门店")["销量"].rolling(7).mean(),组间互不串味。
本节要点回顾
- 累计家族:cumsum、cummax、cummin、cumprod,结果与原序列等长;
- rolling 三旋钮:window 定锅大小,min_periods 定出数底线,center 定锚点;
- 行数与时间:window 按行还是按天,必须与业务口径对上;
- 排序前置:滚动前先排时间,乱序的窗口没有意义;
- 延伸两味:expanding 看全历史,ewm 给近处加权重。
滚动的数值算出来了,最后一道工序按规则"定味道":4.4 的条件计算,让每个值按条件分流到应去的地方。