6.2 正则表达式:文本处理的万能小刀
6.2 正则表达式:文本处理的万能小刀
本节摘要:正则是文本处理的万能小刀——字符类定范围、量词定次数、分组定抓取,三件套拼出任意提取与替换模式。本节把 3.3 用过的 str.extract 背后的正则语言补全,给出贪婪匹配、转义、锚定三大雷区的避法,并交代 re 模块的独立用法。承接 6.1 的函数式加工,通往 6.3 的抽样。
上世纪的刀,今天依然趁手
上世纪的命令行时代,正则就是文本工程师的整套餐具;几十年过去,工具换了多少轮,这把小刀的刀法几乎没变——一套字符记号,描述"要抓什么样的文本",各语言各平台通吃。数据工作里它的用武之地:从备注里抠手机号、把五花八门的地址统一格式、按规则批量改名。3.3 那节你已经在 extract 里用过它,本节把这门语言本身讲全:学会自己写模式,而不是永远抄别人的。往前接函数式工具(正则函数也常配 apply 出场),往后 6.3 的抽样,跟它一软一硬各占调味架一头。
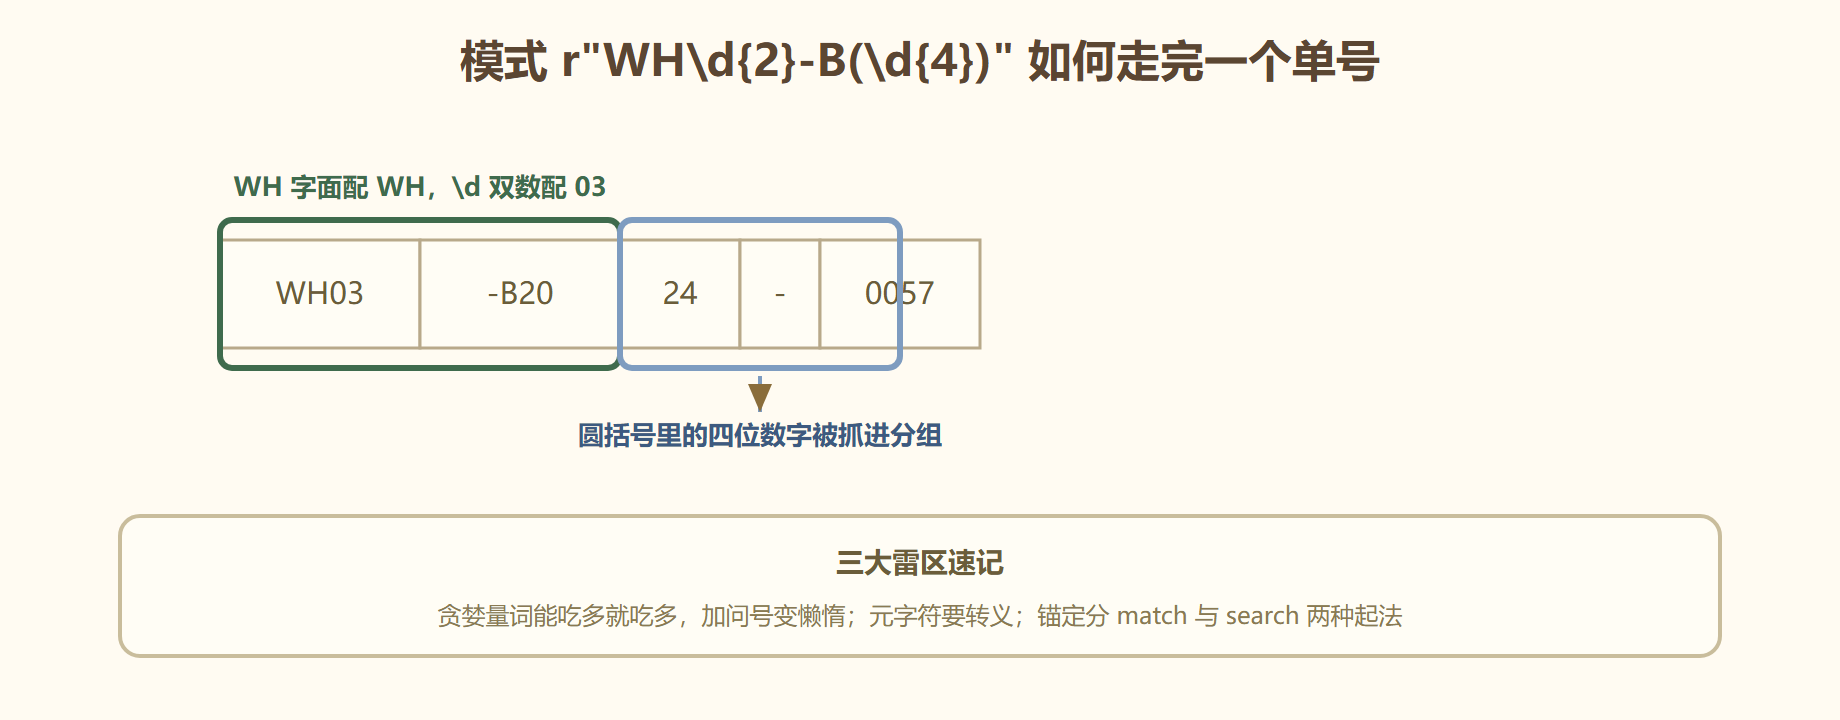
图 一次匹配的行走过程
参数拆解:语言三件套
字符类定"匹配谁":\d 是数字、\w 是字母数字下划线、\s 是空白,大写取反;方括号自定义集合,[一-鿿] 覆盖常用汉字,[A-Za-z0-9] 是字母加数字。量词定"配几次":星号零次以上、加号一次以上、问号零或一次、{m,n} 精确区间;默认贪婪——能吃多长吃多长,量词后跟问号变懒惰,吃到刚好满足为止。分组与分支:圆括号既是分组又是抓取范围,命名分组 (?P<名字>模式) 让 extract 直出带名列;竖线表"或",(jpg|png|gif) 三选一。锚定:^ 与美元符定行首行尾,\b 定词边界;re.match 只从字符串开头试,re.search 全串找首个命中——两者差在锚定,选错找不到还以为模式写错。
import re text = "联系人:张三,电话 138-1234-5678;备用 021-64321098" # findall 返回全部命中;分组只回括号里的内容 print(re.findall(r"\d{3}-\d{4}-\d{4}", text)) # ['138-1234-5678'] print(re.findall(r"(0\d{2})-(\d{8})", text)) # [('021', '64321098')] <- 分组成对返回
实操示例:从备注里清洗出结构化字段
场景:售后备注里混着客户留的回访时间,形如"周五下午""5月8日 14:00",要把标准写法的日期时间抽出来。 pandas 与 re 两路各演示一次。
import pandas as pd notes = pd.Series(["5月8日 14:00 回访", "已解决 5月12日 09:30", "无需回访"]) # pandas 路:str.extract 按命名分组直出列 out = notes.str.extract(r"(?P<月>\d{1,2})月(?P<日>\d{1,2})日\s*(?P<时>\d{1,2}:\d{2})?") print(out) # 月 日 时 # 0 5 8 14:00 # 1 5 12 09:30 # 2 NaN NaN NaN <- 无日期的行,抓不到即空,天然筛出"没写时间的" # re 路:sub 批量替换,把"5月8日"统一成"2024-05-08" def norm(m): return f"2024-{int(m.group(1)):02d}-{int(m.group(2)):02d}" print(re.sub(r"(\d{1,2})月(\d{1,2})日", norm, "复查定在5月8日")) # 复查定在 2024-05-08(月日补零)
注意 pandas 路的赠品:抓不到的行自动落 NaN——正则不仅是提取器,还是格式合格证(3.3 已经验过一次这个用法)。
常用模式小抄
开工前备一张小抄,比每次现想快:手机号一三开头十一位(r"1[3-9]\d{9}");邮箱粗配(r"[\w.]+@[\w.]+",够用级);中文连续段(r"[一-鿿]+");日期两种写法(r"\d{4}-\d{2}-\d{2}" 与 r"\d{4}/\d{2}/\d{2}");金额带小数(r"\d+(?:.\d+)?",问号让小数部分可选)。小抄的价值不在模式本身,而在结构——每条都是"字符类定量词加可选组"的组合,照这个结构自造模式,比背一百条现成的更抗用。
import re text = "联系人张三,手机 13812345678,座机 021-64321098" print(re.findall(r"1[3-9]\d{9}", text)) # 手机号先中 print(re.findall(r"0\d{2}-\d{7,8}", text)) # 区号加座机
两条模式并排跑互不干扰,是正则的另一个实用心法:与其写一条"什么都能配"的巨型模式,不如写成组简单模式各取所需。
坑点与翻车
**翻车一:贪婪吃过头。**r"<.+>" 匹配 HTML 标签时会把整行从第一个尖括号吃到最后一个;改懒惰 r"<.+?>" 才是一个标签一顿。所有"匹配结果比预期长"的问题,先怀疑贪婪。**翻车二:元字符当字面用。**点号、加号、问号、圆括号在正则里都是语法字符——匹配"3.5 折"里的点号要写成 3.5,或者把用户输入整个 re.escape 再拼进模式。**翻车三:match 的锚定误当 search。**re.match 只在开头试,正文中间的号码永远抓不到,还误以为模式不对——拿不准就 search,需求确实是"开头必须如此"才用 match。**翻车四:回溯失控。**嵌套量词加可选分组(比如 .. 之类)在长文本上能让匹配耗时指数膨胀,进程像卡死——遇到"一个正则跑不完",先简化模式、拆成两步,别硬调。
替代方案
能用普通字符串方法解决的,别上正则:startswith、endswith、in 判断更直白更快;固定分隔符的拆分交给 split;格式极其固定的字符串(定长编号)用切片 str.slice 比正则稳。反过来的极端——文本结构复杂到正则写不动的(嵌套结构、多行配对),该换专用解析器而不是把模式堆成天书。正则的适用带很清楚:模式有变化、但不至于有语法。
收档清单
- 三件套:字符类定范围,量词定次数,分组定抓取;
- 贪婪与懒惰:默认吃最多,量词后加问号改吃刚好;
- 元字符转义:点号括号要转义,用户输入先 escape;
- 锚定两种:match 只认开头,search 全串找,别混;
- 两个赠品:抓不到即 NaN 可当合格证,命名分组直出列名。
刀法齐了,调味架还剩一味"量"的学问:6.3 抽样与批流处理——数据太大时,怎么取、怎么分批、怎么边到边算。