6.1 map 与 apply:函数式三件套
6.1 map 与 apply:函数式三件套
本节摘要:把一个函数"挂"到一列或一张表上——map 吃字典做映射,apply 挂任意函数做加工,逐元素替换在新版里另有其名。本节讲清三者作用范围的差别、与推导式的亲缘,以及"能用向量化就别 apply"的性能铁律。承接调味架开篇,通往 6.2 的正则。
「vectorize」挂在嘴边的真正原因
「vectorize」,向量化——为什么老手劝人"先想想能不能向量化,再考虑 apply"?因为 apply 本质是把 Python 层的循环包了层皮:代码短了,逐行执行的成本一点没少。map、apply 与向量化三者的关系,是本节的暗线:字典映射交 map,复杂逻辑交 apply,能写成数组运算的交向量化——三条路都通向同一个结果,成本却差着数量级。往前接 1.2 的推导式直觉(map 就是它的函数版),往后 8.1 会拿实测数据给这笔账收尾。
适用场景:三件各管哪层
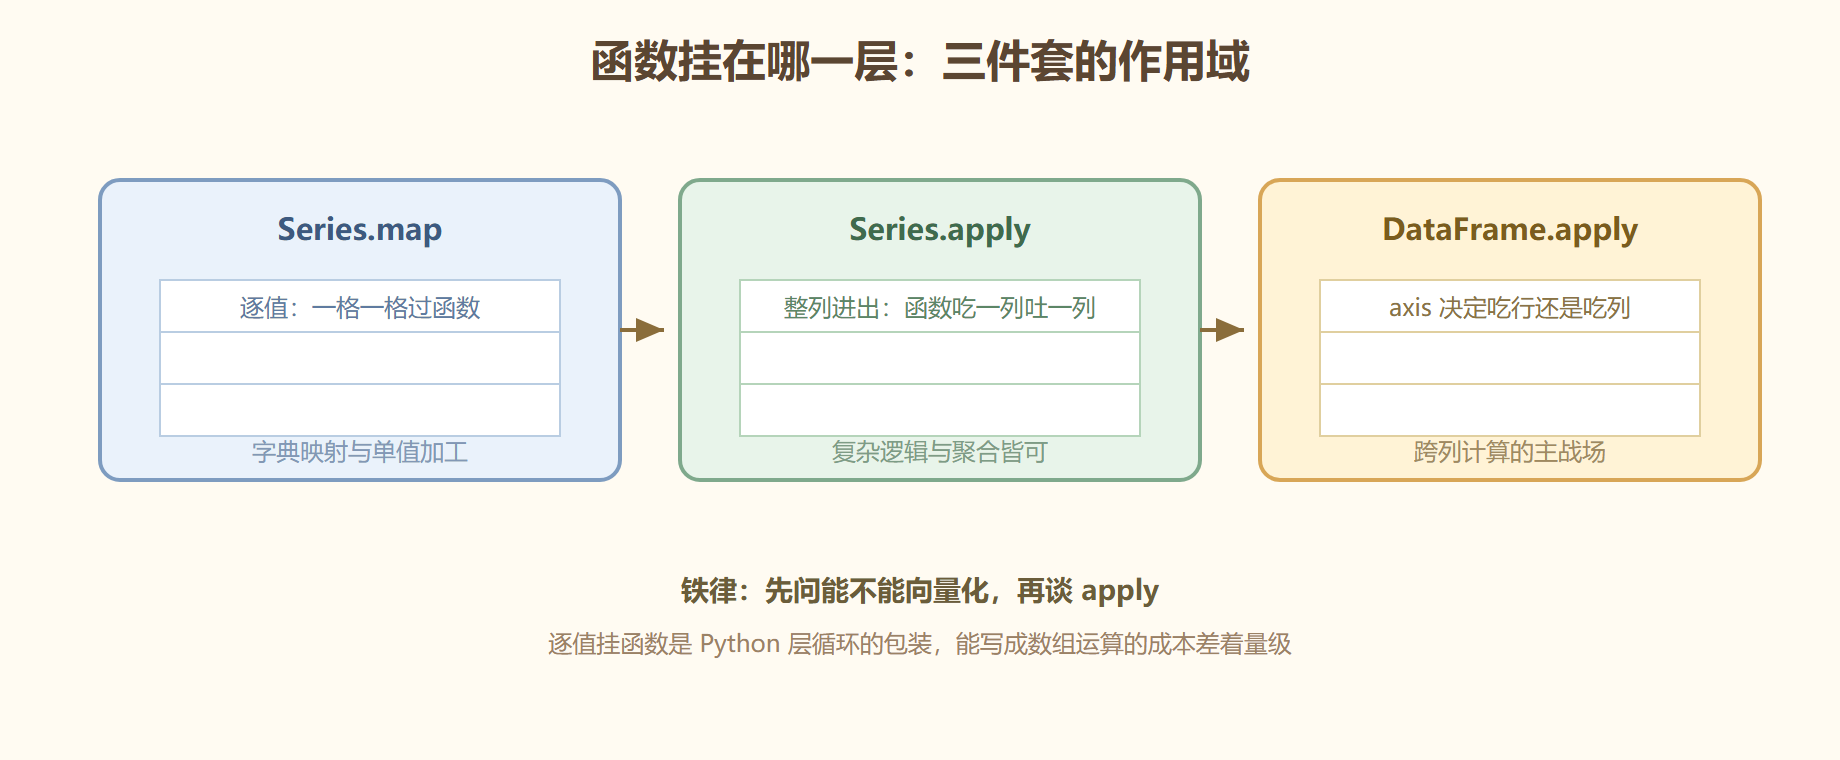
Series.map 管逐值映射:传字典,把枚举码翻成中文名;传函数,对每个值做同样加工。未命中的键默认变 NaN——字典映射的"覆盖检查"要心里有数。apply 管挂任意函数:Series.apply 对每个值调用;DataFrame.apply 默认按列调用(每列进函数一次),axis=1 改成按行调用(每行进函数一次),行为完全不同。逐元素替换:对 DataFrame 想对每个格子加工,旧写法 applymap 已在新版 pandas 更名为 DataFrame.map——版本不同函数名不同,团队协作时先对齐版本再对齐写法。
图 三件套的作用范围
参数拆解:旋钮逐个拧
s.map(arg, na_action=None):arg 给字典做翻译、给函数做加工;na_action='ignore' 让缺失直接透传不进函数。**s.apply(func, convert_dtype=True, args=())**:args 用来给 func 传额外位置参数。**df.apply(func, axis=0, result_type=None)**:axis=0 按列(每列是一个 Series 进函数),axis=1 按行(每行是一个 Series,列名变成它的索引);result_type='expand' 把返回的多值摊成多列。**df.map(func)**(新版本):逐元素加工整表,接替旧名 applymap。
import pandas as pd df = pd.DataFrame({ "渠道码": ["Q1", "Q2", "Q1", "Q3"], "单价": [12.5, 8.0, 12.5, 6.5], "数量": [3, 5, 2, 8], }) # 字典映射:码翻名,未命中变 NaN df["渠道名"] = df["渠道码"].map({"Q1": "直营", "Q2": "分销"}) print(df["渠道名"].tolist()) # ['直营', '分销', '直营', nan] # 行级加工:axis=1,每行进函数一次 df["小计"] = df.apply(lambda r: round(r["单价"] * r["数量"], 1), axis=1) print(df["小计"].tolist()) # [37.5, 40.0, 25.0, 52.0]
实操示例:字典翻译与跨列计算
场景:给订单表补渠道中文名(映射),再算"满减后实付"(跨列逻辑)。两种需求分别用 map 与 apply 的代表场景演示,最后给一条向量化对照。
df["实付"] = df.apply( lambda r: r["小计"] - 10 if r["小计"] >= 40 else r["小计"], axis=1) # 向量化对照:同样逻辑一行数组运算,速度快一个量级 import numpy as np df["实付2"] = np.where(df["小计"] >= 40, df["小计"] - 10, df["小计"]) print((df["实付"] == df["实付2"]).all()) # True
同一逻辑,apply 写法与向量化写法结果一致——但十万行数据上,前者以秒计,后者以毫秒计。判断标准很简单:函数体里只用了加减乘除与比较,就该向量化;需要 if-else 分支,回看 4.4 的 np.where 与 np.select;只有逻辑绕不开逐行状态时,apply 才是正当选择。
返回多列的挂法
apply 还有一手:让函数返回多个值,配 result_type="expand" 摊成多列——一行代码完成"一个函数产出一组新列",比逐列 map 省事。
def 拆单号(单): return pd.Series({"前缀": 单[:2], "流水": 单[2:]}) df[["前缀", "流水"]] = df["渠道码"].apply(拆单号)
注意返回的是命名 Series,列名直接成为新列名;expand 的展开要求每行返回结构一致,结构不稳时它会把不一致摊成更多 NaN——复杂解析优先考虑 6.2 的正则 extract,它的分组机制就是为"一次产多列"设计的。
坑点与翻车
**翻车一:map 字典未命中静默变 NaN。**渠道码里混进一个 Q9,映射后它悄悄成了空值,下游 groupby 的组就少了——枚举映射前先查一下值域:set 差集一眼看清"字典没盖住的键"。**翻车二:axis 想当然。**DataFrame.apply 想按行算小计,忘写 axis=1,函数拿到的是一列而不是一行,报错还算好的,更糟的是恰好"能算出个结果"——按列对行函数,语义全错。**翻车三:apply 里改了外部状态。**函数体里往外部列表 append,apply 的执行次数与顺序并不承诺稳定,用这种方式收集数据迟早出鬼——函数保持纯净,输入什么输出什么,别带副作用。**翻车四:新版本里 applymap 找不到。**pandas 新版把 DataFrame 逐元素方法改名 DataFrame.map,旧脚本迁移时这一处必改,报错信息会提示,但别等到线上才发现。
替代方案
能向量化的分支逻辑用 4.4 的 np.where、np.select;枚举映射之外,还可用 replace(也是字典)或 astype("category") 的类别映射;复杂逻辑拆成几个向量化步骤的组合,往往比一个巨型 apply 快得多——慢函数不优化,快组合自然成。至于"必须逐行且带状态"的少数场景(比如按时间重放资金流水),老老实实写显式循环,可读性反而高于伪装成向量的技巧。
本节要点回顾
- 三件套分工:map 管逐值与字典,Series.apply 管整列函数,DataFrame.apply 管跨列;
- axis 定方向:默认按列,axis=1 才是按行,写前先想函数吃什么;
- 未命中即空:字典 map 的覆盖检查是固定动作;
- 纯净无副作用:apply 的函数只管输入输出,别碰外部状态;
- 铁律:向量化优先,apply 只是备胎,这笔账 8.1 正式结。
文本加工的临时活还剩最难的一口——正则。6.2 把 3.3 留下的正则语言一次补全。