7.1 Pandas 函数地图:把手法归位四大区
7.1 Pandas 函数地图:把手法归位四大区
本节摘要:pandas 的函数名册有几百条,真正要记住的不是名单,而是地图——清洗、整形、聚合、合并四大区,每区的代表函数、入口姿势与组合套路。本节把前六章的手法整体收拢,并用一段端到端代码示范"按地图点菜"。承接中央厨房开篇,通往 7.2 的灶膛。
「CheatSheet」为什么人人都在攒
「CheatSheet」,速查表——数据从业者的收藏夹里总有几份,但攒了十份还是记不住的原因很简单:名单式的速查表没有"位置感"。函数记进地图就不一样:清洗区在择菜间、整形区在切配台、聚合区在汤锅区、合并区在摆盘区——需求一出现,先定位区域,再在区域内挑函数,最后查参数。本节把前六章散落的手法按四大区收拢成一张地图,并用一段完整代码示范怎么按图点菜。往前接六章全部手法,往后 7.2 钻进灶膛解释它们为什么快。
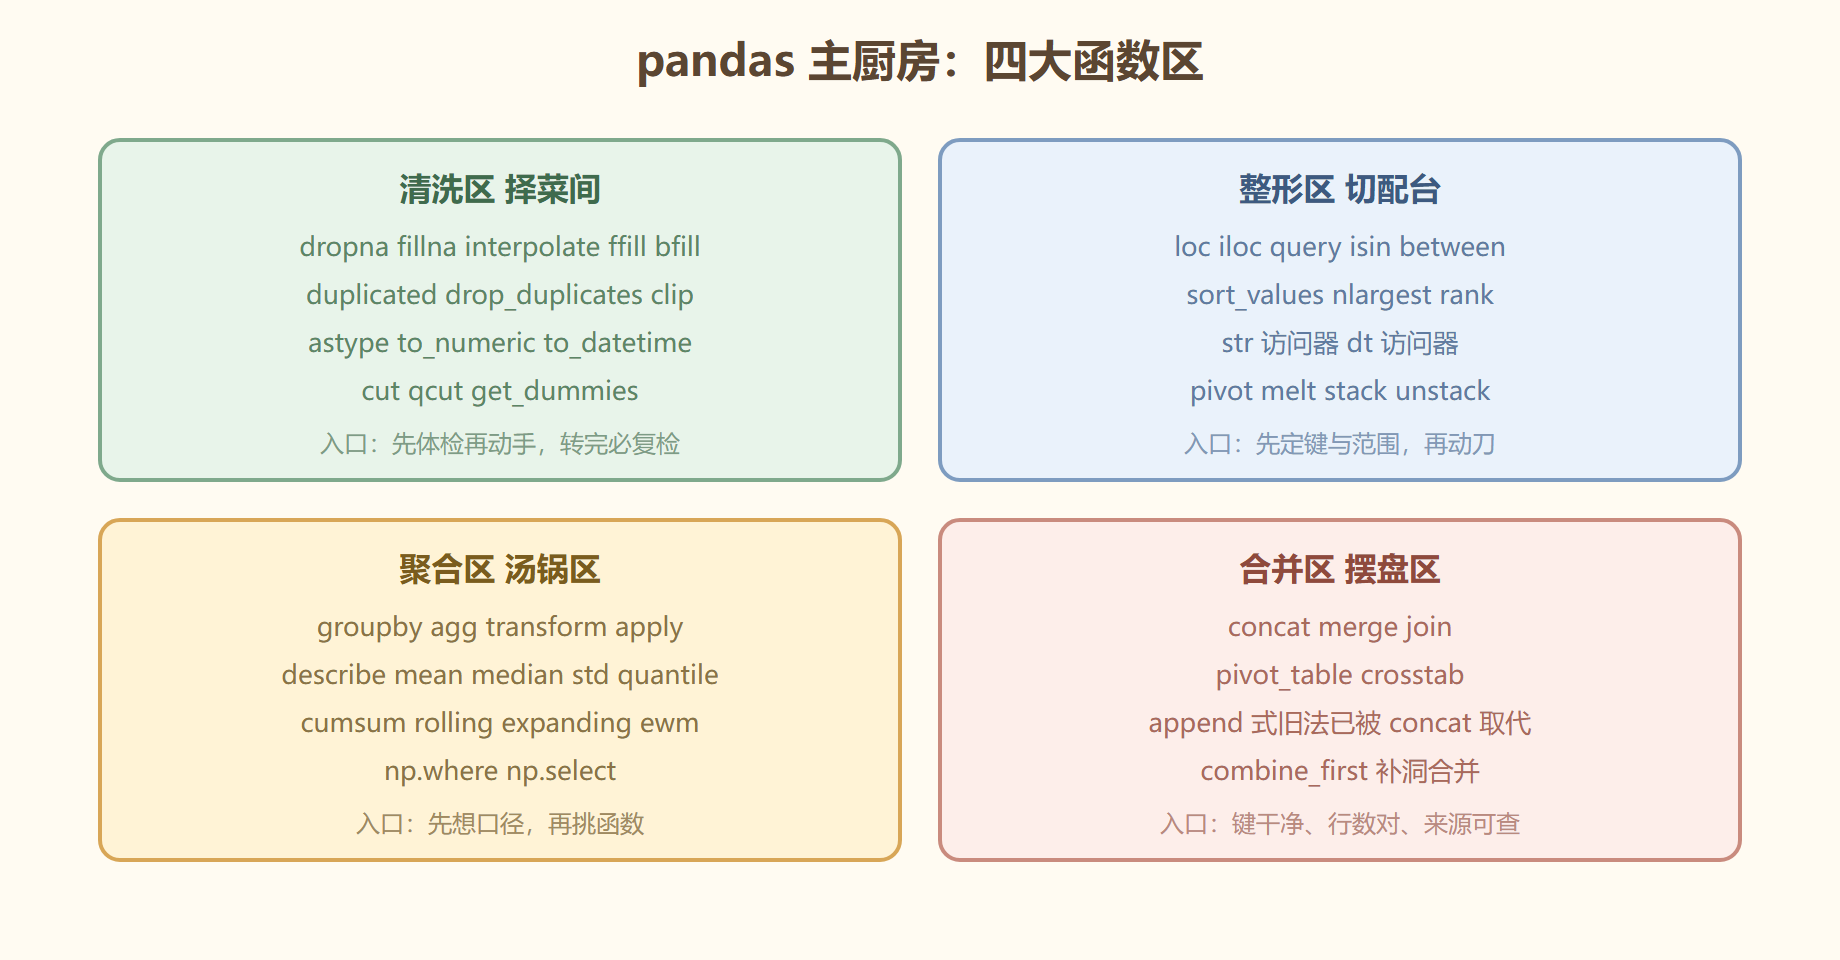
图 pandas 四大函数区
参数拆解:地图怎么用
用地图的法则是"需求到区域、区域到函数、函数到参数"三跳。要处理脏数据,进清洗区挑函数——缺失找 dropna 与 fillna,类型找 to_numeric;要改变形状或范围,进整形区——取子集找 loc,变长宽找 pivot 与 melt;要算指标,进聚合区——分组找 groupby 配 agg,滚动找 rolling;要拼表出报表,进合并区——摞表找 concat,对位找 merge,出二维报表找 pivot_table。每一区的参数纪律,前六章都已逐个拧过,地图不重复讲参数,只负责让你"想到该去哪"。
进口与出口:地图的边界
四大区管"表上的功夫",但一条完整链路还有两端。进口:read_csv、read_excel、read_sql、read_parquet——读法决定后面一半的清洗量,dtype、usecols、parse_dates、nrows 这几个进口参数用熟,很多清洗直接免做(2.4、6.3、8.2 各从一个角度受益)。出口:to_csv、to_excel、to_parquet、to_sql——导出的关键参数是 index(要不要把索引写成列,多数场景 False)与 encoding(跨平台交换选 utf-8 类编码,避免下游读成乱码)。进出的姿势固定了,中间四大区随便怎么连招都稳。
| 环节 | 代表函数 | 一句提醒 |
|---|---|---|
| 进口 | read_csv、read_parquet | dtype 与 usecols 在进口定,省下游一半活 |
| 清洗区 | dropna、fillna、to_numeric | 转完必复检缺失 |
| 整形区 | loc、sort_values、pivot | 先定键与范围再动刀 |
| 聚合区 | groupby、agg、rolling | 先想口径再挑函数 |
| 合并区 | merge、concat、pivot_table | 键干净、行数对、来源可查 |
| 出口 | to_parquet、to_excel | index=False,编码写明 |
这张总表适合贴在 7.1 的地图旁边:需求来了先定位环节,再按表的提醒过一遍纪律,最后进对应章节翻参数细节——地图、速查表与食谱卡三层齐备,pandas 就不再是几百个函数的迷雾,而是一间布局熟悉的厨房。
实操示例:按地图跑通一条龙
场景:一份订单明细(前六章的老朋友),从读入到出报表一气呵成。注意每个注释标明的"区域",这正是地图的用法。
import pandas as pd import numpy as np # 读入(厨房大门) df = pd.DataFrame({ "订单号": ["A1", "A2", "A2", "A3", "A4"], "日期": ["2024-05-01", "2024-05-03", "2024-05-03", "2024-05-08", "2024-06-02"], "渠道": ["直营", "分销", "分销", "直播", None], "金额": ["120.0", "88", "88", "待定", "210.0"], }) # 清洗区:去重、类型矫正、缺失处置 df = df.drop_duplicates(subset=["订单号"]) df["金额"] = pd.to_numeric(df["金额"], errors="coerce") df["渠道"] = df["渠道"].fillna("未知") # 整形区:时间入籍、派生月份 df["日期"] = pd.to_datetime(df["日期"], format="%Y-%m-%d") df["月份"] = df["日期"].dt.to_period("M").astype(str) # 聚合区:分组求总额 agg = df.groupby(["月份", "渠道"], as_index=False)["金额"].sum() # 合并区:透视出报表 report = agg.pivot(index="月份", columns="渠道", values="金额").fillna(0) print(report) # 渠道 分销 直播 直营 # 月份 # 2024-05 88.0 0.0 120.0 # 2024-06 0.0 210.0 0.0
坑点与翻车
**翻车一:跳区作业。**需求明明是聚合,却用循环逐行累加;明明是清洗,却写正则去"修"数值——在错误的区里找函数,写得出来也别写。**翻车二:函数名记错代际。**pandas 演化快,旧的 append、applymap 等已由 concat 与 map 接管——地图上的函数以当前版本文档为准,团队内对齐版本比背名单重要。**翻车三:只记函数不记纪律。**to_numeric 配 coerce 后复检、merge 开 validate、rolling 前先排序——这些纪律跟着函数走,用函数不带纪律等于没学。**翻车四:地图当铁笼。**四大区是坐标不是围墙,实际脚本常常多区连招——本节示例就是四区各出一招;地图的价值在"迷路时知道在哪",不在"一次只能待一区"。
替代方案
地图之外还有两条路:一是官方用户指南的目录本身就是一张图,章节结构与本册四大区高度同构,遇到陌生函数先归区再查文档;二是用代码补全工具的函数联想快速试错——但联想给得出函数名,给不出参数纪律,纪律仍然要靠本册这种食谱卡。至于更细的内存与性能视角,下一节钻进灶膛看个究竟。
收档清单
- 四大区:清洗、整形、聚合、合并,需求先归区再挑函数;
- 三跳法则:区域、函数、参数,逐跳定位不迷路;
- 纪律随身:每个函数的纪律与函数同记,缺一不可;
- 版本对齐:函数名有代际,团队统一版本文档;
- 连招常态:多区连用是常态,地图用于定位而非画牢。
地图有了,但这一厨房的速度从哪来?7.2 钻进灶膛:NumPy 的内存布局与广播规则。