7.2 NumPy 向量化:灶膛里的速度秘密
7.2 NumPy 向量化:灶膛里的速度秘密
本节摘要:pandas 的快,根子在脚下的 NumPy——同型数组的连续内存、整批执行的底层循环、按右对齐展开的广播规则。本节讲清数组创建、dtype 与内存、广播三件事,把 1.2 埋下的"逐元素"直觉升级成可推理的规则。承接 7.1 的地图,通往 7.3 的专用调料柜。
为什么 pandas 的循环快、你的循环慢
为什么同样一行求和,pandas 一瞬间、Python 循环要半天?不是 pandas 会魔法,是它把活交给了脚下的 NumPy:数组里的数据连续排在内存里、类型整齐划一,运算整批交给底层一次做完;而 Python 列表里每个元素都是独立对象,循环一次就要逐个"敲门"。理解灶膛,你才知道哪些写法能吃到速度红利、哪些写法把红利又还了回去。本节往前接 1.2 的数组算术与 6.1 的性能铁律,往后为 8.1 的效率优化备好理论底座。
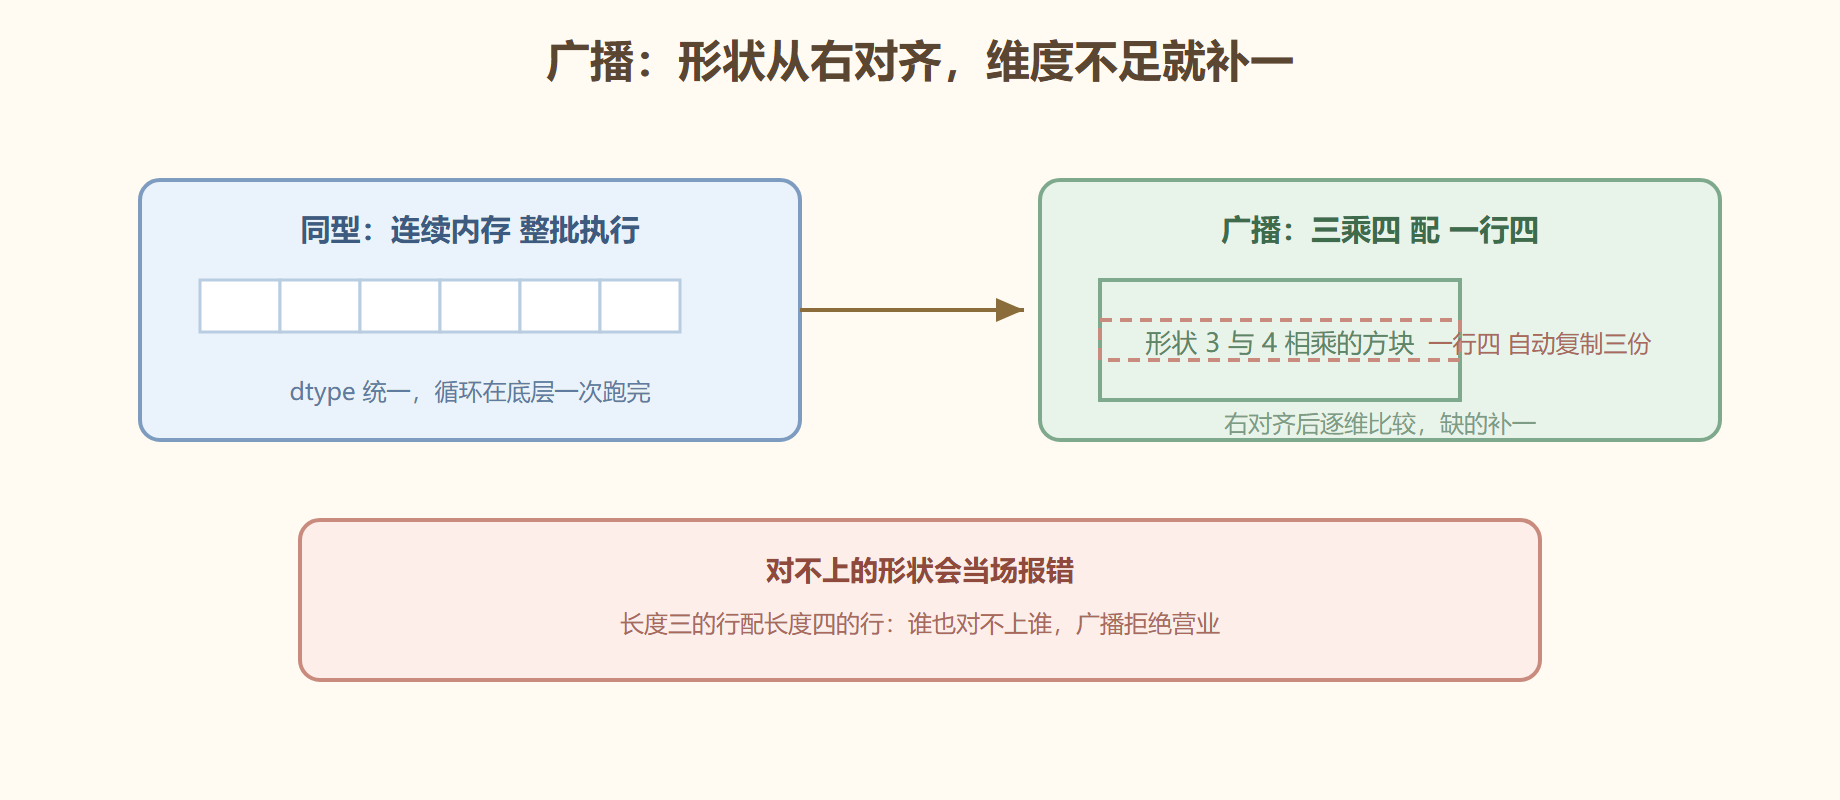
图 同型数组与广播的形状规则
参数拆解:灶膛三件事
数组创建:np.array 从列表建数组,np.zeros、np.ones、np.arange、np.linspace 造规则数组;创建时 dtype 就定死,np.array([1, 2, 3], dtype="float32") 显式指定。dtype 与内存:数组所有元素同型同宽——float64 每格八字节,百万级数据换 float32 能省一半内存,这与 8.2 的降级手段直接相通。广播:两个数组运算时形状从右对齐逐维比较——相等或其中一方为一(或缺维)就能成,"一"的那一维自动复制展开;对不上的组合当场报错,宁报错不乱配。
import numpy as np # 同型整批 a = np.arange(1, 7).reshape(2, 3) # [[1,2,3],[4,5,6]] b = np.array([10, 20, 30]) # 形状 (3,) print(a + b) # [[11 22 33] # [14 25 36]] <- b 沿行方向自动复制两份 # 对不上就报错 try: a + np.array([1, 2, 3, 4]) except ValueError as e: print("形状不兼容:", e)
实操示例:条件、聚合与 nan 系函数
场景:把一批温度读数整批处理——异常压界、缺失感知聚合、按行统计。三步全走 NumPy,一行循环不写。
rng = np.random.default_rng(42) temps = rng.normal(20, 5, size=(4, 3)) # 四天、每天三时段 temps[1, 2] = np.nan # 混入一个缺失 # 条件压界:等效 2.2 的 clip clipped = np.clip(temps, 5, 30) # 缺失感知聚合:普通 mean 遇缺变 NaN,nan 系函数自动跳过 print(np.nanmean(clipped, axis=1).round(1)) # [19.3 20.4 20.8 19.9] <- 每天的日均值,axis=1 沿行聚合 # 布尔数组直接当面具 mask = np.nanmean(clipped, axis=1) > 20 print(mask) # [False True True False]
axis 的语义立个桩:axis=0 沿行方向压下去(每列出一个数),axis=1 沿列方向扫过去(每行出一个数)——记"axis 是被压扁的那一维",比背方向口诀稳。
数组的手法速成
灶膛里的常用手法值得过一遍手。形状手术:reshape 变形不改数据,ravel 摊平,vstack 与 hstack 拼接——与 5.1 的 concat 心法相通,只是对象从表变成数组。统计全家桶:sum、mean、std、argmax、argmin 都带 axis 参数,argmax 给"最大值的位置"而不是值本身,定位场景极好用。集合运算:np.unique 去重兼排序、np.intersect1d 与 np.union1d 做交集并集——比列表推导式快且直白。
a = np.arange(6).reshape(2, 3) print(a.sum(axis=0), a.sum(axis=1)) # 两种方向的聚合对比着记 print(np.argmax(a), np.unravel_index(np.argmax(a), a.shape)) # 5 (1, 2) <- 展平位置还原成行列坐标
这些手法单个都简单,价值在组合:把 reshape、axis 聚合、布尔面具连起来用,多数"逐行循环"的活都能整批干完——这正是 8.1 提速改造的素材库。
坑点与翻车
**翻车一:视图与副本不分。**切片取出的是视图——改视图动原数组;要独立副本显式 .copy()。pandas 底层同样有这个问题,SettingWithCopyWarning 的根子一半在这。**翻车二:整数数组被赋值 NaN 崩掉。**整数 dtype 容不下 NaN,硬塞直接抛异常——先转 float 或用 1.1 介绍的可空类型思路。**翻车三:axis 方向背错。**聚合方向想反,每行均值算成每列均值,报表数字全错但格式全对——最阴险的一类错,出数前拿小数据手验。**翻车四:广播"成功"了但语义错了。**形状 (n,) 与 (n,1) 能广播出 (n,n)——运算不报错、结果却从"两列相减"变成"矩阵外积",金融与评分场景里这类静默错极其常见,写前先 print(shape)。
从 NumPy 回看 pandas
学完灶膛,再回头看前文的几个现象会突然通透:pandas 的 mean、std 之所以带 skipna 与 ddof 参数,是在给底层数组运算补"缺失语义"与"统计口径";astype 的快,是同型内存整批重排;groupby 的慢,多半慢在分组的 Python 层而非聚合本身。把 pandas 的每个动作翻译成"数组层发生了什么",参数不再是需要背的清单,而是对底层行为的直接描述——这层理解带去读任何库的手册,都比背 API 更保值。
替代方案
需要 pandas 的标签与缺失语义时,别硬用裸数组——Series 与 DataFrame 是数组的"带标签包装",聚合、对齐、缺失处理都是现成的;纯数值密集计算才下到 NumPy。统计检验类需求,scipy.stats 是专门的柜子(7.3 开柜);而"数组太大单机吃不下",广播救不了内存,得去 7.4 找 Dask。至于循环确实绕不开的场景(逐条业务规则、带状态推进),写显式循环并注释清楚,比硬凹向量化更诚实。
收档清单
- 快的根源:同型、连续内存、整批执行,三件齐了才快;
- 广播规则:形状右对齐,逐维相等或为一,对不上即报错;
- nan 系函数:缺失感知的聚合,np.nanmean 家族替你跳过 NaN;
- 视图与副本:切片是视图,改前想清楚,要独立就 copy;
- axis 是压扁的维:axis=0 压行出列统计,axis=1 压列出行统计。
灶膛看明白了,接下来开两柜专用调料:7.3 的 SciPy 统计检验与 scikit-learn 预处理。