1.1 核心概念:智能体、环境、状态、动作与奖励
1.1 核心概念:智能体、环境、状态、动作与奖励
本节摘要:智能体是通过试错学习的决策者,环境是它无法完全控制但可以观察的外部世界,状态是对世界某一时刻的描述,动作是智能体可做的选择,奖励是环境给出的单步数值反馈。这五个概念构成强化学习的最小闭环,其余一切(价值函数、策略梯度、经验回放)都是在这个闭环上加装的部件。本节的任务是把每个零件的边界划清楚,尤其是奖励——它不是"分数",而是你写给智能体的目标函数。
一、从训练小狗说起
你教小狗"握手",不会发给它一本动作说明书。你伸出手,它碰巧抬起前爪搭上来,你立刻给一块零食;它咬你的手,你皱眉不给。反复若干次后,小狗学会了:看到手伸过来 → 抬爪搭上 → 有吃的。这个过程里有全部五个角色:小狗是智能体(agent),你家客厅连同你是环境(environment),"手伸过来"这个局面是状态(state),"抬爪""咬""蹲着不动"是可选的动作(action),零食与皱眉合起来构成奖励(reward)信号——正的或负的数值。
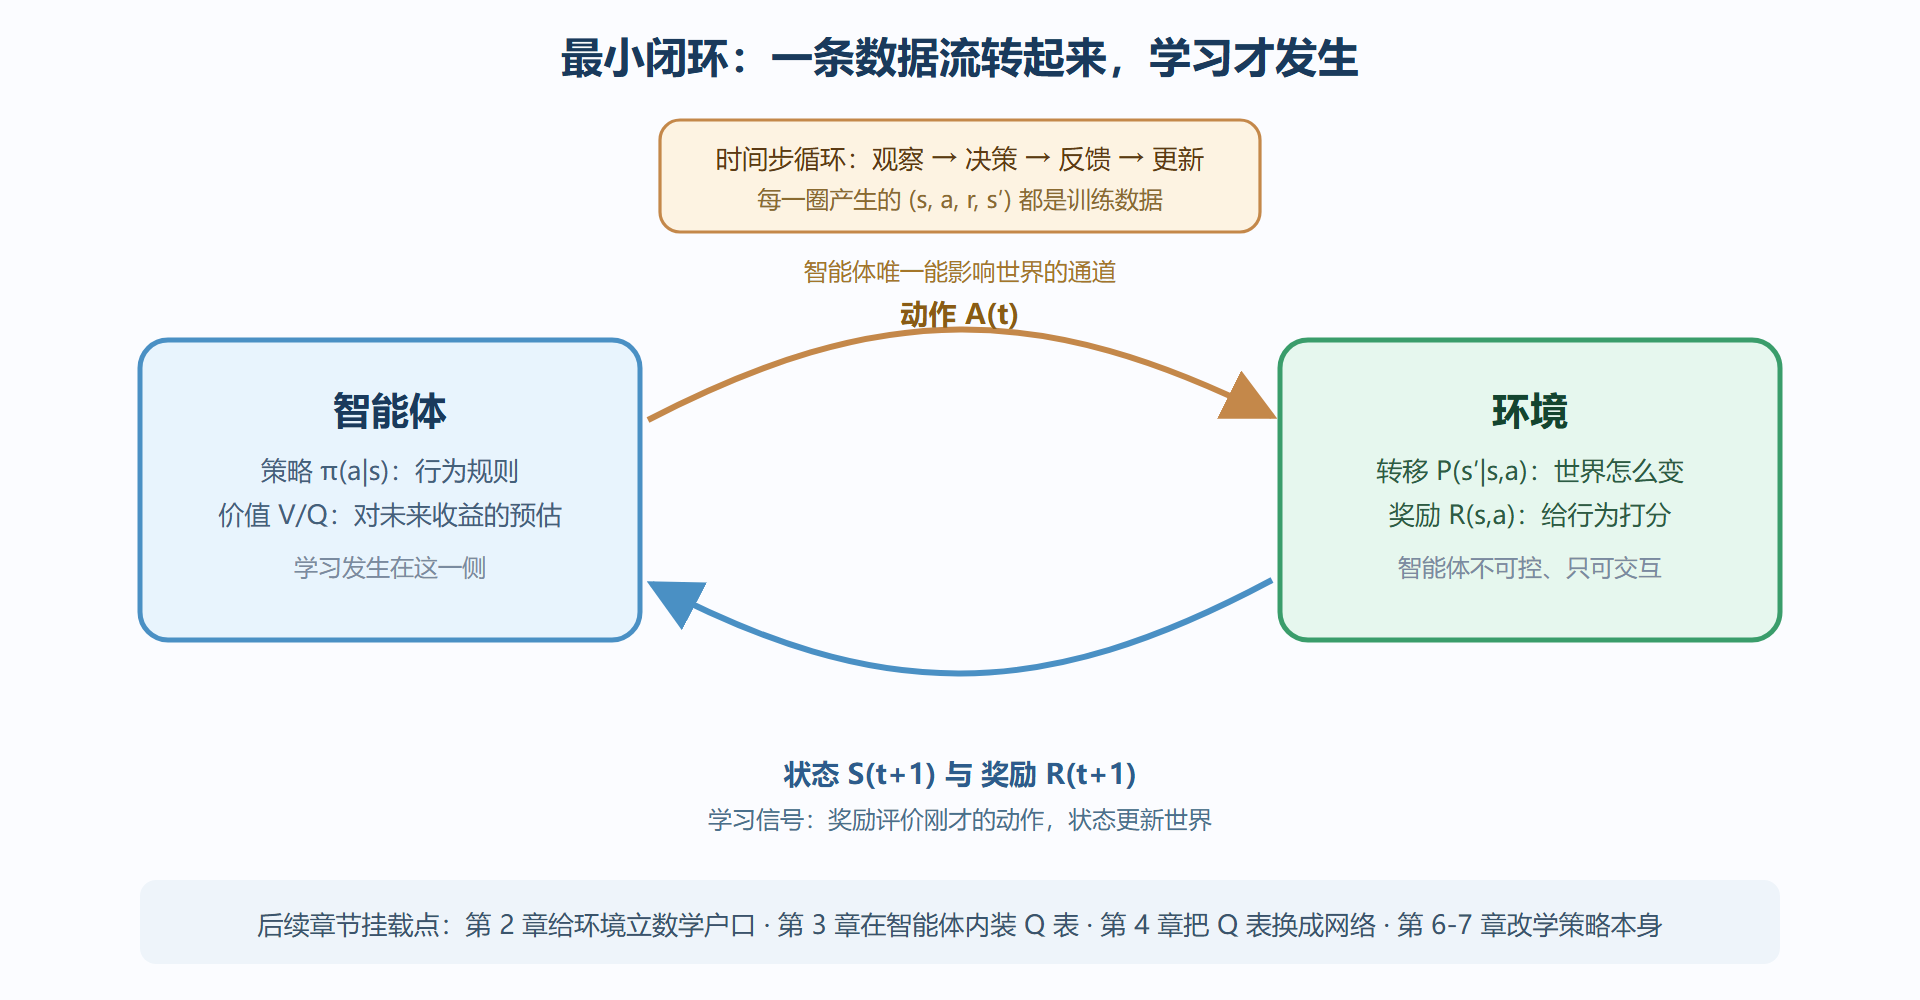
把这套词汇形式化:在每个离散时刻 t,智能体观察到状态 S_t,按某种规则选出动作 A_t,环境随后给出奖励 R_{t+1} 并把世界推进到新状态 S_{t+1}。如此循环,产生一条轨迹:
S_0, A_0, R_1, S_1, A_1, R_2, S_2, ...
强化学习的目标只有一句话:**调整智能体的行为规则,使长期累积的奖励尽可能多。**注意不是"当前这一步的奖励最多"——小狗如果只知道盯着眼前的零食,可能会学会抢食而不是握手。"长期"二字是强化学习全部难度的来源,1.2 节会把它变成可计算的量。
这个闭环与监督学习的差别值得停留一下。监督学习拿到的是带标准答案的数据集:"这个状态,正确动作是这个"。强化学习没有标准答案,只有事后才到账的评分;而且这个评分往往有噪声、有延迟,甚至被自己的历史行为污染——你只能评估你走过的路,没走过的路永远不知道会怎样。这个"只能从自己的经验中学习"的特性,决定了后面每一章的设计取舍。
二、五个零件的边界与易混淆点
智能体是做决策的程序或实体,但边界要划清:在机器人任务里,智能体是决策算法,不是机械臂本体——电机与关节属于环境。这个划分看起来咬文嚼字,实则重要:机械臂的延迟、抖动、磨损都是智能体必须承受的环境特性,把它们算进智能体内部会让你误以为可以"学到"它们不存在。
环境负责两件事:根据当前状态和收到的动作,给出奖励并转移到一个新状态。用符号写就是 P(s', r | s, a)——在状态 s 执行 a 后,转移到 s' 并获得 r 的概率。如果这个概率分布是已知的,问题叫"有模型";未知的叫"无模型"。第 3 章的动态规划属于前者,从蒙特卡洛开始都属于后者,这条分界线贯穿全书。
状态是你选择让智能体看到的世界切片。同一只小狗,状态可以是"手是否伸过来"(两态),也可以加上"手的朝向、你的表情、距离"(连续多态)。状态设计是建模的第一张多米诺骨牌:信息给少了(部分可观测),智能体会表现得健忘;给多了,学习样本被稀释。工程上的铁律是:状态里至少要包含预测未来所需的一切——下棋只看当前棋盘形状而不看轮到谁走,是典型的状态缺陷。
动作可以是离散的(按键、左转右转)或连续的(油门开度 0 到 1 之间的实数)。这个看似平淡的分类,实际是一条路线分界:离散动作适合价值方法(Q-Learning、DQN 都靠"逐个动作打分"),连续动作在 Q-Learning 框架下会遭遇"对每个连续取值打分再取最大"的不可行问题,这正是第 5 章策略梯度和第 5 章 DDPG 登场的理由。
奖励最容易出设计事故。它是一个标量函数 R(s, a) 或 R(s),由你亲手写进环境代码里。两个经典陷阱:其一,稀疏奖励——只有通关才有 +1,中间全是 0,智能体在漫长的零反馈里瞎撞,学习慢到不可用,第 6 章的探索方法与奖励塑形都是为它准备的;其二,奖励作弊(reward hacking)——你奖励"清扫灰尘",它学会把灰尘扫进地毯下面。奖励是你真实意图的代理,代理与意图的缝隙,智能体一定会钻。
下面的最小代码把闭环写出来。它不训练任何东西,只是把"轨迹如何产生"演给你看:
import random class GridEnv: # 4 格走廊:起点0,终点3 def reset(self): self.s = 0 # 每回合从 0 号格出发 return self.s def step(self, a): # a=1 向右,a=0 向左 self.s = min(3, max(0, self.s + (1 if a == 1 else -1))) r = 1.0 if self.s == 3 else -0.01 # 到终点 +1,每步小惩罚 done = (self.s == 3) return self.s, r, done # 新状态、奖励、是否终止 env = GridEnv() s, total = env.reset(), 0.0 while True: a = random.choice([0, 1]) # 随机策略:先看数据长什么样 s, r, done = env.step(a) total += r if done: break print(f"一条随机轨迹的总奖励: {total:.2f}") # 典型输出: 一条随机轨迹的总奖励: 0.85 # (步数越少奖励越高:直达 3 步得 0.97;绕远 10 步只剩 0.90 上下)
跑几次你会发现总奖励每次不同——环境即使确定性,随机策略也会产生不同轨迹。强化学习的所有量都是随机变量的期望,这一点在 3.2 节蒙特卡洛方法里会变成具体的计算。
三、策略与价值函数:闭环上的两个软件部件
五个物理零件之外,还有两个"软件部件"挂在智能体内部。策略 π(a|s) 是从状态到动作的映射:确定性策略直接给出"在 s 就做 a";随机策略给出概率分布"在 s 做 a 的概率是 0.7"。学习的过程就是不断修改 π。价值函数是对未来的预估:V(s) 表示"从状态 s 出发、按当前策略走下去,期望能拿到多少累积奖励";Q(s, a) 进一步到"在 s 先做动作 a 再按策略走下去"的期望。注意因果方向:策略是原因,价值是结果——策略变了,价值跟着变。第 2 章的贝尔曼方程会给出这两者的精确递归定义,第 3 章的 Q-Learning 本质上是在直接逼近最优 Q 值。
理解边界之后,回看小狗:伸出的手是状态,抬爪是动作,零食是奖励,小狗脑中"这种局面该怎么做"的直觉是策略,"这么做大概有吃的"的预期是价值。五个概念各就各位。下面这张闭环总图值得打印出来贴在显示器边上——后面每一章的新算法,本质上都是往这张图的某条边上贴新部件。
图:智能体-环境-奖励闭环总图——全书的原点
易踩的三个坑
⚠️ 把奖励设成"每步 0、终点 +1"后抱怨学不动——先检查是不是稀疏奖励问题,试着给中间进展一个小正奖励(但要小心塑形过度,1.2 节末尾有反例)。
⚠️ 把"智能体自身的传感器读数"当成环境的内部真相——状态永远是你建模出来的观测切片,观测被遮挡时问题变成部分可观测 POMDP,需要用历史信息(比如连续几帧画面堆叠,DQN 就这么干)。
⚠️ 混淆 return 与 reward:中文都常被说成"奖励"。本教程约定:reward 指单步即时反馈 R,return(回报)指累积 G。读到公式时先确认符号,R 和 G 差一个未来的和。
要点收束
- 最小闭环:状态进、动作出、奖励回,一切强化学习算法都在利用这条数据流。
- 环境的数学身份是转移与奖励的联合分布 P(s', r | s, a);已知为有模型,未知为无模型。
- 状态是建模选择,不是客观世界本身;动作的离散或连续决定你日后走价值路线还是策略路线。
- 奖励是目标函数的代理:稀疏会拖慢学习,粗糙会招来作弊。
- 策略与价值是因果对:π 是行为规则,V 与 Q 是对这套行为长期收益的预估。