1.2 回报与折扣因子:奖励的时间价值
1.2 回报与折扣因子:奖励的时间价值
本节摘要:回报 G_t 是从时刻 t 起未来所有奖励的加权和,折扣因子 γ 决定远期奖励在今天的"汇率"。公式是 G_t = R_{t+1} + γR_{t+2} + γ²R_{t+3} + ……本节用具体数字算清三件事:γ 如何压缩远期权重;γ 的取值如何把智能体从"近视"调成"远视";以及为什么 γ 小于 1 能让无限任务的数学不出血。这是全书第一个需要动手算的公式,请准备纸笔。
定义先行:回报不是单次奖励
上一节反复强调目标是"长期累积奖励最大",现在把它写成式子。从时刻 t 出发,回报(return)定义为后续奖励的加权和:
G_t = R_{t+1} + γ R_{t+2} + γ² R_{t+3} + γ³ R_{t+4} + ... = Σ γ^k · R_{t+k+1}
其中 γ ∈ [0, 1) 叫折扣因子(discount factor)。为什么乘一个小于 1 的系数逐级衰减?三个动机,一个比一个实际。第一,金融直觉:今天的奖励比明天的奖励值钱,未来要"按现值折算"。第二,数学保险:当任务没有终点(比如恒温器永远运行)时,不加折扣的奖励和可能发散到无穷,没法优化;γ < 1 保证只要每步奖励有界,回报就有界。第三,工程现实:环境有噪声,预测越远越不准,远期奖励本来就该在当前决策里少占分量。
手算:γ 如何压缩远期权重
假设一条轨迹上,从当前时刻起每步都稳定拿到 +1 的奖励(这是最好算的情形)。取不同的 γ,看前几步的权重怎么变:
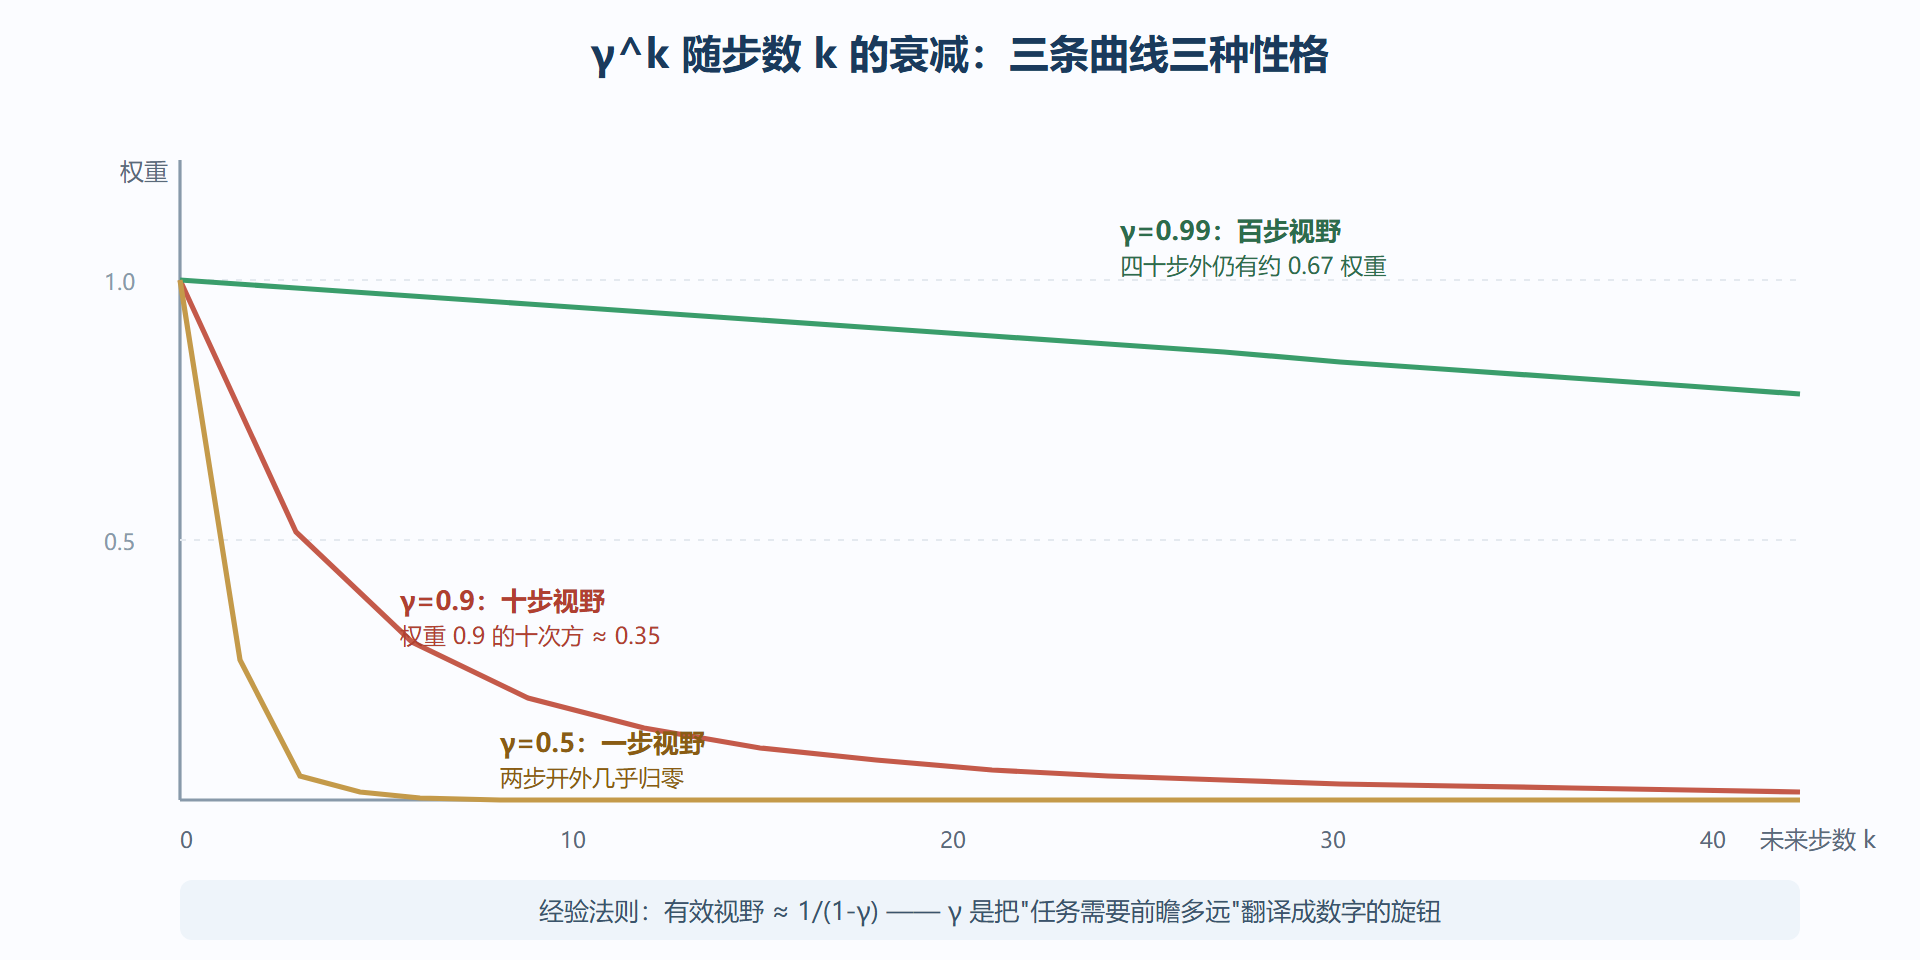
| 时刻偏移 k | 权重 γ^k(γ=0.9) | 权重 γ^k(γ=0.99) | 权重 γ^k(γ=0.5) |
|---|---|---|---|
| 0(下一步) | 1.000 | 1.000 | 1.000 |
| 1 | 0.900 | 0.990 | 0.500 |
| 4 | 0.656 | 0.961 | 0.063 |
| 9 | 0.387 | 0.904 | 0.002 |
| 19 | 0.148 | 0.818 | 0.000001 |
| 理论总和(无穷步) | 10.0 | 100.0 | 2.0 |
规律一眼可见:γ=0.5 的智能体基本只看眼前一步(两步开外权重已经趋近零);γ=0.9 的智能体"有效视野"约为十步量级;γ=0.99 的智能体能把一百步之外的得失纳入当下决策。最后一名经验法则是 **1/(1-γ) 给出有效视野的长度尺度**:γ=0.9 对应约十步,γ=0.99 对应约一百步。这不是巧合,几何级数的求和公式 Σγ^k = 1/(1-γ) 直接给出结果。
图:折扣因子权重衰减曲线——智能体的"眼光"长度
用一个非均匀的例子完整算一遍回报。假设从当前状态出发的未来奖励序列是 [+2, 0, -1, +4, 0, ...](第四步有一个大奖励,之后全零),取 γ=0.9:
G = 2 + 0.9×0 + 0.81×(-1) + 0.729×4 + 0 = 2 - 0.81 + 2.916 = 4.106
同一个序列换 γ=0.5:
G = 2 + 0 - 0.25 + 0.5 + 0 = 2.25
两个数字差了近一倍。短视的智能体几乎没"看见"第四步那个 +4;远视的智能体把它充分折算进了当前状态的估值。你在后面章节会反复看到:任务需要的规划深度,直接决定 γ 该取多少——迷宫类任务要 γ≥0.95,反应类任务 0.9 就够。
代码演练:一条轨迹的回报计算
下面的函数把定义直接翻译成代码,并演示同一批奖励在不同 γ 下的回报:
def discounted_return(rewards, gamma): """rewards: 从 t+1 开始的奖励列表;gamma: 折扣因子""" g = 0.0 for k, r in enumerate(rewards): g += (gamma ** k) * r return g ep = [2.0, 0.0, -1.0, 4.0, 0.0] # 一段未来奖励 for gamma in (0.5, 0.9, 0.99): print(f"gamma={gamma:>4}: G = {discounted_return(ep, gamma):.3f}") # 输出: # gamma= 0.5: G = 2.250 # gamma= 0.9: G = 4.106 # gamma=0.99: G = 4.921
还有个实现上很优雅的递归形式,贝尔曼方程的灵魂就藏在这里:
G_t = R_{t+1} + γ G_{t+1}
回报 = 下一步奖励 + 打折后的"从下一步开始的回报"。整个值是递归的:要算今天的回报,只需明天的回报加上今天的即时奖励。第 2 章的贝尔曼方程就是把这条递归式从"具体轨迹的回报"升级到"期望意义下的价值",一个符号都不多。写代码验证一下这层递归:
def g_recursive(rewards, gamma): if not rewards: # 没有未来,回报为 0 return 0.0 return rewards[0] + gamma * g_recursive(rewards[1:], gamma) print(g_recursive([2.0, 0.0, -1.0, 4.0, 0.0], 0.9)) # 4.105999999999999 # 与展开式一致:递归只是把求和倒过来算
γ 的选择是行为设计,不是超参玄学
很多人把 γ 当成炼丹参数随手填 0.99,其实它是在替智能体表态:"你在乎多久以后的事?"这直接改变最优策略的形状。举一个极端但真实的变式:假设 reward 每步 -0.01(时间成本),出口奖励 +1。若 γ=0.99,绕远路慢慢晃也可能划算(远处的 +1 还很值钱);若 γ=0.9,远处的 +1 被压到 0.35 倍左右,智能体会拼命找近路。同一个环境,γ 不同,"最优"的含义就不同。反过来,奖励塑形时要与 γ 联合设计:给了一个稀疏的终点奖励 +1,又把 γ 设成 0.5,等于告诉智能体出口根本不重要——它没有说谎,是你把目标写拧了。
💡 一个校准技巧:把"任务大概需要多少步能见到效果"估出来(记作 H 步),取 γ 使 1/(1-γ) 明显大于 H,比如 γ = 1 - 1/(5H)。迷宫直径 20 步,就取 γ≈0.99。反过来如果连终局奖励都几乎传不回来(第 4 章会讲这种"信用分配断裂"),先怀疑 γ 太小。
与后续章节的接口
记住三样东西往下走:符号 G_t 与它的递归式;"γ 决定有效视野"的数字直觉;"优化目标是回报的期望"这句话。第 2 章 V(s) 与 Q(s, a) 的定义就是"按策略走下去的 G 的期望",贝尔曼方程就是递归式的期望版本。第 3 章的 TD 误差 r + γV(s') - V(s),不过是对这个递归式两边做差。
- 回报:未来奖励的折扣和,是唯一的优化目标;单步奖励只是它的原料。
- 折扣因子:γ^k 是第 k 步之后奖励的权重,1/(1-γ) 给出有效视野长度。
- γ<1 同时解决无限任务发散、噪声折价两个问题,选择依据是任务的规划深度。
- 回报的递归式 G_t = R_{t+1} + γG_{t+1} 是贝尔曼方程的原型,务必手推一遍。