2.1 马尔可夫决策过程:五元组与马尔可夫性质
2.1 马尔可夫决策过程:五元组与马尔可夫性质
本节摘要:马尔可夫决策过程 MDP 用五元组 (S, A, P, R, γ) 描述一个决策问题:状态集、动作集、转移概率、奖励函数、折扣因子。它的地基是马尔可夫性质——未来的统计规律只由当前状态决定,与历史无关。本节讲清性质何时成立、何时被破坏、被破坏后怎么补救,再把第 1 章的"训练小狗"闭环逐件翻译进五元组。MDP 不是新东西,而是旧闭环的数学户口本。
一、为什么需要数学化
第 1 章我们用自然语言说"智能体观察状态、选择动作、获得奖励"。自然语言便于直觉,但没法推导:你无法对"长期表现好"这种话求导、取期望或证明收敛。要把强化学习从一门手艺变成一门可以计算的学问,第一步就是给"世界"一个严格的数学定义——这个定义就是 MDP。它要回答两个问题:世界有哪些可能的"样子"(状态空间与转移规律),以及"好"如何度量(奖励与折扣)。定义一旦立稳,后面所有算法都是在它上面解方程。
二、马尔可夫性质:记忆只有一步
马尔可夫性质:一个状态满足该性质,当且仅当
P(S_{t+1} | S_t) = P(S_{t+1} | S_0, S_1, ..., S_t)
也就是"知道现在,过去就不再提供额外信息"。注意它说的是统计等价,不是因果断言——物理世界里很多过程本来就有惯性,但只要你的状态定义把足够的信息装进去,条件分布就能变得只依赖当前状态。这条性质为什么重要?因为它是"价值只写成 V(s)"的前提。如果未来还依赖 t-1、t-2 时刻的事,价值就必须写成 V(s_t, s_{t-1}, ...),状态空间以组合数爆炸,一切递归方程全部作废。
看三组例子。棋盘游戏:状态是完整的棋盘局面加行棋方,马尔可夫性质天然成立——复盘历史没棋盘本身信息多。 Atari 游戏:单帧画面不满足性质(球的速度方向从一帧看不出来),把连续四帧堆叠成状态后就近似成立——DQN 正是这样处理的,第 4 章会再遇到它。机器人关节:真实关节有延迟与柔性,理想刚体状态不完全马尔可夫,工程上靠提高控制频率来缩小误差。规律是:马尔可夫性质很少天然成立,多是建模"做"出来的——把该记的记进状态,性质就回来了。
性质被破坏又无法扩状态时,问题升级为部分可观测 MDP(POMDP):智能体只能拿到观测 o_t 而非真实 s_t。补救思路有三:堆叠最近 K 帧观测当状态;维护信念状态(对真实状态的概率分布);循环神经网络自己从历史里提炼记忆。本教程主体仍限 MDP,但这个"现实不完美"的出口要知道在哪。
三、五元组:给世界办户口
S:状态集合,离散(棋盘局面)或连续(关节角度向量)。A:动作集合,同样可离散可连续。P:转移核,P(s'|s,a) 表示在 s 执行 a 后转到 s' 的概率;配 R:奖励函数,常写成 R(s,a) 或期望意义下的 R(s,a,s')。γ:折扣因子,1.2 节已经立过规矩。五元组齐了,"一个决策问题"就被完整定义——它本质上是一个带奖励的随机过程,外加一个等待被优化的策略 π(a|s)。
把第 1 章的小狗例子过一遍户口登记:S = {手伸出, 手未伸}(简化模型);A = {抬爪, 咬, 蹲着};P 大体确定(抬爪→你多半给零食并保持伸手;咬→你收手皱眉);R = {抬爪→+5, 咬→-3, 蹲着→0};γ=0.8。这只狗的大脑里在学什么?策略 π(抬爪|手伸出) 从随机摸索初值爬向接近 1,同时价值 V(手伸出) 从 0 爬向 +5 附近。一个真实问题就这样被五元组接住了。
再做一个正经的迷宫建模。3×3 网格,左上为起点,右下为出口:
# 3x3 迷宫 MDP 建模:动作上下左右,撞墙留原地 # 终点格 (2,2) 给 +1 并终止,其余每步 -0.04(鼓励走短路径) GAMMA = 0.9 ACTIONS = [(-1,0),(1,0),(0,-1),(0,1)] # 上、下、左、右 def is_wall(r, c): return not (0 <= r < 3 and 0 <= c < 3) def step(state, action): (r, c), (dr, dc) = state, action nr, nc = r + dr, c + dc if is_wall(nr, nc): # 撞墙:留原地 nr, nc = r, c s2 = (nr, nc) if s2 == (2, 2): # 出口 return s2, 1.0, True return s2, -0.04, False # 普通步 # 注意:这里转移是确定的 P(s'|s,a)=1;若想模拟打滑,可以以 0.8 # 概率走向目标格、0.1/0.1 概率滑向两侧垂直方向——那就是 IceLake 类环境
这份定义里藏着一个经典取舍:每步 -0.04 的"生活成本"。没有它,智能体会在原地打转刷步数(反正不罚);有了它,最优路径唯一且最短。奖励函数的每一项都要这样追问一遍"它在激励什么"。
四、转移图:把随机性画出来
MDP 的动态可以用展开树理解:每个节点是一个状态,从节点伸出的分支是动作,动作后接一个概率分支的"机会节点"(环境随机性落在这一层)。策略的职责是在决策节点上挑分支;价值的职责是给每个节点标一个"从这往后期望还能拿多少"的价格。下一节你会看到,这个"标价"操作有一个简洁的递归公式。
图:MDP 单步展开——决策节点与机会节点
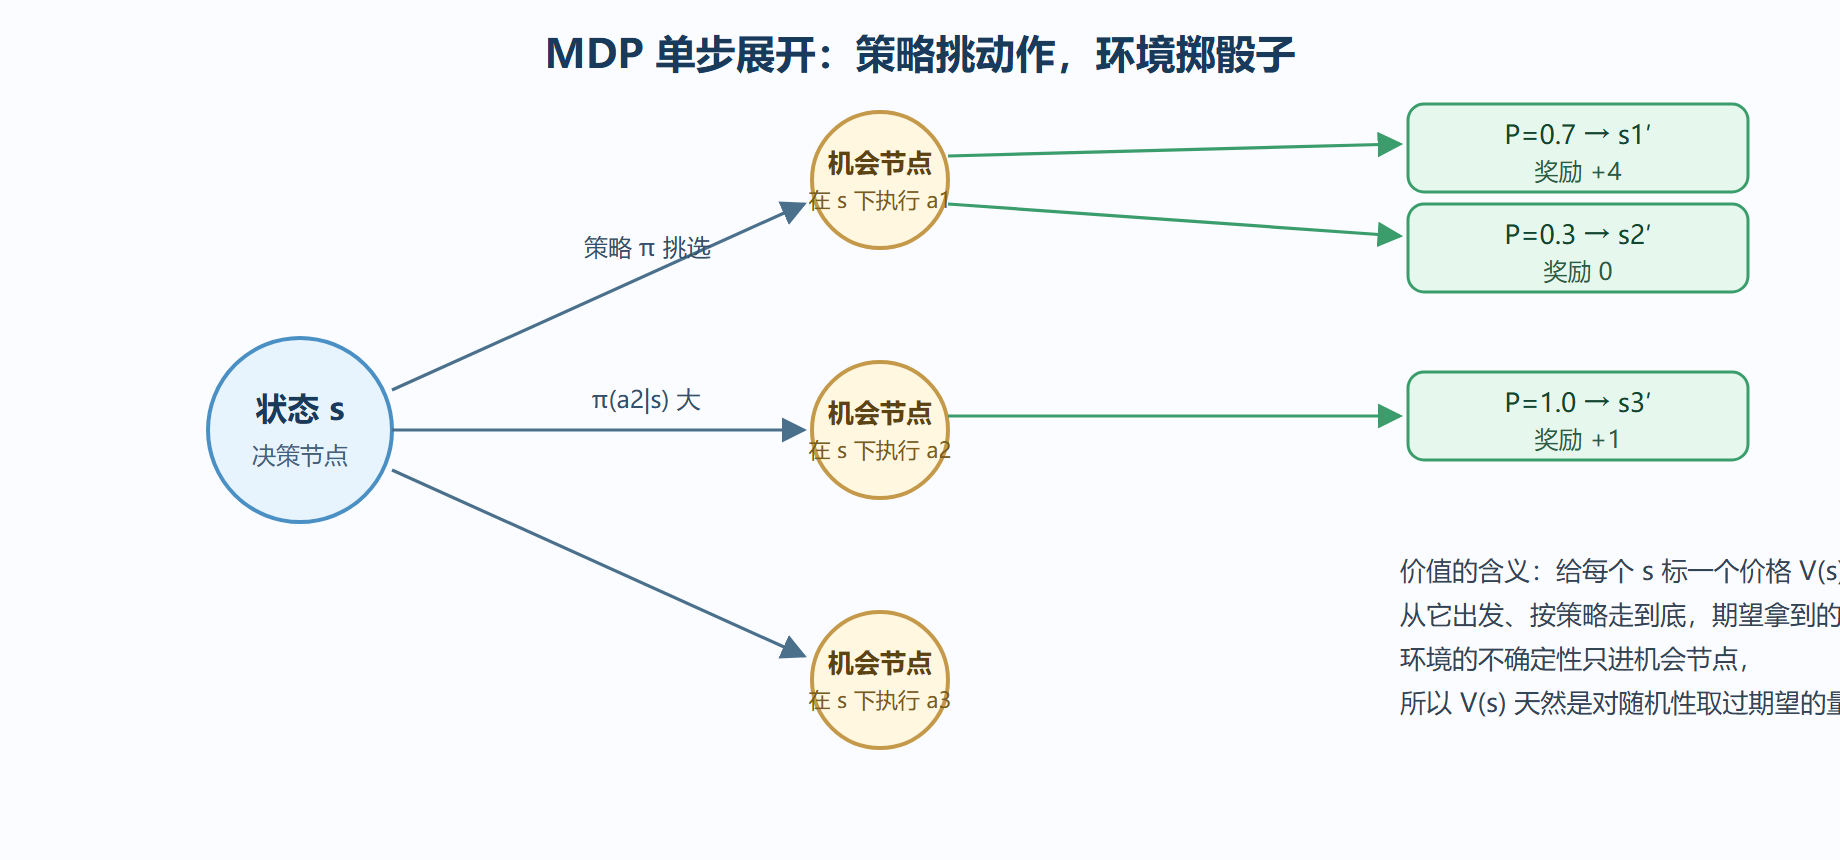
这张图值得多看一眼,因为它把"谁负责随机"切干净了:策略的随机性在决策节点(可能故意掷骰子来探索),环境的随机性在机会节点(躲不掉的物理噪声)。第 3 章 SARSA 与 Q-Learning 的分歧,正是对"下一状态该按哪个策略算期望"的不同处理。
本节要点回顾
- 马尔可夫性质是建模目标而非天然事实:信息装进状态,性质就成立。
- POMDP 是性质受损时的出口,堆帧与信念状态是常用补救。
- 五元组 (S, A, P, R, γ) 是决策问题的完整户口本,写不出五元组说明问题还没想清。
- 决策节点归策略管,机会节点归环境管,价值的期望是对后者取的。
- 转移确定的环境(如本节迷宫)是学习算法的首选试验台:先在确定性里看清机制,再放进噪声。
状态设计的四个检查问题
状态是五元组里唯一"完全由你设计"的元素,写完状态定义后用四个问题审它。问题一:这个状态能预测未来吗?把同环境下两条历史不同、状态标注相同的轨迹找出来,若它们此后的统计行为明显不同,状态缺信息——最典型的例子是购物推荐只用"当前购物车"不用"浏览历史",同样的购物车后续行为天差地别。问题二:状态里有冗余吗?冗余不是错误但稀释样本:两个强相关的字段让学习信号被重复计数,噪声跟着翻倍。问题三:状态是因果还是代理?用"被风吹歪的草"预测风可以,但环境变了草就失灵;能拿因果量(风速)别拿代理量(草的形变)。问题四:离散化的粒度经得起追问吗?每砍掉一档精度都问一句:会不会有两类需要不同动作的情形被并进了同一格?四个问题的成本是半小时,收益是省掉几轮"模型学不动"的无头排查——状态缺陷的症状(学得慢、策略抖、换环境即崩)与超参问题的症状高度相似,先审状态再动旋钮是纪律。