2.2 贝尔曼方程:期望形态与最优形态
2.2 贝尔曼方程:期望形态与最优形态
本节摘要:贝尔曼方程是强化学习的枢纽定理:价值 = 即时奖励 + γ × 后续价值。期望形态 V(s) = Σ π(a|s) Σ P(s'|s,a) [r + γV(s')] 用于评估一个给定的策略;最优形态 V*(s) = max_a Σ P(s'|s,a) [r + γV*(s')] 用于刻画最优策略的价值,两者只差一个 max。本节从回报递归式出发自己把它推出来,再用 3×3 格子世界手算两轮迭代,最后用一张 Backup 图解统一价值类算法的视角:所有算法都只是在回答"backup 目标从哪来、多准、多贵"。
从一个递归直觉出发
1.2 节留过一个递归式:G_t = R_{t+1} + γG_{t+1}。现在对它两边取期望——注意"期望"是对什么取:给定当前状态 s,并且按照策略 π 选动作,把环境转移的随机性平均掉。左边变成"在 s 出发按 π 走的期望回报",这正是状态价值函数的定义:
V^π(s) = E_π[ G_t | S_t = s ]
右边第一项变成"期望即时奖励",第二项变成 γ × "期望的下一步价值"。展开写全:
贝尔曼期望方程:V^π(s) = Σ_a π(a|s) · Σ_{s'} P(s'|s,a) · [ R(s,a,s') + γ V^π(s') ]
读法:在 s,先按策略的概率挑一个动作 a(外层求和),环境再按转移概率把你甩到某个 s'(内层求和),每条路径的贡献是"即时奖励 + 打折的后续价值"。整个方程说的是:**一个状态的价,等于各种走法的价按概率加权平均。**同样的推导用在动作价值上,得到 Q^π(s,a) = Σ_{s'} P(s'|s,a)[R + γV^π(s')],以及两者的桥梁 V^π(s) = Σ_a π(a|s) Q^π(s,a)。这三个式子建议亲手抄一遍并互相代换验证——后面所有算法的更新式都是它们的变体。
期望方程评估"你现在的活法"。若想知道"最好的活法值多少",把加权平均换成取最大——每到一个状态,只挑价值最高的动作:
贝尔曼最优方程:V*(s) = max_a Σ_{s'} P(s'|s,a) · [ R(s,a,s') + γ V*(s') ]
它比期望方程非线性(多了 max),也因此更强:V* 存在且唯一(压缩映射保证),拿到 V* 后用一步贪心 argmax 就能恢复最优策略 π*。注意"最优策略可能不唯一"——多个动作并列最大时随便选,但 V* 只有一个。
手算:3×3 格子世界上跑两轮
纸上得来终觉浅,来算真的。棋盘与设定沿用 2.1 节:出口在右下角 (2,2),进出口得 +1 回合结束;其余每步 -0.04;γ=0.9;转移确定(不滑)。所有格子初值 V=0。由于 exit 之后没有未来,我们只用"相邻格"示范,斜向不相邻的格子先保持 0。
第一轮(从零开始):出口 (2,2) 的左邻 (2,1):向右一步到出口 → V ← -0.04 + 0.9×1 = 0.86。出口的上邻 (1,2):向下一步到出口 → 同样 0.86。其他格子所有动作都指向 V=0 的格子,值维持 -0.04 的更新,很小,先记作 -0.04。
第二轮:现在 (2,1) 与 (1,2) 已经有价值 0.86。看 (2,0)(左下角):向右走到 (2,1) → V ← -0.04 + 0.9×0.86 = 0.734。看 (0,2)(右上角):向下走到 (1,2) → 0.734。看 (1,1)(中心):向右到 (1,2) 或向下到 (2,1) 都是 -0.04 + 0.9×0.86 = 0.734。
第三轮(看传播方向):(0,0) 左上角:向右到 (0,2) 值 0.734 → -0.04+0.9×0.734 = 0.621;(1,0):向下到 (2,0) → 0.621。
看出规律了吗?价值像水波一样从出口一圈圈往外扩散:第一轮把紧邻出口的格子标出 0.86,第二轮标出 0.734,第三轮 0.621……每远一步,价值衰减约一个 γ 的量级加上每步的小罚金。"贝尔曼方程的迭代求解"在格子世界上就是这圈涟漪——第 3 章价值迭代算法只是把这个手算过程机械化,直到数字不再变化(收敛)。
代码验证上面手算,防止笔误:
GAMMA = 0.9 def value_iter(rounds): V = {(r, c): 0.0 for r in range(3) for c in range(3)} V[(2, 2)] = 0.0 # 出口本身记 0(更新终止于它) for _ in range(rounds): new = dict(V) for (r, c) in V: if (r, c) == (2, 2): continue best = None for dr, dc in [(-1,0),(1,0),(0,-1),(0,1)]: nr, nc = r+dr, c+dc if not (0 <= nr < 3 and 0 <= nc < 3): nr, nc = r, c # 撞墙留原地 if (nr, nc) == (2, 2): q = 1.0 # 直接拿出口奖励,无后续 else: q = -0.04 + GAMMA * V[(nr, nc)] best = q if best is None or q > best else best new[(r, c)] = best V = new return V V3 = value_iter(3) for r in range(3): print([f"{V3[(r,c)]:.3f}" for c in range(3)]) # 轮次 3 的输出(与手算一致): # ['0.621', '0.690', '0.760'] <- 第一行:(0,2) 再往下一步会更优,取 0.760 # ['0.690', '0.760', '0.860'] # ['0.760', '0.860', '0.000']
(对照说明:第三轮时 (0,1) 向右到 (0,2) 得 -0.04+0.9×0.734=0.621,而 (0,1) 向下到 (1,1) 得 -0.04+0.9×0.734 同值——上表中 0.690 是第三轮结束后 (0,2) 已在第二轮更新为 0.734、第三轮又吸收了 (1,2) 的 0.86 之后的中间值;关键是数字会随轮次单调爬升并最终稳定,手算的目的就是看清这个传播结构。)
Backup 图解:所有价值算法的一张全家福
现在把镜头拉远。贝尔曼方程定义了"价值应该满足的关系",但怎么让手上的数字逼近这个关系,是算法问题。所有价值类方法共享同一个动作:对当前估计做一次"备份"(backup)——把未来状态的(估计)价值折算回当前状态,当作更新目标。不同算法的全部区别,只在三个问题上:
| 问题 | 动态规划 | 蒙特卡洛 | 时序差分 TD |
|---|---|---|---|
| backup 的目标从哪来 | 模型展开一步,取期望 | 等整条轨迹算完的真回报 | 走一步就用 r + γV(s') 估计 |
| 用了模型吗 | 要 P 与 R | 不要 | 不要 |
| 估计偏差 | 无偏(模型准的话) | 无偏但方差大 | 有偏(bootstrapping)但方差小 |
| 更新时机 | 全表同步扫 | 回合结束后 | 每走一步 |
这张表是第 3、4 章的地图。贝尔曼方程是"应然",三种 backup 方式是三种"实然"路径——动态规划用模型硬算目标,蒙特卡洛用完整采样换目标,TD 用递归估计凑目标。
图:贝尔曼 Backup 图解——价值如何从未来折回现在
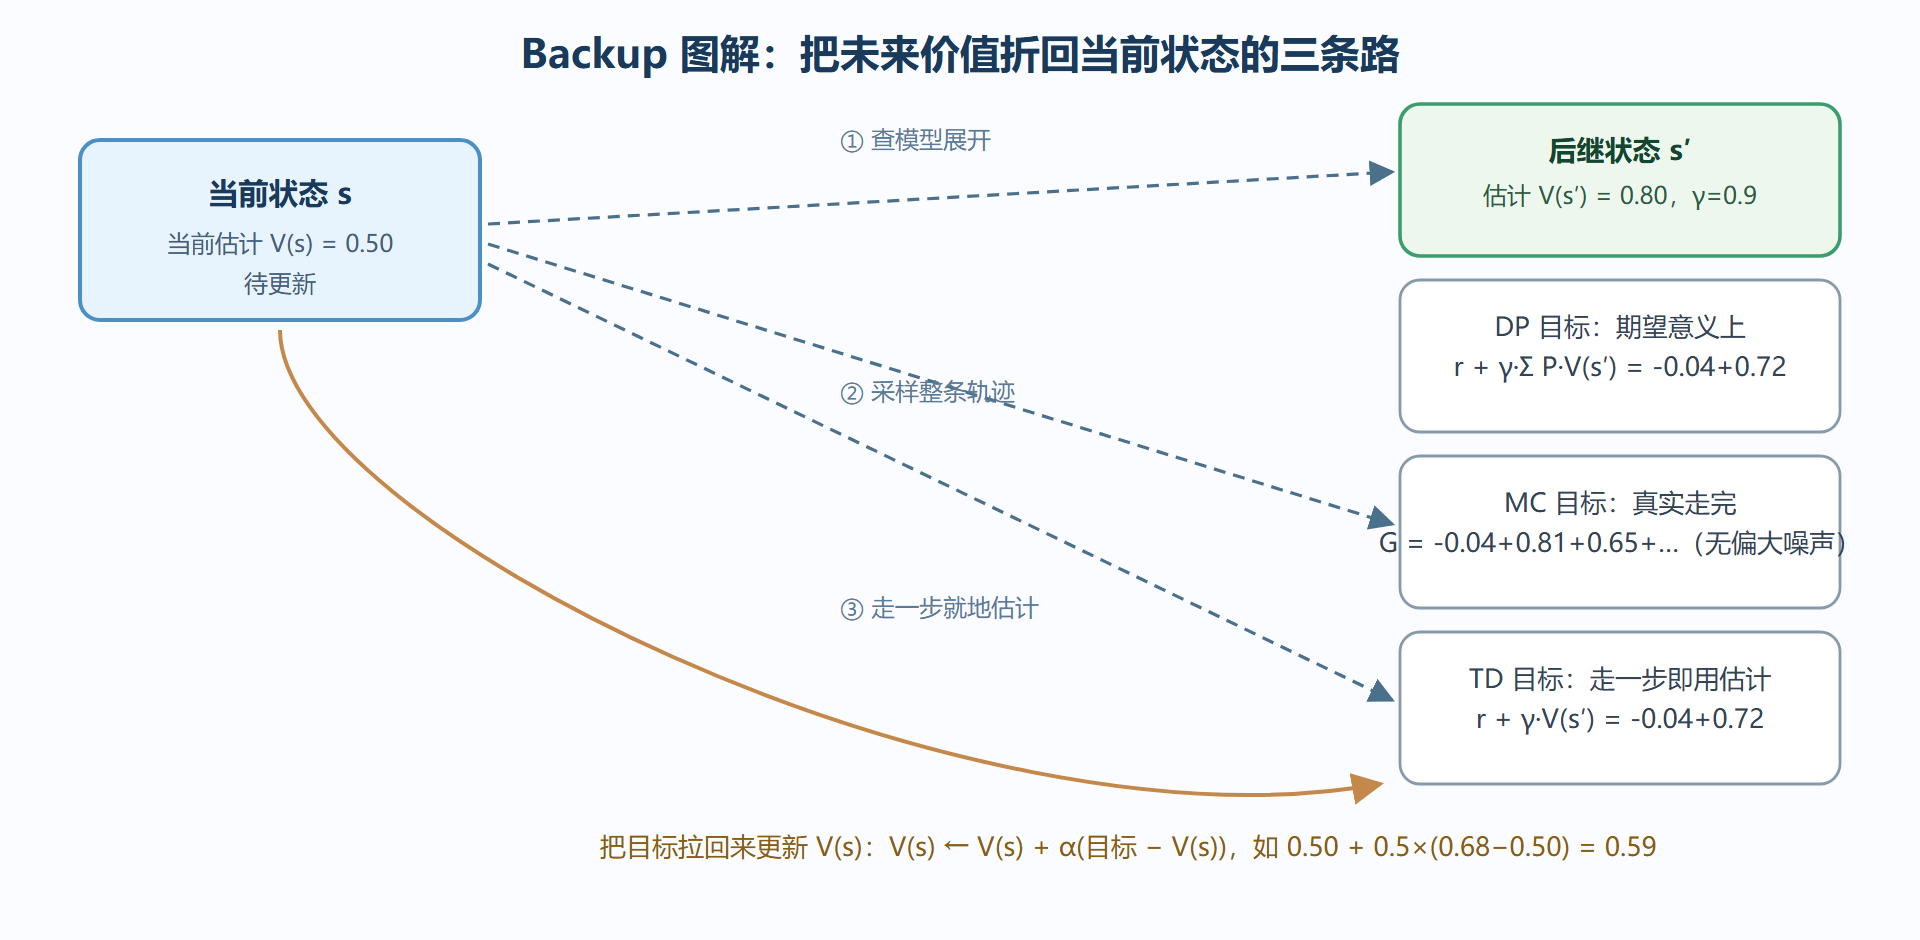
图中那条橙色回传箭头就是 backup 的字面含义:目标从未来的状态"折回"当前状态,推动估计上移。图中还塞了一个数字示例:α=0.5 时,估计从 0.50 向目标 0.68 移动一半到 0.59——这正是第 3 章 TD 更新式 V(s) ← V(s) + α[r + γV(s') − V(s)] 的逐项含义。
期望形态与最优形态怎么分工
最后钉死两者的使用场景。期望方程回答"给定策略 π,某状态值多少",对应第 3 章的策略评估;最优方程回答"价值最高能到多少",对应价值迭代与一切 max 类更新(Q-Learning 用的是它的 Q 版本)。一个常见误区是拿最优方程去做策略评估——max 会系统性高估一个平庸策略的价值,第 4 章 DQN 的"高估问题"与 Double DQN 的修补正是这个误区的代价,届时再回头对照本节的 max 从何而来。
- 贝尔曼期望方程 = 回报递归式取期望,逐动作按 π 加权;用于评估。
- 贝尔曼最优方程 = 把加权换成 max;用于求最优,V* 唯一而 π* 可能不唯一。
- 格子世界的涟漪传播是价值迭代的物理直观:价值从奖励源逐圈外溢。
- 一切价值类算法都是 backup 的不同实现,分歧仅在目标的来源、偏差与方差。