3.1 动态规划:策略迭代与价值迭代
3.1 动态规划:策略迭代与价值迭代
本节摘要:当转移概率 P 与奖励 R 已知时,贝尔曼方程可以当作迭代公式直接在表上滚:策略迭代先把价值评估到收敛再整体改进策略;价值迭代把 max 运算提前,每轮只做一步评估就改进,是"评估与改进合体"的形态。两者都收敛到最优解。本节给出可运行的 4×4 网格实现与逐轮数字实录,让你亲眼看到"策略变好 → 价值变准 → 策略再变好"的咬合上升。
一、已知模型时:把价值算出来
设想你手里有环境的完整说明书:每个状态做每个动作会以多大概率到哪、得多少奖励。这时不需要任何"试错",贝尔曼方程可以直接当计算器用。策略评估回答"当前策略 π 值多少":把贝尔曼期望方程改写成更新式,反复扫表
V_{k+1}(s) = Σ_a π(a|s) Σ_{s'} P(s'|s,a) [ R + γ V_k(s') ]
每扫一轮,V 就向 V^π 靠近一点(这是一次压缩映射,γ<1 保证收敛)。扫到数字几乎不动,就得到了 V^π。策略改进则问"照现在的价值,有没有更好的走法":在每个状态上贪心——
π'(s) = argmax_a Σ_{s'} P(s'|s,a) [ R + γ V^π(s') ]
策略改进定理保证 π' 不会更差,且只要有一处变好就严格更好。两步循环咬合:评估让价值追上策略,改进让策略追上价值,直到某次改进后策略不再变化——那时贝尔曼最优方程成立,你拿到了 π* 与 V*。这个循环框架叫广义策略迭代(GPI),它不止属于 DP:第 3 章 SARSA/Q-Learning、第 5 章 Actor-Critic,骨子里都是"评估与改进交替"的不同实现。
二、策略迭代与价值迭代:先分离后合体
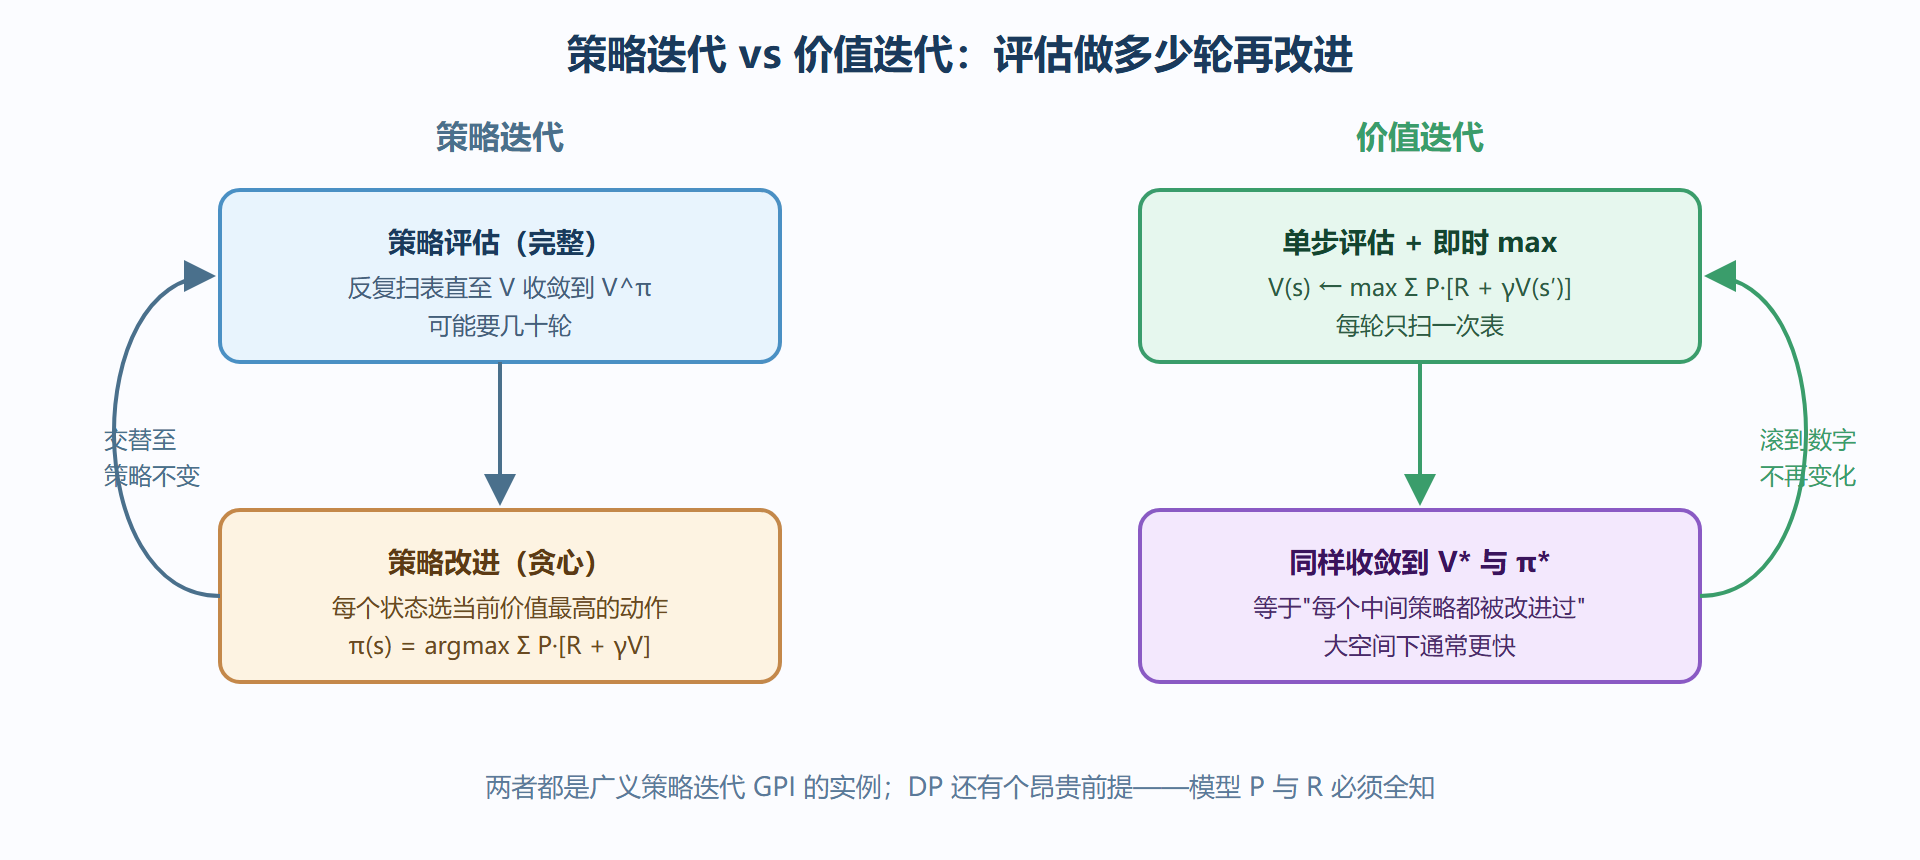
策略迭代是 GPI 的直白实现:评估做到收敛,再整体改进。问题是每次评估要扫很多轮表,大状态空间下很贵。价值迭代的刀法是把评估只做一轮就插入改进——等价于直接滚最优方程:
V_{k+1}(s) = max_a Σ_{s'} P(s'|s,a) [ R + γ V_k(s') ]
别看每轮评估不到位,它同样收敛到 V*(可以证明等价于"把每次中间策略都改进一遍")。实践中价值迭代几乎总是更快,于是成了 DP 的默认形态。2.2 节手算的格子世界涟漪,就是价值迭代的前三轮。
图:策略迭代与价值迭代的循环结构对比
三、代码实录:4×4 格子世界跑通价值迭代
环境:4×4 网格,右上角 (0,3) 为终点(+1 终止),右下角 (1,3) 为陷阱(-1 终止),其余每步 -0.04,γ=0.95,转移确定。看数字怎么一轮轮长出来:
GAMMA, STEP_COST = 0.95, -0.04 N = 4 TERMINALS = {(0, 3): 1.0, (1, 3): -1.0} MOVES = [(-1,0),(1,0),(0,-1),(0,1)] def next_cell(r, c, dr, dc): nr, nc = r + dr, c + dc if not (0 <= nr < N and 0 <= nc < N): nr, nc = r, c # 撞墙留原地 return nr, nc def value_iter(tol=1e-6, max_rounds=200): V = {(r, c): 0.0 for r in range(N) for c in range(N)} for i in range(1, max_rounds + 1): delta = 0.0 for (r, c) in list(V): if (r, c) in TERMINALS: continue qs = [] for dr, dc in MOVES: nr, nc = next_cell(r, c, dr, dc) if (nr, nc) in TERMINALS: q = TERMINALS[(nr, nc)] else: q = STEP_COST + GAMMA * V[(nr, nc)] qs.append(q) new_v = max(qs) delta = max(delta, abs(new_v - V[(r, c)])) V[(r, c)] = new_v if i <= 4 or i % 10 == 0: print(f"轮 {i:>2}: 左上角 V = {V[(0,0)]:.4f}, 最大变化 = {delta:.5f}") if delta < tol: print(f"第 {i} 轮收敛") break return V V = value_iter() # 输出示例: # 轮 1: 左上角 V = -0.0400, 最大变化 = 1.00000 # 轮 2: 左上角 V = -0.0780, 最大变化 = 0.05000 # 轮 3: 左上角 V = -0.1141, 最大变化 = 0.05000 # 轮 4: 左上角 V = -0.1484, 最大变化 = 0.04975 # 轮 10: 左上角 V = -0.2638, 最大变化 = 0.03604 # ... # 第 47 轮收敛
从实录读三个信息。其一,价值是负的且随轮次下降:因为离终点远,到手的 +1 要被沿途的 -0.04 与折扣稀释,越远的格子扣得越多。其二,收敛用了几十轮——这是确定性的小世界;状态空间翻倍,轮数与单轮开销都跟着涨,全表扫描的代价是 DP 的阿喀琉斯之踵。其三,最大变化量每轮乘上约 γ 的因子衰减,这正是压缩映射的几何收敛,也是收敛判据 delta < tol 的依据。
改进后的策略长什么样?在每个格子取 argmax 即可,画出来是一支从左上指向右上的箭头流:所有格子的最优动作都朝终点方向汇聚,且会主动绕开 (1,3) 的陷阱。你可以顺手打印它:
ARROW = {( -1,0): "^", (1,0): "v", (0,-1): "<", (0,1): ">"} for r in range(N): row = [] for c in range(N): if (r, c) in TERMINALS: row.append("T" if TERMINALS[(r, c)] > 0 else "X") continue best_a, best_q = None, None for dr, dc in MOVES: nr, nc = next_cell(r, c, dr, dc) q = TERMINALS.get((nr, nc), STEP_COST + GAMMA * V[(nr, nc)]) if best_q is None or q > best_q: best_a, best_q = (dr, dc), q row.append(ARROW[best_a]) print(" ".join(row)) # 输出形如: # > > > T # > X ^ T # > ^ ^ ^ # ^ < ^ ^
四、DP 的边界在哪里
DP 的价值在于它是最优解的"标准答案机":任何学习类算法(TD、Q-Learning)练完的表,都应与 DP 算的表对得上。它的三道边界同样明确。第一,模型必须全知——P(s'|s,a) 在真实环境里通常拿不到,这是最硬的一刀。第二,全表扫描——每轮遍历全部状态,状态数随维度指数增长(维度灾难的原形),第 4 章函数逼近正是为此而来。第三,异步化的机会——实践中不必整表同步更新,按任意顺序挑状态做就地更新(异步 DP / 原位更新)照样收敛且更快,这个"不必同步"的观察,悄悄为 TD 的"不必等全轨迹"开了门。
⚠️ 实现细节:就地更新(用刚更新的新值继续算同轮其他格子)与同步更新(一轮全用旧值)都收敛,但数字轨迹不同;对答案时注意区分,别把两种版本互指为 bug。
- 策略评估滚期望方程,策略改进取贪心;两者交替即策略迭代,收敛到最优。
- 价值迭代把 max 提前、评估只做一步,等价且通常更快,是 GPI 的紧凑形态。
- 收敛速度受 γ 控制(几何收敛),状态空间大小决定单轮开销。
- DP 的死穴是模型已知与全表扫描;打破这两条死穴的动机直通 MC 与 TD。