3.2 蒙特卡洛方法:用整条轨迹估计价值
3.2 蒙特卡洛方法:用整条轨迹估计价值
本节摘要:模型未知时,价值可以从经验里统计出来:让智能体跑很多条完整轨迹,把"经过状态 s 的那些轨迹的回报"取平均,大数定律保证这个平均收敛到真值 V(s)。这就是蒙特卡洛(MC)方法。本节讲清两种计数口径(首次访问与每次访问)、增量式平均的实现、MC 控制怎么配合 ε-软策略,最后用一张对照表把 DP 与 MC 的优缺点摆在一起,为时序差分的登场清场。
换个思路:不建模,直接采样
DP 的两道死穴——要模型、要全表扫描——蒙特卡洛全部绕开。它的哲学朴素到近乎偷懒:想知道从 s 出发平均能拿多少回报?那就真的从 s 出发跑 N 次,把每次的回报记下来求平均。大数定律站在这一边:只要每个状态的访问次数趋于无穷、样本相互独立,样本均值就收敛到期望回报 V(s)。不需要 P,不需要 R,只需要能与环境交互。代价也直白:你必须等一条轨迹走完才有第一个样本——这就是 MC 的"等回合"属性,任务越长,学习信号越稀疏。
一、两种口径与增量实现
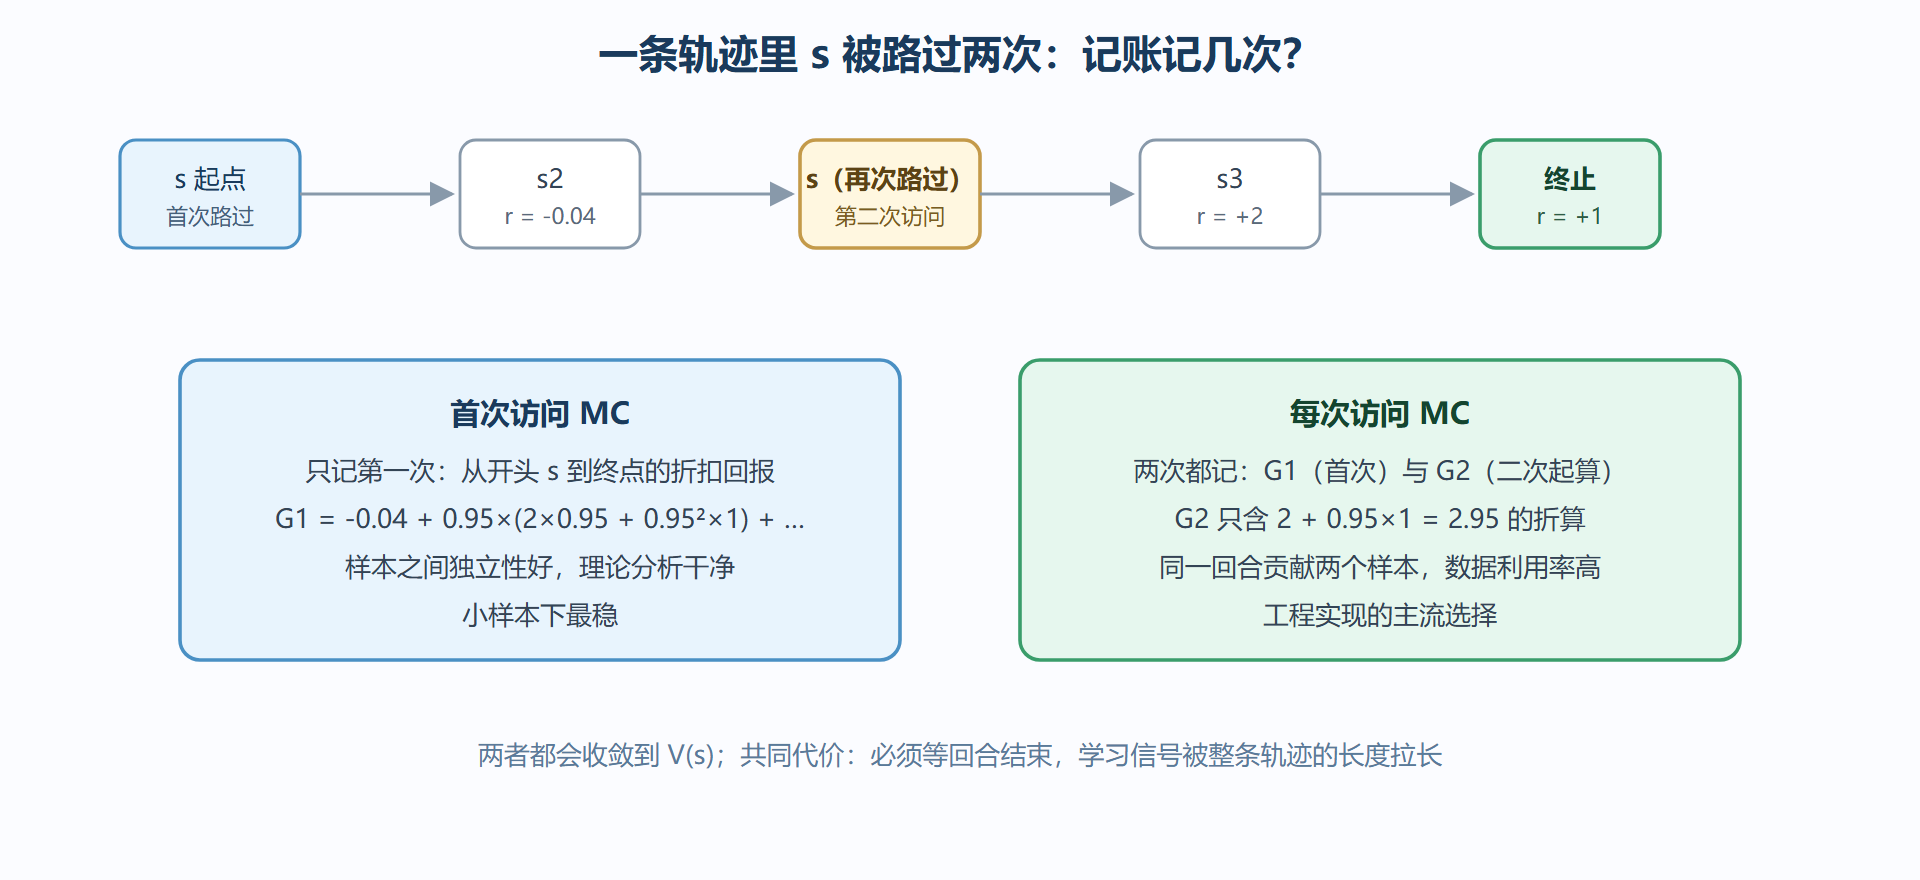
一个回合里状态 s 可能被经过多次。首次访问 MC 只取每回合中第一次路过 s 之后的回报计入平均;每次访问 MC 把每次路过都计入。两者在"访问次数趋于无穷"时收敛到同一个 V(s),小样本下行为略有差别,工程上常选后者(数据利用率高)。实现上没人真的存历史列表,都用增量式平均:
V(s) ← V(s) + (1/N(s)) · (G − V(s))
N(s) 是 s 到目前为止被统计的次数。把它看得再仔细些:当 N(s)=1 时 V 直接等于首样本;N(s) 增大后每条新样本只挪动 1/N 的比例。若把 1/N 换成常数 α,就成了"滑动平均"——旧样本被遗忘、新样本权重固定,在非平稳环境(策略本身在变,导致回报分布漂移)里反而更合理。这个 α 形式正是第 3 章 TD 更新式的外壳,MC 在这里已经摸到了 TD 的门环。
把整套流程写成代码,还是那个 4×4 网格世界,但这次我们不告诉智能体任何模型,只允许它交互:
import random GAMMA, STEP_COST, N = 0.95, -0.04, 4 TERMINALS = {(0, 3): 1.0, (1, 3): -1.0} MOVES = [(-1,0),(1,0),(0,-1),(0,1)] def env_step(r, c, a): dr, dc = MOVES[a] nr, nc = min(N-1, max(0, r+dr)), min(N-1, max(0, c+dc)) if (nr, nc) in TERMINALS: return nr, nc, TERMINALS[(nr, nc)], True return nr, nc, STEP_COST, False def run_episode(eps): """ε-greedy 随机策略跑一整条轨迹,返回 (状态,回报) 的首次访问列表""" r, c = 2, 0 # 左下角出发 traj = [] while (r, c) not in TERMINALS: if random.random() < eps: # ε 概率乱走(探索) a = random.randrange(4) else: # 否则按当前价值贪心 a = max(range(4), key=lambda k: Q.get( ((r, c), k), 0.0)) nr, nc, rew, done = env_step(r, c, a) traj.append(((r, c), a, rew)) r, c = nr, nc if done: break # 从后往前算折扣回报 G, ret = 0.0, [] for (s, a, rew) in reversed(traj): G = rew + GAMMA * G ret.append((s, G)) return list(reversed(ret)) Q, counts = {}, {} random.seed(7) for ep in range(1, 30001): eps = max(0.05, 1.0 - ep / 20000) # 探索率线性衰减 for s, G in run_episode(eps): # 每次访问口径 counts[s] = counts.get(s, 0) + 1 alpha = 1.0 / counts[s] Q[(s, None)] = Q.get((s, None), 0.0) + alpha * (G - Q.get((s, None), 0.0)) for r in range(N): print([f"{Q.get(((r,c),None),0):.2f}" for c in range(N)]) # 30000 回合后的典型输出(对照 3.1 价值迭代的答案,方向与量级一致): # ['-0.38', '-0.29', '-0.16', '0.00'] # ['-0.47', '0.00', '-0.05', '0.00'] <- 中间 (1,1) 等格子样本少, 估计噪声明显 # ['-0.62', '-0.75', '-0.90', '0.00']
对照 3.1 的 DP 答案能读出 MC 的性格:趋势正确,但每个格子都带着采样噪声——有的格子样本只有几百条,估计上下抖动明显;若把回合数加到十万级,表格会继续贴向 DP 的精确值。这就是"无偏但高方差"的具体长相。
二、MC 控制:让平均变成策略
上面的代码其实已经混进了控制:先用当前 Q 贪心选动作,再用新数据修正 Q,Q 变了策略自动跟着变——又是广义策略迭代的影子。但 MC 控制有一个独有的理论前提:每个状态-动作对必须被无限次访问,否则没被踩过的格子永远停在初值。贪心策略办不到这一点(0 概率踩差格子),于是采用 ε-软策略:任何动作至少以 ε/|A| 的概率被选中。实践中配合 ε 衰减:早期大 ε 保证覆盖,后期小 ε 让性能逼近贪心。另一个实操要点是"探索起点"(exploring starts):随机从各状态出发开回合,同样能保证覆盖,但对真实任务常不可行,所以 ε-软是主流。
MC 相对 DP 还有一个隐性优势值得点名:它是从经验分布学习的。若环境的真实转移与你的模型不一致,DP 会精确地收敛到错误答案;MC 只对实际发生过的转移负责,模型误差被自动排除。这个"数据说话"的性格,让它成为无模型方法的开山。
图:首次访问与每次访问——同一轨迹的两种记账法
三、DP 与 MC 对照:一张表看清两条路线
| 维度 | 动态规划 | 蒙特卡洛 |
|---|---|---|
| 模型需求 | 必须已知 P 与 R | 完全不需要 |
| 更新时机 | 每轮全表同步扫 | 回合结束后才更新 |
| 估计偏差 | 无偏(模型正确时) | 无偏(用的是真实回报) |
| 方差 | 无(确定性计算) | 高(整条轨迹的随机性全叠加) |
| 状态覆盖 | 天然全表 | 靠 ε-软策略或探索起点 |
| 可扩展性 | 状态空间指数爆炸即死 | 大空间可行但要海量交互 |
| 收敛对象 | 精确 V*(模型对时) | 经验分布下的 V |
两个"无偏"背后是两种完全不同的痛苦:DP 的风险在模型本身可能不准,MC 的风险在方差让学习信号被噪声淹没。把两者的优点各取一块——像 MC 一样不需要模型、像 DP 一样走一步就更新(而不是等回合)——这个念头就是时序差分学习。第 3 章开头你会看到,TD 一步更新用到的 r + γV(s'),正是把本节增量式的"G"换成了一个估计值:方差骤降,代价是引入偏差(自举)。偏差换方差,是无模型强化学习的主旋律。
- MC 估计 = 同一状态多回合回报的经验平均,大数定律背书,无模型、无偏。
- 首次访问与每次访问两种口径同收敛,后者数据利用率更高。
- 增量式平均把 1/N 换成常数 α 就成了滑动平均,是 TD 更新式的外壳雏形。
- MC 控制必须配 ε-软策略保证覆盖;性能与覆盖的张力由 ε 衰减调节。
- MC 的软肋:高方差、必须等整条轨迹、稀疏样本格子的估计抖动明显。