3.4 SARSA 与 Q-Learning:同策略与异策略
3.4 SARSA 与 Q-Learning:同策略与异策略
本节摘要:把 TD 预测升级为控制(边学边选动作),更新目标有二选一:SARSA 用"接下来真的会执行的动作"的 Q 值,Q-Learning 用"下一状态里最优动作"的 Q 值。前者叫同策略(on-policy),学的就是做的;后者叫异策略(off-policy),学的是贪心理想、做的却带着探索。这个一字之差在悬崖行走上表现为两种性格:SARSA 保守绕远,Q-Learning 激进贴边。本节把两种更新式、悬崖实验和各自的适用场景一次讲透。
一字之差,两种性格
控制问题的标准配方是广义策略迭代:用当前策略采数据,用数据改价值,用价值改策略。TD 家族把这三件事揉进每一步交互。揉法在"更新目标"处分岔。SARSA 的名字就是它的数据需求——State, Action, Reward, next State, next Action 五元组,更新式:
Q(s, a) ← Q(s, a) + α [ r + γ Q(s', a') − Q(s, a) ]
注意 a' 是行为策略接下来真的会选的动作——包含探索时乱选的那一下。Q-Learning 的更新式:
Q(s, a) ← Q(s, a) + α [ r + γ max_{a'} Q(s', a') − Q(s, a) ]
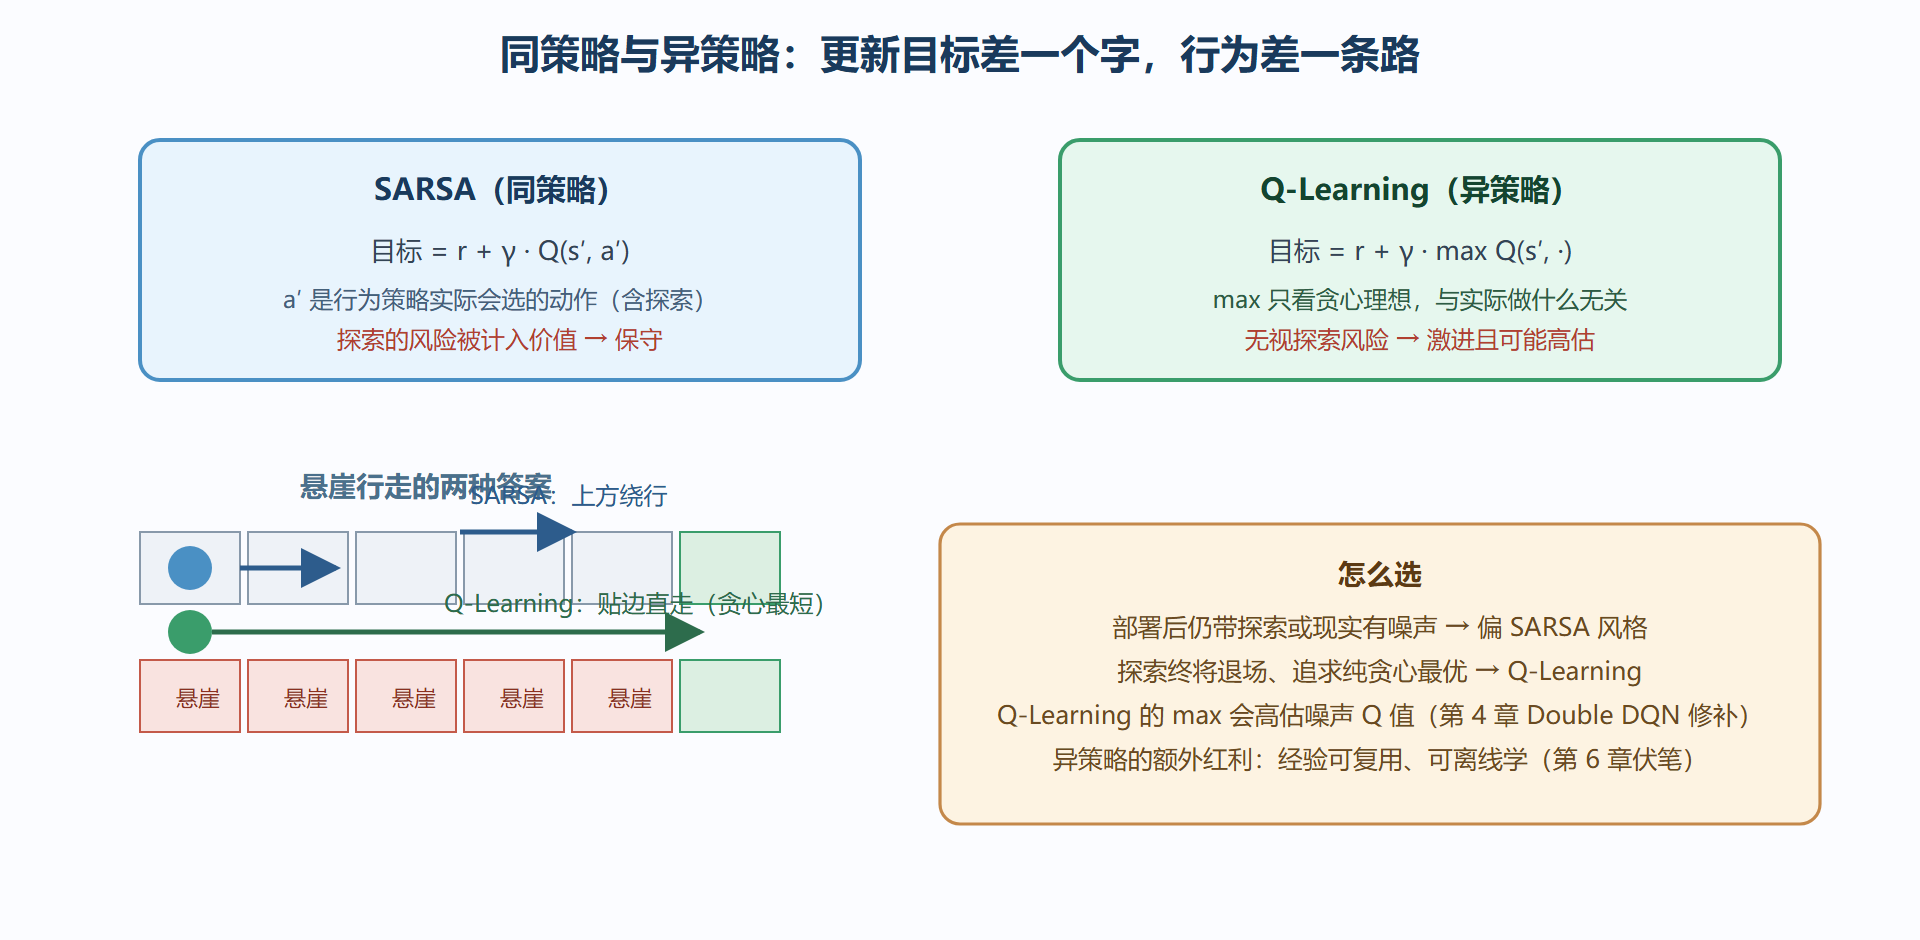
目标里是 max:不管你接下来是否探索,我更新的是"假如从 s' 开始贪心,值多少"。SARSA 评估"我现在这套带探索的行为",Q-Learning 评估"探索收敛后的纯贪心策略"。前者叫同策略(on-policy),后者叫异策略(off-policy)。
性格差异在带危险的任务上一览无余。悬崖行走(Cliff Walking):网格下方一排悬崖格,踩上去 -100 并回起点,正常每步 -1,右下角是出口。Q-Learning 学出的最优路径贴着悬崖边缘走——理论上最短,因为它评估的是贪心策略,而贪心策略不会乱踩悬崖。SARSA 学出的路径离悬崖远远的——因为它把"ε 概率乱走可能坠崖"这件事算进了 Q(s',a') 的期望里,探索的代价被计入价值,于是宁绕三格不冒一步险。两种答案都"对":Q-Learning 回答"贪心执行的最优路线",SARSA 回答"带着探索行为执行的期望最优路线"。部署时若你的执行策略仍带探索(或现实中总有手滑),SARSA 的表往往更稳;若探索终会退场,Q-Learning 的表更优。
图:SARSA 与 Q-Learning 的备份目标对比
两份伪代码,盯住差别那一行
两份伪代码几乎逐行相同,差异只在更新目标的写法。先把共同骨架摆出来,再对照差异行:
# 共同骨架(伪代码) # 初始化 Q 表为 0 # for 每个回合: # s = env.reset() # 选 a(epsilon-greedy 基于 Q) # while 未终止: # 执行 a,得到 r, s2, done # 【差异行:更新目标 target】 # 选 a2(epsilon-greedy,仅 SARSA 需要) # s, a = s2, a2(SARSA 直接复用 a2;Q-Learning 重新选)
# SARSA 的差异行:target = r + gamma * Q[(s2, a2)] * (0 if done else 1) # Q-Learning 的差异行: # target = r + (0 if done else gamma * max(Q[(s2, k)] for k in actions))
Q-Learning 不需要先选 a2 就能更新——它只看下一状态的 max;SARSA 必须先选出 a2 才有更新目标,选完还得真的去执行它(数据五元组自洽)。这个结构性差别衍生出工程上的一个大红利:异策略可以把"行为"与"评估"彻底解耦——行为用旧策略或随机数据,评估的目标函数始终指向贪心。经验回放(第 4 章 DQN 的第一台稳定器)在理论上之所以成立,正因为 Q-Learning 是异策略:回放池里的旧数据是旧策略产生的,但更新目标只与贪心 max 有关,不要求"数据来源策略 = 当前学习策略"。SARSA 没有这个豁免权,硬上回放池会学错对象。
off-policy 收敛的小字条款
Q-Learning 被称为"收敛到 Q*"的条件值得原文级复述:所有状态-动作对持续被访问,且学习率按 Robbins-Monro 条件衰减(Σα = ∞ 而 Σα² < ∞)。"持续访问"靠 ε-软行为策略保证;"α 衰减"实践中常被偷懒成固定小 α——多数任务也够用,但在噪声大的环境里固定 α 会让 Q 值在真值附近永不停歇地抖。另外提醒一次 max 的高估问题:Q 值含噪声时,max 操作系统性挑出偏大的噪声(E[max(X1,X2)] ≥ max(E[X1],E[X2])),目标被抬高,且自举会让高估自我放大。这正是第 4 章 Double DQN 的病根,此处先记账。
⚠️ 实现高频 bug:done 分支忘了清零未来项。termination 与 time-limit 截断要区分(1.3 节的规矩在这里结账)——把截断当终止处理,价值函数会系统性地把"长命任务"学贬值。
- SARSA 目标含 a'(真实下一步动作),评估带探索的行为,风险敏感、路径保守。
- Q-Learning 目标是 max,评估贪心理想,路径激进;异策略身份让经验回放合法。
- 悬崖行走是区分两者的标准考题:绕行与贴边,都对,取决于执行策略是否带探索。
- max 的高估偏置从本节埋下伏笔,第 4 章兑现为 Double DQN。
- done 清零未来项是 TD 类实现的第一大 bug 源。
悬崖行走的数字对照:两条路径的账本
用具体数字把"保守与激进"量化。6×4 的悬崖网格,每步 -1,坠崖 -100 并回起点,出口在右下。ε=0.1 的探索率下,两条学到的路径对比如下。贴边路径(Q-Learning 的贪心解):正常走 14 步,总代价约 -14;但每一步都有 0.1 的探索概率坠崖,期望代价还要加上 0.1×(-100)×14 步的暴露量级——一次坠崖的期望损失就把十几步的路费吃光,长期运行的期望回报反而难看。上绕路径(SARSA 的解):多走 4 步,路费 -18,但坠崖暴露的格子数从 12 降到 0,探索风险几乎为零。两本账摆在一起,"哪个更优"就不再是算法问题而是运营问题:执行策略带探索(训练期、或现实中的手抖),SARSA 的账赢;探索终将关掉且执行精确,Q-Learning 的账赢。还有一个值得记录的中间态:ε 从 0.1 衰减到 0.01 的过程中,SARSA 的路径会逐渐下沉贴边——它对风险的估价跟着探索率走,探索退场,风险溢价也就退场。这提醒我们:同策略与异策略的差异不是"谁对谁错",而是"评估的对象里要不要包含探索行为本身"。