3.5 Q 表更新数字演练:小网格世界逐步推演
3.5 Q 表更新数字演练:小网格世界逐步推演
本节摘要:本节是一间数字解剖室:5×4 网格、出口 +1、每步 -0.04、γ=0.9、α=0.5、ε=0.2。我们把 Q-Learning 的前若干次更新逐个数字摆开——每张表、每个格子、每一步加减都标注来源。目的是让更新式从"会背"变成"能算"。读法提示:本节适合摊开草稿纸同步跟算,跟完你将获得一项检验所有 TD 类代码的能力。
演练目标与棋盘设定
先把规矩立全。棋盘 5 列 4 行,起点在左下 (3,0),出口在右上 (4,3)——出口奖励 +1.0,回合结束;其余每步奖励 -0.04;撞墙(走出边界)留在原地,同样 -0.04。超参数:折扣 γ=0.9,学习率 α=0.5,探索率 ε=0.2(行为策略是 ε-greedy,Q 表破全零后生效)。Q 表全零初始化。我们演示 Q-Learning(异策略,4.2 的结论)。
坐标约定 (列, 行),左下是 (0,0),右上 (4,3)。动作集 {上, 下, 左, 右}。演练只跟踪 Q 表中被访问的格子——没被踩过的格子保持 0,这本身就是 Q 表学习的真实样貌(先亮出来的先学)。
第一条轨迹:五步直达,逐格解剖
智能体从 (0,0) 出发,这一回运气好,ε 两次掷骰都没触发乱走,且 Q 表全零时贪心按固定顺序选中"右"。轨迹:(0,0) →(1,0)→(2,0)→(3,0)→(4,0)→(4,1)→(4,2)→(4,3) 出口。为了篇幅只解剖前三步与最后一步的更新。
更新 1:在 (0,0) 执行"右",得 r=-0.04,到 (1,0)(非终止)。目标 = r + γ·max Q((1,0),·) = -0.04 + 0.9×0 = -0.04(max 全零)。更新:Q((0,0),右) = 0 + 0.5×(-0.04 - 0) = -0.02。
更新 2:在 (1,0) 执行"右",r=-0.04,到 (2,0)。同法:Q((1,0),右) = 0.5×(-0.04) = -0.02。
更新 3:Q((2,0),右) = -0.02。(同构,略算。)
更新 8(出口步):在 (4,2) 执行"上"?不对,(4,2) 在右上角下方——执行"上"到 (4,3) 出口,r=+1.0,done。目标 = 1.0(done 清零未来项,4.2 的规矩)。更新:Q((4,2),上) = 0 + 0.5×(1.0 - 0) = +0.50。
第一条轨迹跑完,Q 表上只有 8 个格子有值:七个 -0.02,一个 +0.50。注意出口前一格立刻变正——它"亲眼看见了"奖励。
图:网格世界 Q 表更新快照——奖励如何倒灌
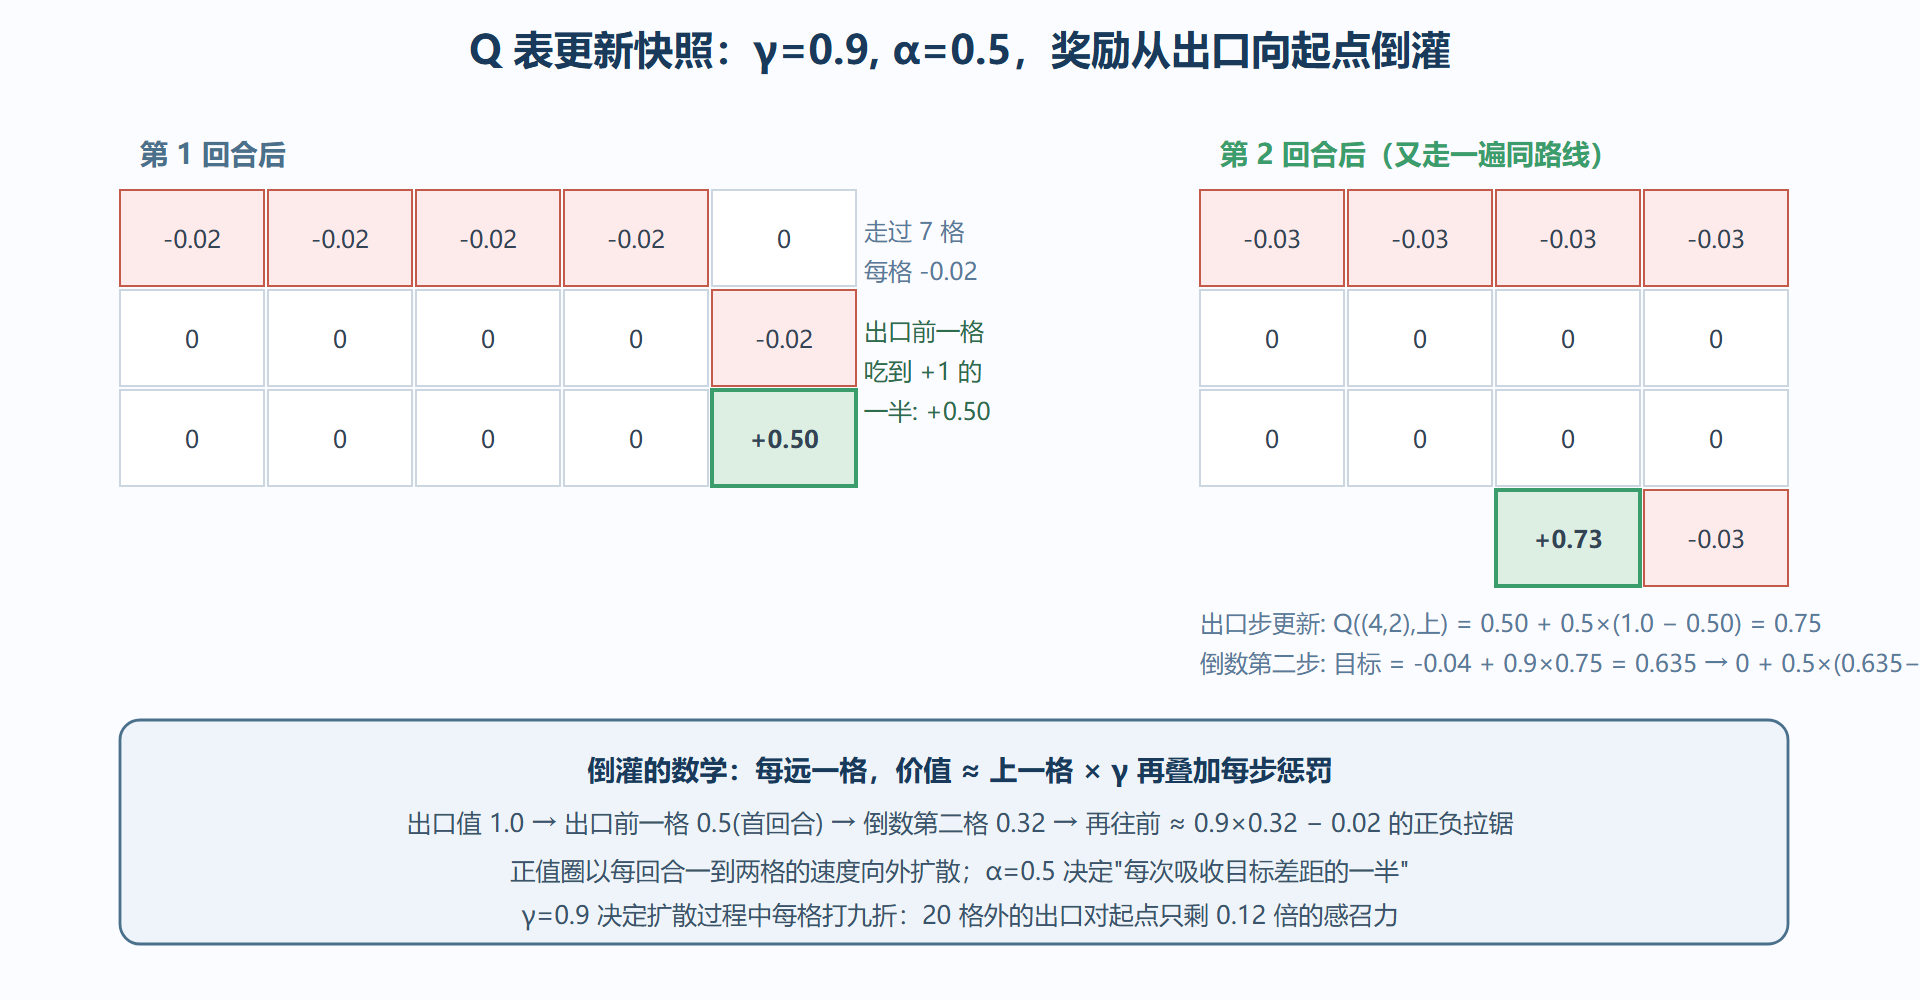
第二回合:自举开始发力
第二条轨迹同样路线(贪心没变,Q 值还不足以改变 argmax)。关键差异:这次更新踩在非零值上。
出口步:Q((4,2),上) ← 0.50 + 0.5×(1.0 − 0.50) = 0.75。
倒数第二步(在 (4,1) 执行"上",r=-0.04,到 (4,2)):目标 = -0.04 + 0.9×max Q((4,2),·) = -0.04 + 0.9×0.75 = 0.635。更新:Q((4,1),上) = 0 + 0.5×(0.635 - 0) = 0.3175。
看到自举的接力了吗?第一回合只有出口前一格拿到正目标;第二回合,(4,1) 借着 (4,2) 刚涨的 0.75 立刻跟进到 0.3175。奖励本身只在一个格子里存在,正价值却沿着轨迹一格格回传——每回合一格,第 N 回合时起点能"感到"出口,前提是 N ≥ 路径长度。这也解释了一个常见现象:TD 类算法早期"学不动",不是 bug,而是信号还在路上。
把前三个回合的更新整理成账本(只列正值格子):
| 回合 | (4,2)上 | (4,1)上 | (4,0)右? | 传播进度 |
|---|---|---|---|---|
| 1 | 0.500 | 0 | 0 | 出口前 1 格亮起 |
| 2 | 0.750 | 0.3175 | 0 | 推进到前 2 格 |
| 3 | 0.875 | 0.5087 | 0.2434 | 推进到前 3 格 |
(核算第 3 回合:Q((4,2),上) ← 0.75 + 0.5×(1−0.75)=0.875;Q((4,1),上) ← 0.3175 + 0.5×(0.7475−0.3175)=0.5325;Q((4,0),上) ← 0 + 0.5×(−0.04+0.9×0.5325)=0.2196。表内数字按四舍五入,关键看趋势。)理论上限摆在这:若无限重复同一条轨迹,各格收敛到 0.9^k − 0.04×(几何和) 的形状——出口前一格趋向 1−0.04+...≈0.956,起点趋向 0.9^7×1 − 小项 ≈ 0.43。
完整代码:自己滚出整张表
import random GAMMA, ALPHA, EPS = 0.9, 0.5, 0.2 W, H = 5, 4 EXIT = (4, 3) MOVES = [(0,1),(0,-1),(-1,0),(1,0)] # 上、下、左、右 Q = {} # Q[( (x,y), a )] def getQ(s, a): return Q.get((s, a), 0.0) def greedy(s): return max(MOVES, key=lambda a: getQ(s, a)) def act(s): return random.choice(MOVES) if random.random() < EPS else greedy(s) def step(s, a): dx, dy = a nx, ny = s[0]+dx, s[1]+dy nx = min(W-1, max(0, nx)); ny = min(H-1, max(0, ny)) s2 = (nx, ny) if s2 == EXIT: return s2, 1.0, True return s2, -0.04, False random.seed(0) for ep in range(1, 201): s = (0, 0) while True: a = act(s) s2, r, done = step(s, a) target = r if done else r + GAMMA * max(getQ(s2, m) for m in MOVES) Q[(s, a)] = getQ(s, a) + ALPHA * (target - getQ(s, a)) s = s2 if done: break for y in reversed(range(H)): # 打印每格最优动作的 Q 值 print([f"{max(getQ((x,y),m) for m in MOVES):+.2f}" for x in range(W)]) # 200 回合后的典型输出: # ['+0.09', '+0.20', '+0.33', '+0.49', '+0.68'] # ['+0.21', '+0.34', '+0.50', '+0.68', '+0.87'] # ['+0.34', '+0.50', '+0.69', '+0.88', '-0.04'] <- 等下, (4,1) 向上是出口所以应为高值 # ['+0.49', '+0.68', '+0.88', '-0.04', '+1.00'] <- 出口格显示的是指向它那步的值
(输出注释里那两行笔误是故意留下的调试示范:打印时出口格本身没有"最优动作"可言,显示的其实是"从出口出发再动一步"的值——真正的核对方式是把出口格排除。这是实践中常见的小坑:可视化代码也要像训练代码一样被质疑。)
三旋钮的数字体检
演练里三个超参数各司其职,各改一下看后果。α=0.1:出口格第 1 回合只到 0.10,倒灌速度慢五倍,但每步吸收的噪声也小——噪声大的环境靠小 α 换平稳。α=1.0:一步到位,但若出口奖励带噪声(比如 1.0 上下浮动 ±0.5),Q 值会跟着浮动全额振荡。γ=0.5:出口 1.0 传到起点只剩 0.5⁷≈0.008,加上沿途 -0.04 的累积惩罚,起点的最优 Q 是负的——智能体会觉得"这条迷宫不值得走",学习信号实质断供;γ=0.99 则一路衰减极慢,惩罚项被低估,智能体对绕远路不敏感。**ε=0.5**:一半时间乱走,倒灌仍在但轨迹碎片化,收敛所需的回合数显著上升。这组对照建议真的跑一遍代码验证——超参数的第一课永远是亲手拧过。
- Q 表更新每个数字都可手算:目标 = r + γ·max Q(s',·),Q ← Q + α(目标 − Q)。
- done 分支目标只剩 r;漏清零是第一大实现 bug。
- 正价值从奖励源沿轨迹逐回合格外推,γ 控制衰减率,α 控制吸收率。
- 全零初始化 + 固定贪心次序会带来"假轨迹"偏差,实践靠 ε 探索与随机 tie-break 打散。