5.1 REINFORCE:策略梯度定理
5.1 REINFORCE:策略梯度定理
本节摘要:REINFORCE 是策略路线的最小实现:跑完整条轨迹拿到回报 G,然后对每个 (s_t, a_t) 沿 ∇log π(a_t|s_t)·G_t 方向调参数——高回报轨迹上的动作概率被推高,低回报的被压低。策略梯度定理保证这个朴素规则的期望恰好等于期望回报的梯度。本节从直觉推出定理,给出完整算法与一个最小可跑实现,并说明它为何在连续动作上得心应手、为何方差大到必须等第 5.2 节来救。
一、换一条路线:直接调概率
价值路线(第 3 到 5 章)的完整流程是:估计 Q → 贪心取 argmax → 间接得到策略。两处别扭随之而来。其一,argmax 这一步只在离散动作上有定义——油门开度 0.73 与 0.74 哪个"最大"?对连续集合取最大需要另外的搜索,Q-Learning 的框架到这里就断了。其二,价值估计的精度要求其实是过度的:我们只需要知道哪个动作相对更好,却逼着自己把每个动作的绝对值都学准。策略路线一刀砍掉这两处别扭:把策略本身参数化 π(a|s;θ)——比如一个输出动作概率分布(离散)或均值方差(连续高斯)的网络——然后直接对"期望回报 J(θ)"做梯度上升:θ ← θ + α∇J(θ)。没有 argmax,没有价值函数,一步到位。
问题只剩一个:J(θ) 的梯度长什么样?期望里套着环境动态(不可导的黑箱),链式法则过不去。
二、策略梯度定理:把不可导的黑箱绕过去
定理的推导起点是一个替换:对"动作的分布"求梯度,有个恒等式
∇_θ π(a|s;θ) = π(a|s;θ) · ∇_θ log π(a|s;θ)
右边只涉及策略自身的对数导数,环境动态消失了。把 J(θ)(轨迹回报的期望)展开成"按策略采样的轨迹的回报之和",逐项代入恒等式,环境概率项在求梯度时全部落地为 log π 的项——最终得到策略梯度定理:
∇J(θ) = E_τ~π [ Σ_t ∇_θ log π(a_t|s_t) · G_t ]
读法直白到不像定理:**对轨迹上每个动作,把"该动作的对数概率对参数的敏感度"乘上"这次它挣到的回报",加起来就是调参方向。**G_t 大的动作被强力推高,G_t 为负的被推低。注意定理没要求环境可导、没要求价值函数,只要求策略本身对 θ 可导、且奖励不依赖 θ。
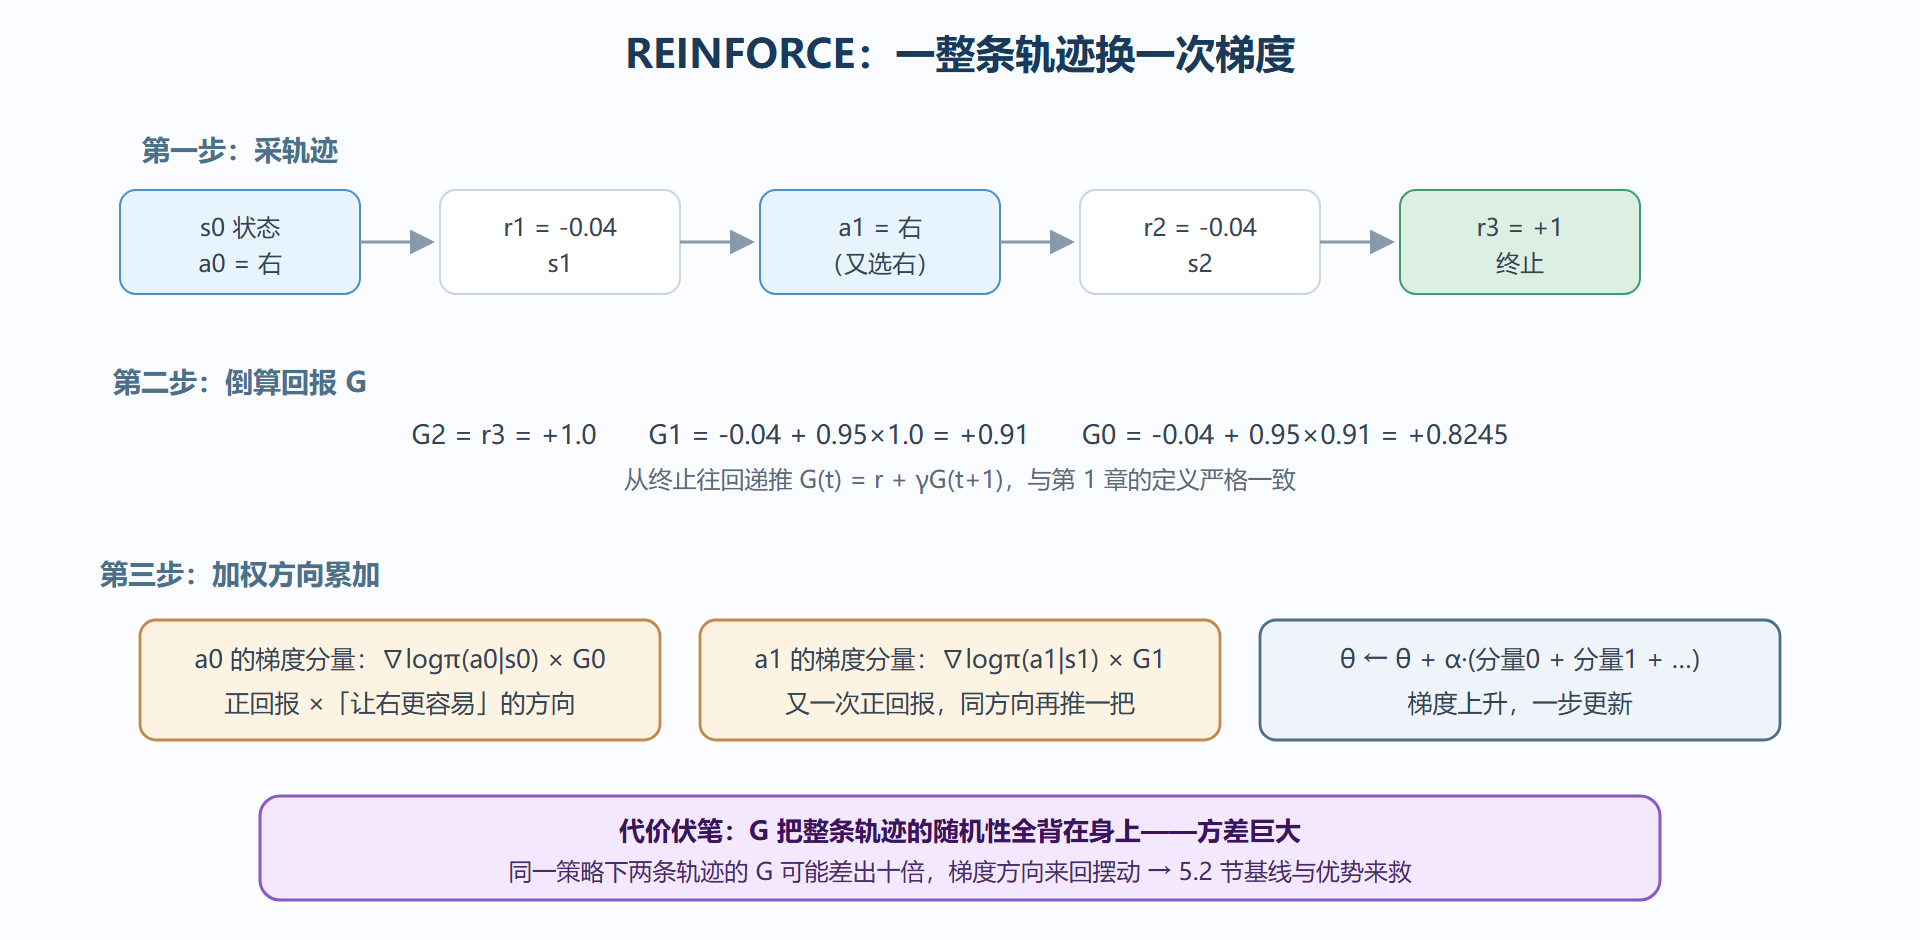
直觉再压一层:∇log π(a|s) 指向"让 a 更容易被选中的参数方向";G_t 是这次选 a 的"战绩"。定理说的是:把每个动作的战绩按其方向加权累加——赢面大的方向多走几步。这与生物学习的"效果律"(带来好结果的行为更常出现)惊人一致,也解释了为何这一族方法又叫"策略搜索中的爬山法"。
三、算法流程与最小实现
REINFORCE(蒙特卡洛策略梯度)的完整循环:
- 用当前策略 π(θ) 采一整条轨迹 (s_0,a_0,r_1,...,s_T);
- 从后往前算折扣回报 G_t;
- 对每个 t,算 g_t = ∇log π(a_t|s_t)·G_t,累加成梯度估计;
- 梯度上升更新 θ;回到第 1 步。
最小可跑版本(离散两动作、参数只有一个偏置,让你看穿全部机制):
import random, math random.seed(1) GAMMA = 0.95 # 策略:一个参数 theta 控制"动作 1 的概率":pi(1) = sigmoid(theta) # 环境:动作 1 有 0.8 概率得 +1,动作 0 有 0.4 概率得 +1(单步任务) def sample_action(theta): p1 = 1 / (1 + math.exp(-theta)) return 1 if random.random() < p1 else 0 def dlogpi(theta, a): p1 = 1 / (1 + math.exp(-theta)) return (1 - p1) if a == 1 else -p1 # d/dtheta log pi(a) theta = 0.0 for ep in range(1, 2001): a = sample_action(theta) G = 1.0 if random.random() < (0.8 if a == 1 else 0.4) else 0.0 theta += 0.1 * dlogpi(theta, a) * G # REINFORCE 更新 if ep % 400 == 0: print(f"回合 {ep}: theta={theta:+.3f} P(动作1)={1/(1+math.exp(-theta)):.3f}") # 典型输出: # 回合 400: theta=+0.282 P(动作1)=0.570 # 回合 800: theta=+0.624 P(动作1)=0.651 # 回合 1200: theta=+0.822 P(动作1)=0.695 # 回合 2000: theta=+1.010 P(动作1)=0.733
概率稳定在 0.7 附近而非 1.0——不是 bug。0.4 的动作也偶有正回报,零回报与正回报的拉锯把概率顶在"期望差距能支撑的位置";加大学习率或跑更多回合它会继续爬,但永远带着随机性。这个"策略天然是概率分布"的性质在对抗与部分可观测环境里是优点(混合策略均衡、掩盖意图),在需要精确执行的环境里是缺点(第 5 章的确定性策略来补)。
连续动作的适配顺手就能写出:让策略网络输出高斯分布的均值 μ(s;θ) 与固定方差 σ,log π(a|s) = −(a−μ)²/(2σ²) − log σ − 常数,∇log π 对 μ 的导数是 (a−μ)/σ²——"实际执行的动作离均值多远"就是梯度信号,一切照旧。对比价值方法在连续动作上"对每个连续取值打分再取最大"的困境,策略路线的适配成本低得多。这就是 4.1 节预告的答案:连续动作选择策略路线的第一理由。
图:REINFORCE 的一次更新——从轨迹到梯度
四、REINFORCE 的边界
三条硬边界,条条通向后续章节。第一,方差:G 的随机性让梯度估计抖动剧烈,小学习率学得慢、大学习率震荡——5.2 节基线与优势函数是正解。第二,样本效率:每次更新只消化一条轨迹就扔,且轨迹必须由当前策略产生(数据一过期梯度就有偏——on-policy 的枷锁),样本无法复用;第 4 章经验回放的红利在这里不能白拿,这个约束直接催生第 5 章 PPO 的"一批数据多轮小步更新"。第三,整轨迹等待:必须回合结束才能更新,长任务在线学习慢——5.3 节 Actor-Critic 换 TD 估计解决。三个补丁分别对应本章剩下两节与下一章,路线图清晰。
- 策略梯度定理把"环境不可导"绕成"策略自己可导":∇J = E[∇logπ · G]。
- G_t 是动作 a_t 的"战绩权重",正推高、负压低;期望等于真梯度,单样本噪声极大。
- 连续动作适配零成本(高斯策略),这是策略路线对价值路线的结构性优势。
- on-policy 数据约束与高方差是 REINFORCE 的两大原罪,各自的解法就是后续章节。