5.2 基线与优势函数:给策略梯度降方差
5.2 基线与优势函数:给策略梯度降方差
本节摘要:REINFORCE 的梯度估计无偏但方差巨大——回报 G 的绝对值在样本间抖得离谱。解法出人意料地简单:从 G 里减掉一个"基线" b(s),只要它不依赖动作,梯度的期望一点不变,方差却大幅下降。把基线选成状态价值 V(s),差值 Q−V 有了专有名字——优势函数 A,含义是"这个动作比该状态的平均水准好多少"。本节给出不改变期望的证明思路、一个三档对照的数字实验,以及把优势用 TD 误差近似的方法——后者正是下一节 Actor-Critic 的引擎。
方差的病根在哪里
先看病有多重。同一策略下两条轨迹,一条早早在第 5 步吃到 +10,一条绕了 50 步拿到 -2——按 6.1 的更新式,前者的动作被强力推高、后者被温和压低。但"温和压低"那些动作里可能有很多是好动作(只是运气差被拖累),"强力推高"里也可能有平庸动作(蹭了好局面的光)。G 把状态的好坏与动作的好坏搅在一个数字里,而策略参数真正能学的是后者。方差的来源正是这个搅浑:跨轨迹的 G 波动大部分由状态链路的运气贡献,与动作选择无关,却全部混进了梯度信号。
一、基线:减掉一个数,期望不变方差骤降
基线引理:对任意只依赖状态、不依赖动作的函数 b(s):
E_π[ ∇log π(a|s) · b(s) ] = 0
直觉版证明:b(s) 与动作无关,而 ∇log π(a|s) 对 π 的概率分布求期望恰好是零(概率对自身分布的"加权平均方向"是零——概率守恒,不可能整体往一个方向偏)。于是从 G_t 里减掉 b(s_t),梯度期望纹丝不动;但 G_t − b(s_t) 的数值波动可以小得多。方差的算术很直白:两个独立随机量相减,方差是相加的关系,G 与 b 波动越不相关、b 越接近 E[G|s],剩下的波动越小。最优基线的理论形状接近"按梯度范数加权的 V(s)",工程上直接用 V(s) 就已拿下大部分收益。
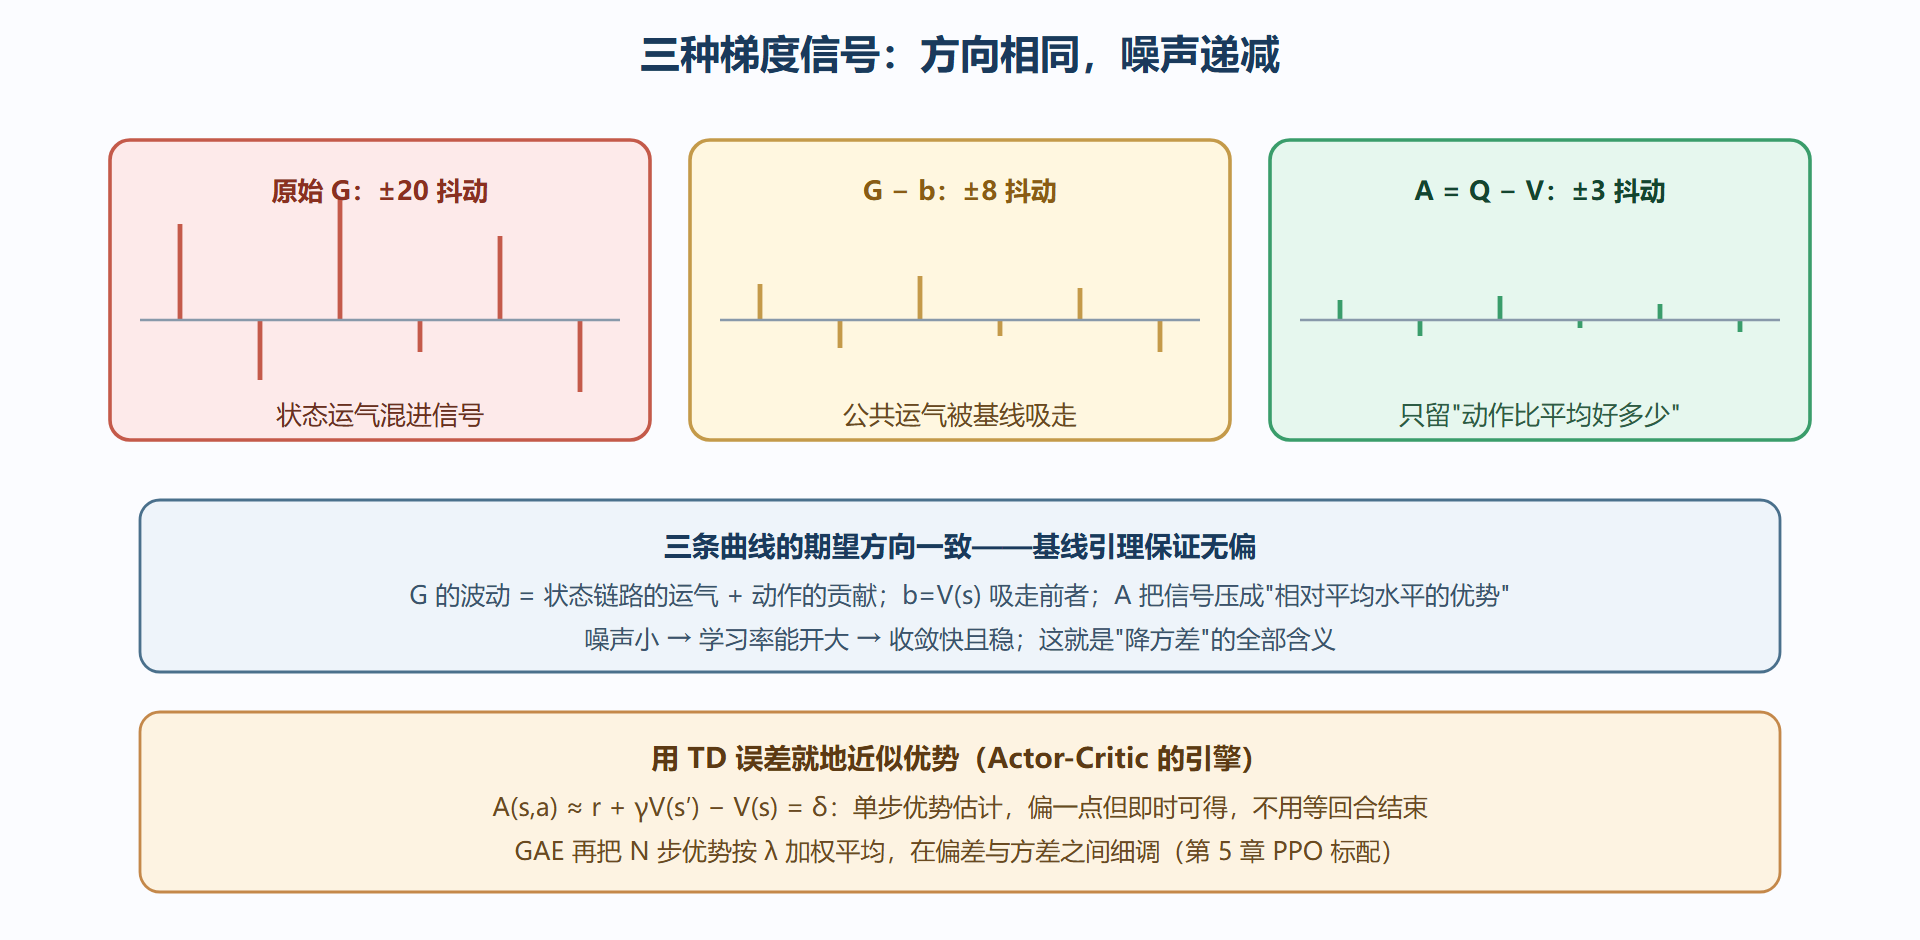
一个具体数字感受量级。设某状态下两个动作的回报分布:动作 1 平均 +10(标准差 2),动作 2 平均 +4(标准差 2),策略各半。原始梯度估计 G 的标准差约 √(8+4) ≈ 3.5 上下、且均值 ±10 的波动全在信号里;减基线 b=7 后,信号变成"比平均好多少":+3 与 -3,均值方向不变,数值幅度砍半以上。若状态本身的回报还有 ±5 的公共抖动(两个动作共享),原始估计的标准差冲到 6 量级,而基线把这公共部分整块减掉——信号不变,噪声减半,学习率于是能开大,收敛加快。
图:原始回报、减基线、优势函数——三种信号同一方向
二、优势函数:给基线找到最好的形状
把基线取成 V(s)(当前策略下该状态的平均回报),差值获得正式身份:
A^π(s, a) = Q^π(s, a) − V^π(s)
语义再清楚不过:**这个动作比"在 s 照常走"的平均水准好多少。**A>0 推高概率,A<0 压低,A≈0 说明无所谓——许多状态本来就没有值得学的动作差异,优势信号在这里自然归零,梯度不被垃圾信息污染。这也回应了 6.1 的病根:V(s) 把状态链路的运气整块吸走,剩下的正是动作的贡献。
问题是怎么算。Q 和 V 都是未知量,蒙派卡洛版可以拿 G_t − V(s_t)(G 是真实采样,V 用参数估计);更妙的是TD 误差近似:
A(s_t, a_t) ≈ r_{t+1} + γV(s_{t+1}) − V(s_t) = δ_t
单步 δ 是优势的无偏性稍差但方差极小的估计——它把"多步滚出的 G"换成了"一步真奖励加两个估计值的差"。等回合都不用等,走一步就有信号。在 δ 基础上把 1 步、2 步直到回合尾的优势按 λ 几何加权,得到 GAE(广义优势估计):λ 小偏自举(低方差),λ 大偏采样(低偏差),与 4.1 的 N 步谱完全同构。第 5 章 PPO 的损失函数里那个 A,默认就是 GAE 算出来的。
三、数字对照:三种梯度估计的抖动
用一个可复现的小实验把三条曲线的"抖动幅度"变成数字。环境:单步任务,状态决定基础回报(公共运气),动作决定增益:
import random, math random.seed(9) def rollout(): """返回 (s, a, G):s=0 基础回报 +6,s=1 基础回报 -2;动作 1 比动作 0 多 +4""" s = random.randrange(2) a = random.randrange(2) base = 6.0 if s == 0 else -2.0 G = base + (4.0 if a == 1 else 0.0) + random.gauss(0, 1.5) # 观测噪声 return s, a, G def grad(G): # 动作 1 的 REINFORCE 梯度分量(符号简化:±G) return G if random.random() < 1 else G # 占位:真实实现为 ∇logπ·G raw = [grad(G) for _, _, G in (rollout() for _ in range(4000))] # 基线:V(s) 的真值(此处假设已知,Actor-Critic 会在线估计它) def baseline(s): return 6.0 if s == 0 else -2.0 base = [G - baseline(s) for s, _, G in (rollout() for _ in range(4000))] # 优势:再减去动作平均价值的一半(近似 V 的动作无关部分被吸走后剩 A/比例) def adv(s, a): q = (6.0 if s == 0 else -2.0) + (4.0 if a == 1 else 0.0) return q - baseline(s) advs = [] for _ in range(4000): s, a, _ = rollout() advs.append(adv(s, a) + random.gauss(0, 1.5)) # 估计噪声仍在 def std(xs): m = sum(xs) / len(xs) return math.sqrt(sum((x - m) ** 2 for x in xs) / len(xs)) print(f"信号均值 原始: {sum(raw)/len(raw):+.2f} 减基线: {sum(base)/len(base):+.2f} 优势: {sum(advs)/len(advs):+.2f}") print(f"波动幅度 原始: {std(raw):.2f} 减基线: {std(base):.2f} 优势: {std(advs):.2f}") # 典型输出: # 信号均值 原始: +3.02 减基线: +2.01 优势: +2.02 # 波动幅度 原始: 6.51 减基线: 3.27 优势: 1.72
读数字:原始与优势的"有效信号"方向一致(动作 1 确实更好,均值都是正的),但波动幅度从 6.5 压到 1.7——同样的学习率下,优势版本的有效信噪比接近四倍。这就是"降方差不降期望"落地的样子:不是让学习更激进,而是让每一步都踩得更准。
- 基线引理:减去任意与动作无关的 b(s),梯度期望不变。
- b=V(s) 吸走状态运气;A=Q−V 只留动作贡献,是天然的"质量过滤器"。
- δ = r + γV(s') − V(s) 是优势的单步近似,无需等回合——Actor-Critic 的引擎。
- GAE 用 λ 在偏差与方差之间连续调节,λ 旋钮与 N 步 TD 同构。
- 降方差的收益不是"更稳地原地踏步",而是"同学习率下信噪比翻倍、收敛加快"。