4.3 DQN 双引擎:经验回放与目标网络
4.3 DQN 双引擎:经验回放与目标网络
本节摘要:DQN(Deep Q-Network)把 Q-Learning 的更新式原样搬进神经网络,再装上两台稳定器:经验回放把在线数据流打散成近似独立的小批样本,目标网络把自举目标冻结在一个滞后参数副本上。两者分别斩断"数据相关"与"目标漂移"两条发散回路。本节讲清每台稳定器对症的病、典型超参数的取值与理由,并给出带注释的精简实现。
训练为什么会崩
5.1 与 5.2 留下的病根凑齐了三样:样本强相关(相邻帧几乎一样,梯度更新沿着单一方向的走廊狂奔)、数据分布漂移(策略变,数据变)、自举目标漂移(目标函数的参数就是被训练的参数)。DQN 的贡献不是发明新方程——更新目标仍是 3.4 节的 Q-Learning 式——而是发明了让深度网络在这个框架里不崩的工程结构。两台稳定器各斩一条回路,缺一不可:只有回放没有目标网络,目标仍追着参数跑;只有目标网络没有回放,强相关的连续帧仍会把小批量梯度带偏。
一、经验回放:把数据流变成数据集
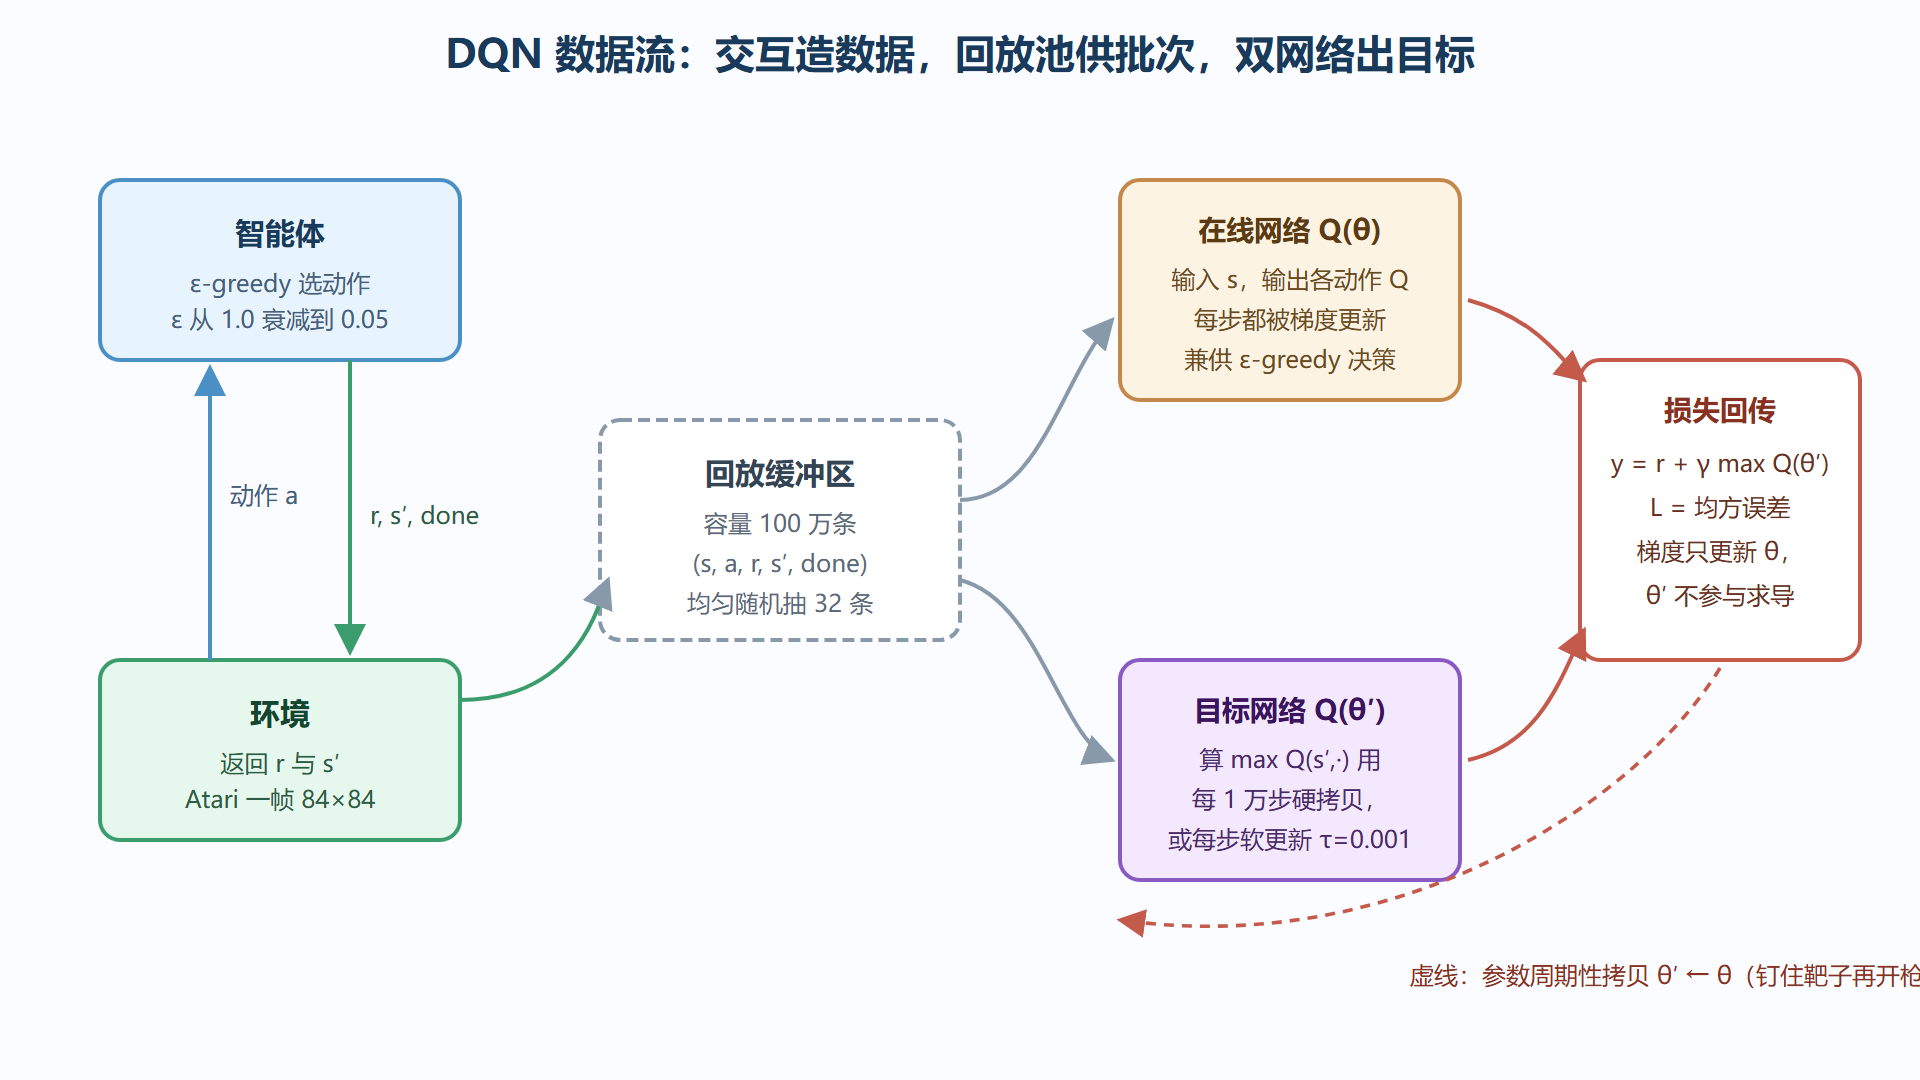
机制:智能体每走一步,把转移 (s, a, r, s', done) 存进一个大环形缓冲区;训练时从中均匀随机抽一批(如 32 条)做梯度更新。三重收益:随机抽打断时间相关性,小批梯度方向更可信;一条经验被抽中多次,样本效率提升(贵样本如稀疏奖励时刻被反复利用);缓冲区天然容纳多代策略的数据,异策略身份(Q-Learning 本就是 off-policy)让这一切合法。
超参数有讲究。缓冲区容量:Atari 经典取 100 万条(约几十 GB 的 uint8 存储);容量太小装不下多样经验,太大则混入过多远古策略的垃圾数据——经验上取"最近 20 到 80 个回合的量"作起点。批大小:32 到 64 起步;加大加速收敛但稀释更新频率。起点训练时机:常见"先随机探索填 1 万到 5 万条再开始训练"(warm-up),避免拿纯垃圾数据初始化网络。更新频率:每走 1 步训练 1 次是标准;也有 4 步 1 训(省算力)。这些数字不是玄学,后面 4.4 节给一张完整参数表。
二、目标网络:把靶子钉住
机制:另存一份参数 θ⁻ 作为目标网络,计算自举目标时用 θ⁻ 而非 θ:
y = r + γ · max_a Q(s', a; θ⁻) (非终止;终止时 y = r)
θ⁻ 每 C 步从在线网络硬拷贝一次(Atari 原版 C=10000 步),或每步软更新:θ⁻ ← τθ + (1-τ)θ⁻,τ 取 0.001 量级。效果:目标值在一段窗口内是"钉住的",在线网络对着一面静止的镜子调整自己,等镜子缓慢刷新。损失函数:
L(θ) = E[ ( y − Q(s, a; θ) )² ]
这是标准的均方误差回归——深度学习的一切工具(Adam、梯度裁剪、学习率调度)此刻全部适用。DQN 的天才之处正是把强化学习问题暂时变成了一个监督回归问题,代价只是目标每 C 步才准一次。
图:DQN 架构与数据流——两网络一回放池
三、精简实现:把两台稳定器写进代码
PyTorch 风格的核心训练循环(网络定义从略,重点是机制的位置):
import random import torch import torch.nn as nn class ReplayBuffer: def __init__(self, capacity=100_000): self.buf, self.cap = [], capacity def push(self, trans): # trans = (s, a, r, s2, done) if len(self.buf) >= self.cap: self.buf.pop(0) # 环形淘汰最老样本 self.buf.append(trans) def sample(self, batch=32): return random.sample(self.buf, batch) q_net = QNetwork(n_actions) # 在线网络 target = QNetwork(n_actions) target.load_state_dict(q_net.state_dict()) # 初始同参 opt = torch.optim.Adam(q_net.parameters(), lr=2.5e-4) gamma, eps, tau = 0.99, 1.0, 0.005 for step in range(total_steps): eps = max(0.05, eps - 1 / warmup_steps) # 线性衰减探索率 a = greedy_or_random(state, q_net, eps) s2, r, done = env.step(a) buffer.push((state, a, r, s2, done)) state = s2 if step > 5_000 and step % 4 == 0: # warm-up 后每 4 步练一次 s_b, a_b, r_b, s2_b, d_b = map(torch.as_tensor, zip(*buffer.sample(32))) q_now = q_net(s_b).gather(1, a_b) # 取所执行动作的 Q 值 with torch.no_grad(): # 目标不回传梯度:两重保险 q_next = target(s2_b).max(1).values y = r_b + gamma * q_next * (1 - d_b) # done 清零未来项 loss = nn.functional.smooth_l1_loss(q_now, y) opt.zero_grad(); loss.backward() nn.utils.clip_grad_norm_(q_net.parameters(), 10.0) # 梯度裁剪 opt.step() for p_t, p in zip(target.parameters(), q_net.parameters()): p_t.data.mul_(1 - tau).add_(tau * p.data) # 软更新目标网络
逐处点名稳定器位置:buffer.sample 斩数据相关;target 网络与 no_grad 斩目标漂移(no_grad 是第二重保险——即使忘了软更新,至少不让梯度流进目标);(1 - d_b) 是 done 清零;梯度裁剪防个别样本的巨大 TD 误差炸飞参数。每一行都对着 4.2 节的一种死法。
💡 调试心法:训练 DQN 时同时记录三条曲线——回合奖励、Q 值均值、TD 损失。奖励涨是结果;Q 均值平稳缓升是健康;损失持续增大或 Q 均值指数上飘,先停训检查目标网络与 done 处理,再考虑降学习率。
- 经验回放:随机批采样斩相关,重复利用提效率,off-policy 身份是理论前提。
- 目标网络:滞后参数副本钉住自举目标,硬拷贝或软更新(τ≈0.001)两种节奏。
- DQN 的本质 = Q-Learning 更新式 + 监督回归的外壳 + 两台稳定器。
- 训练诊断看三条曲线:奖励、Q 均值、TD 损失;发散先查稳定器。