4.4 DQN 变体对比矩阵与超参数实录
4.4 DQN 变体对比矩阵与超参数实录
本节摘要:原版 DQN 之后,社区用三招修掉了它的三大遗留病:Double DQN 修 max 高估,Dueling 架构修价值与优势的混淆,优先经验回放修均匀采样的浪费。本节用一张对比矩阵把每个变体的病、药方、改动位置与代价列全,再给出一份可直接抄用的超参数实录,并示范如何读训练曲线判断该上哪个变体。
一张矩阵看懂四个变体
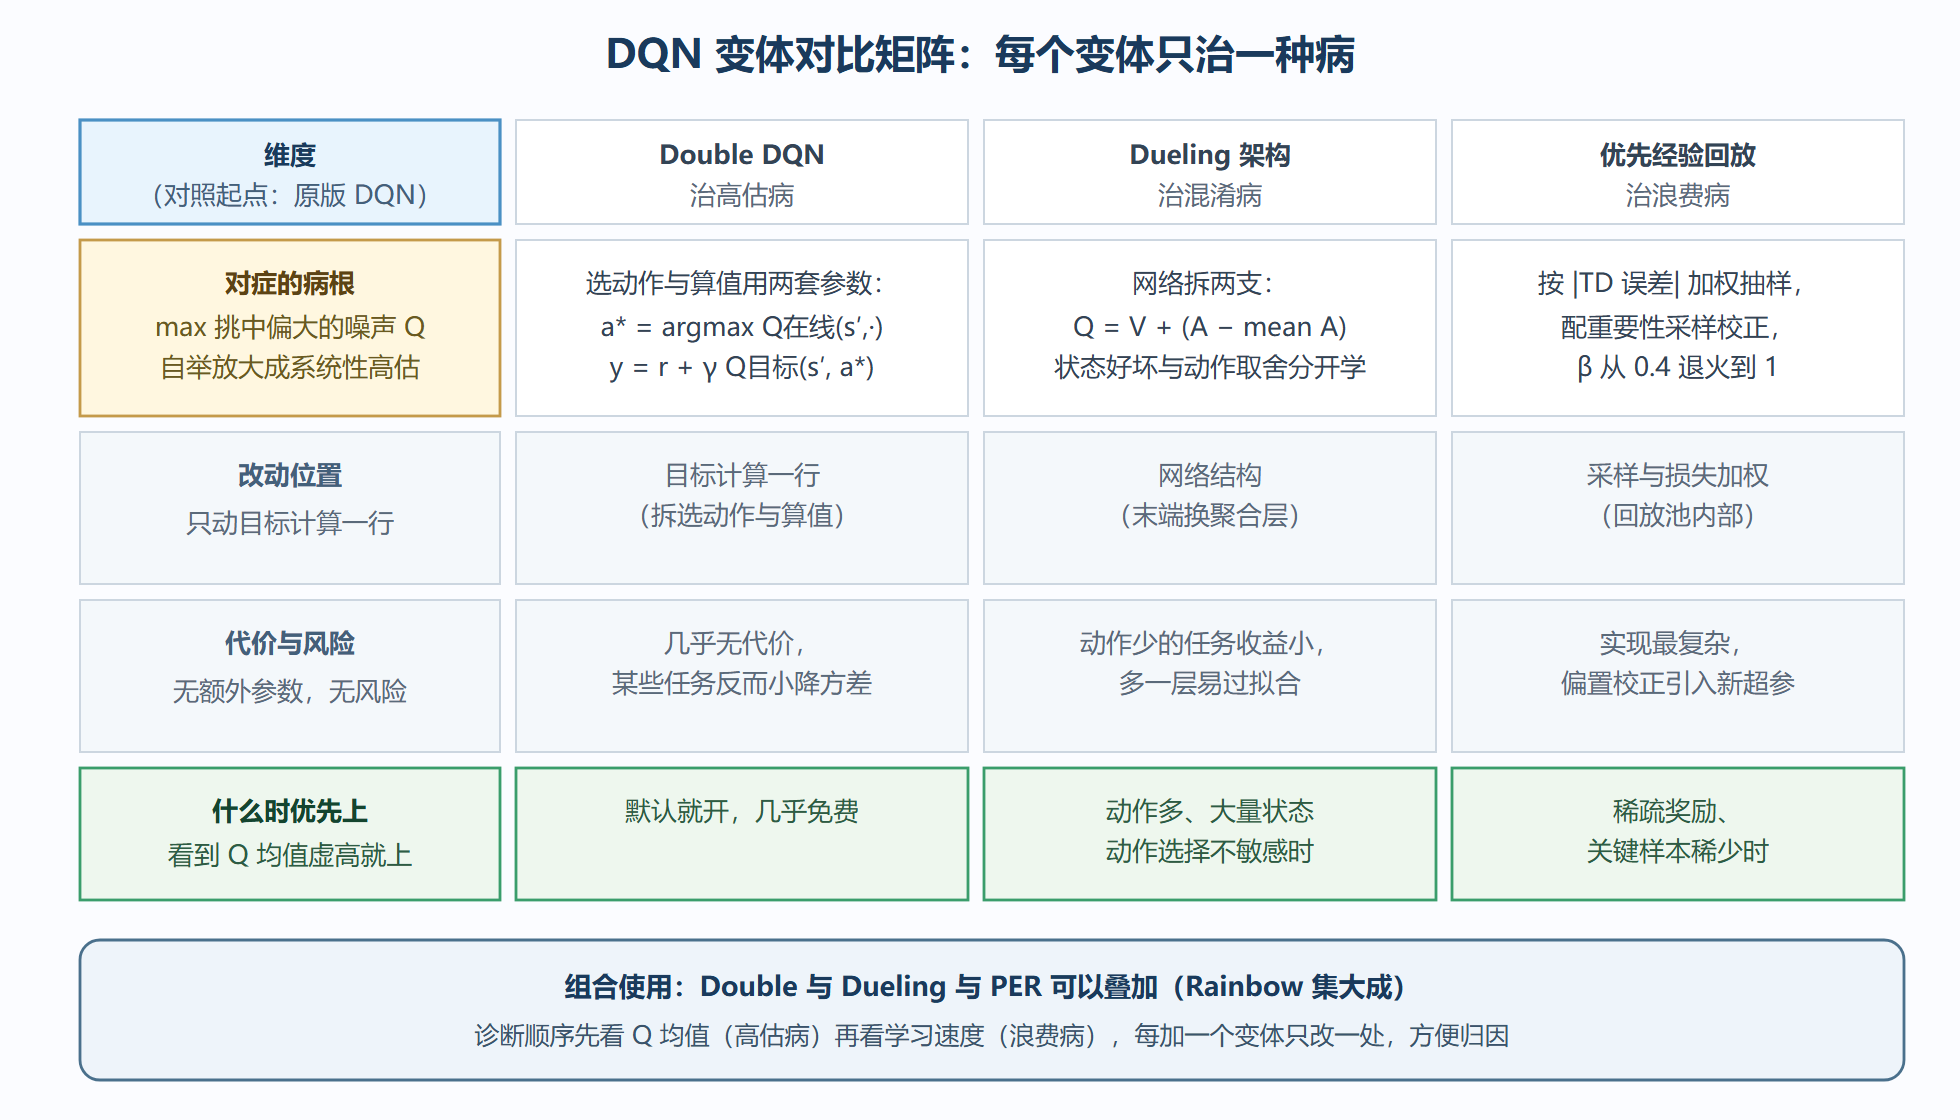
原版 DQN 的三个遗留病,症状各不相同。高估病:max 操作在噪声 Q 值上系统性挑偏大的(3.4 节埋的账),自举把高估滚成雪球,表现为 Q 均值虚高、策略过早变蠢。信息混淆病:一个动作好,可能因为"这个状态本身就好"(状态价值 V 高),也可能因为"这个动作比别的强"(优势 A 高),单一 Q 流网络把两者搅在一起,许多状态下其实不需要区分动作,噪声白白注入。采样浪费病:均匀采样把 95% 的平凡样本与 5% 的关键样本(大 TD 误差)等权对待,学习信号被稀释。三个变体各对症一病:
图:DQN 变体对比矩阵——病、药方与改动位置
Double DQN:两行代码的事
高估的机制再复述一遍:Q 值有噪声时,E[max_a Q̂(s',a)] ≥ max_a E[Q̂(s',a)]——max 把噪声的上偏差收走了,且这个偏差经自举自我强化。Double DQN 的修法是把"选动作"与"评估动作"交给两套参数:在线网络选动作 a* = argmax_a Q(s', a; θ)(它对"哪个动作好"的判断相对无偏),目标网络评估 y = r + γ Q(s', a*; θ⁻)(两套参数的噪声不相关,评估不会被选动作时挑中同一处噪声)。改动落在训练循环里只有两行:
with torch.no_grad(): a_star = q_net(s2_b).argmax(dim=1, keepdim=True) # 在线网络选动作 q_next = target(s2_b).gather(1, a_star) # 目标网络算值 y = r_b + gamma * q_next.squeeze(1) * (1 - d_b) # 对比原版 DQN:q_next = target(s2_b).max(1).values —— 选与算同一套参数
消融实验显示单独这一改,多数 Atari 游戏的高估幅度砍掉一半以上,个别游戏(Q 值虚高最严重的)性能翻倍。它几乎没有代价,所以现代实现默认开启。
Dueling:把"状态好"与"动作好"分开
网络末端拆出两条流:V 流输出标量 V(s),A 流输出向量 A(s,·),再聚合成 Q(s,a) = V(s) + A(s,a) − mean_a' A(s,a')(减均值是为了可辨识性,否则 V 与 A 加减自由度不唯一)。价值在于:许多状态(走廊中段、安全巡航)里选哪个动作都差不多,V 流直接吃下这部分"共性"学习信号,A 流只学增量差异——数据效率与稳定性双升。动作数很少(比如两个动作)的任务收益有限;输出动作上百时收益显著。
超参数实录与调参次序
一份来自反复实验的 Atar i级基准配置,标注每项的敏感度:
| 超参数 | 推荐初值 | 敏感度 | 依据 |
|---|---|---|---|
| 回放容量 | 10 万(小任务)/ 100 万(Atari) | 中 | 覆盖近 20~80 回合 |
| warm-up 步数 | 5 千~5 万 | 低 | 保证首批训练样本多样性 |
| 批大小 | 32~64 | 低 | 梯度噪声与算力折中 |
| 学习率 | 2.5e-4(Adam) | 高 | 越大越炸,越小越慢 |
| 目标网络更新 | C=1000 步硬拷贝 或 τ=0.005 | 高 | 太频→漂移回归,太缓→目标陈旧 |
| γ | 0.99 | 高 | 任务时距决定,见 1.2 |
| ε 衰减 | 1.0→0.05,线性 10 万步 | 中 | 探索预算 |
| 梯度裁剪 | 范数上限 10 | 中 | 防大 TD 误差炸梯度 |
| 损失 | smooth L1(Huber) | 低 | 对离群误差更钝感 |
调参次序有讲究:学习率与目标网络更新节奏是第一梯队(最敏感),先固定其他项扫这两样;γ 按任务时距定死不再动;ε 衰减影响的是探索而非稳定性,出现"学得慢"而不是"学崩"时才去看它。一个容易忽略的坑:奖励缩放——原版 Atari 把奖励 clip 到 [-1, 1],等价于隐式地缩放学习率;你的环境奖励量级若在几千,同样的 2.5e-4 学习率相当于狂奔,先做归一化再谈调参。
读曲线决定上哪个变体
三条诊断路线。其一,Q 均值持续上飘、回报却平台甚至回落:高估病确诊,先上 Double。其二,学习曲线起步极慢、前期几乎平躺,而日志里大量样本 TD 误差接近零:浪费病,上优先回放(或简单地给"回合终止样本"加权两倍)。其三,回报已可用但不稳、来回震荡,且动作空间大:试试 Dueling 的聚合结构。变体不是越全越好——每个变体引入新超参与新交互,诊断驱动地加,一次只加一个,才能归因。
- Double 修高估:选动作与算值分属两套参数,两行代码,默认该开。
- Dueling 修混淆:Q 拆成 V 与优势流,动作多时收益大。
- PER 修浪费:按 TD 误差加权采样,β 退火做偏置校正,实现最复杂。
- 调参先动学习率与目标更新节奏;奖励量级先归一化。
- 变体按症状上,一次一个,保持归因能力。
两个消融实验的完整读法
变体的价值要用消融实验自己验一遍,给你一份可复制的实验设计与预期读数。实验一,Double 消融:同一环境跑三份配置——原版 DQN、Double、Double 加学习率减半。原版通常呈现"Q 均值持续爬升、回报中前期冲高后回落"的形态;Double 的 Q 均值明显压低(常常只有原版峰值的六到七成),回报曲线更平缓但峰值不降反升,因为策略不再追逐虚高估值。第三份配置回答"是不是学习率的锅":减半后原版的高估幅度确实缩小但回报同步变慢,说明高估不是单纯的学习率问题,max 偏置是结构性的。实验二,优先回放消融:均匀采样对比 PER(β 退火 0.4 到 1.0)。看两个指标:达到均匀版最终回报的 90% 所需步数(PER 通常快三到五成),以及最终回报本身(差异通常在噪声内)。第二个结论很有教学意义——PER 主要买的是速度不是上限,若你的预算无限,均匀采样并非不行。两个实验各配三个随机种子,用均值加减标准差汇报;单种子的对比图在强化学习里几乎是自我欺骗的代名词。把这两份读数放进你的实验报告,比罗列十种变体的理论差异更有说服力。