5.6 DDPG 与确定性策略梯度
5.6 DDPG 与确定性策略梯度
本节摘要:动作连续时,随机策略可以简化成确定性映射 μ(s;θ):每个状态直接输出一个动作值,不再输出分布。确定性策略梯度定理(DPG)保证对它的期望回报梯度形如 E[∇_a Q(s,a;w)|μ(s) ∇_θ μ]——critic 对动作求导,actor 顺着导数方向挪。DDPG 把 DPG 装上 DQN 的两台稳定器(经验回放与目标网络),成为深度强化学习的连续控制开山之作。本节讲清确定性与随机之争的取舍、四个网络的协作、软更新 τ 的角色,并用一个 Pendulum 式的演练收尾。
确定性策略是什么意思
先立概念。随机策略 π(a|s;θ) 输出分布(离散选概率表,连续出高斯的均值方差),执行时还要从分布里采样;确定性策略 μ(s;θ) 输出一个确定的动作值——状态 2.7 度、角速度 0.4,直接给"力矩 +0.63",没有采样这一步。两者的关系可以粗略理解为:确定性策略是随机策略方差趋零的极限。
为什么连续控制偏爱确定性?三个理由。其一,价值方法的困境在连续动作上重现于随机策略:连续高斯策略里,梯度信号 (a−μ)/σ²(5.1 节)把"采样到的动作离均值多远"当学习信号,环境的探索全靠方差 σ 撑着——σ 不好调,过大动作震颤(机械臂抖得像筛糠),过小探索不足。确定性策略把探索从策略里剥离,交给外部的噪声源(后述),策略本身只管"最优动作在哪"。其二,样本效率:确定性策略的 critic 学的是 Q(s, μ(s)) 一条曲线,而随机策略的 critic 原则上要学整个 Q(s, a) 曲面。其三,物理系统的输出本来就是确定性的:给定当前状态,最优力矩就该是一个值;执行层再叠控制噪声即可。
代价也要摆明:确定性策略天生不会探索,也学不到混合策略(石头剪刀布那种必须随机化的场景它无解)。探索交给外加噪声——DDPG 用 Ornstein-Uhlenbeck 过程(带惯性的噪声,适合物理系统)或更简单的独立高斯噪声。
DPG 定理:critic 的导数当指南针
DPG 定理的直白读法:确定性策略的改进方向是
∇_θ J ≈ E_s~ρ [ ∇a Q(s, a;w)|{a=μ(s)} · ∇_θ μ(s;θ) ]
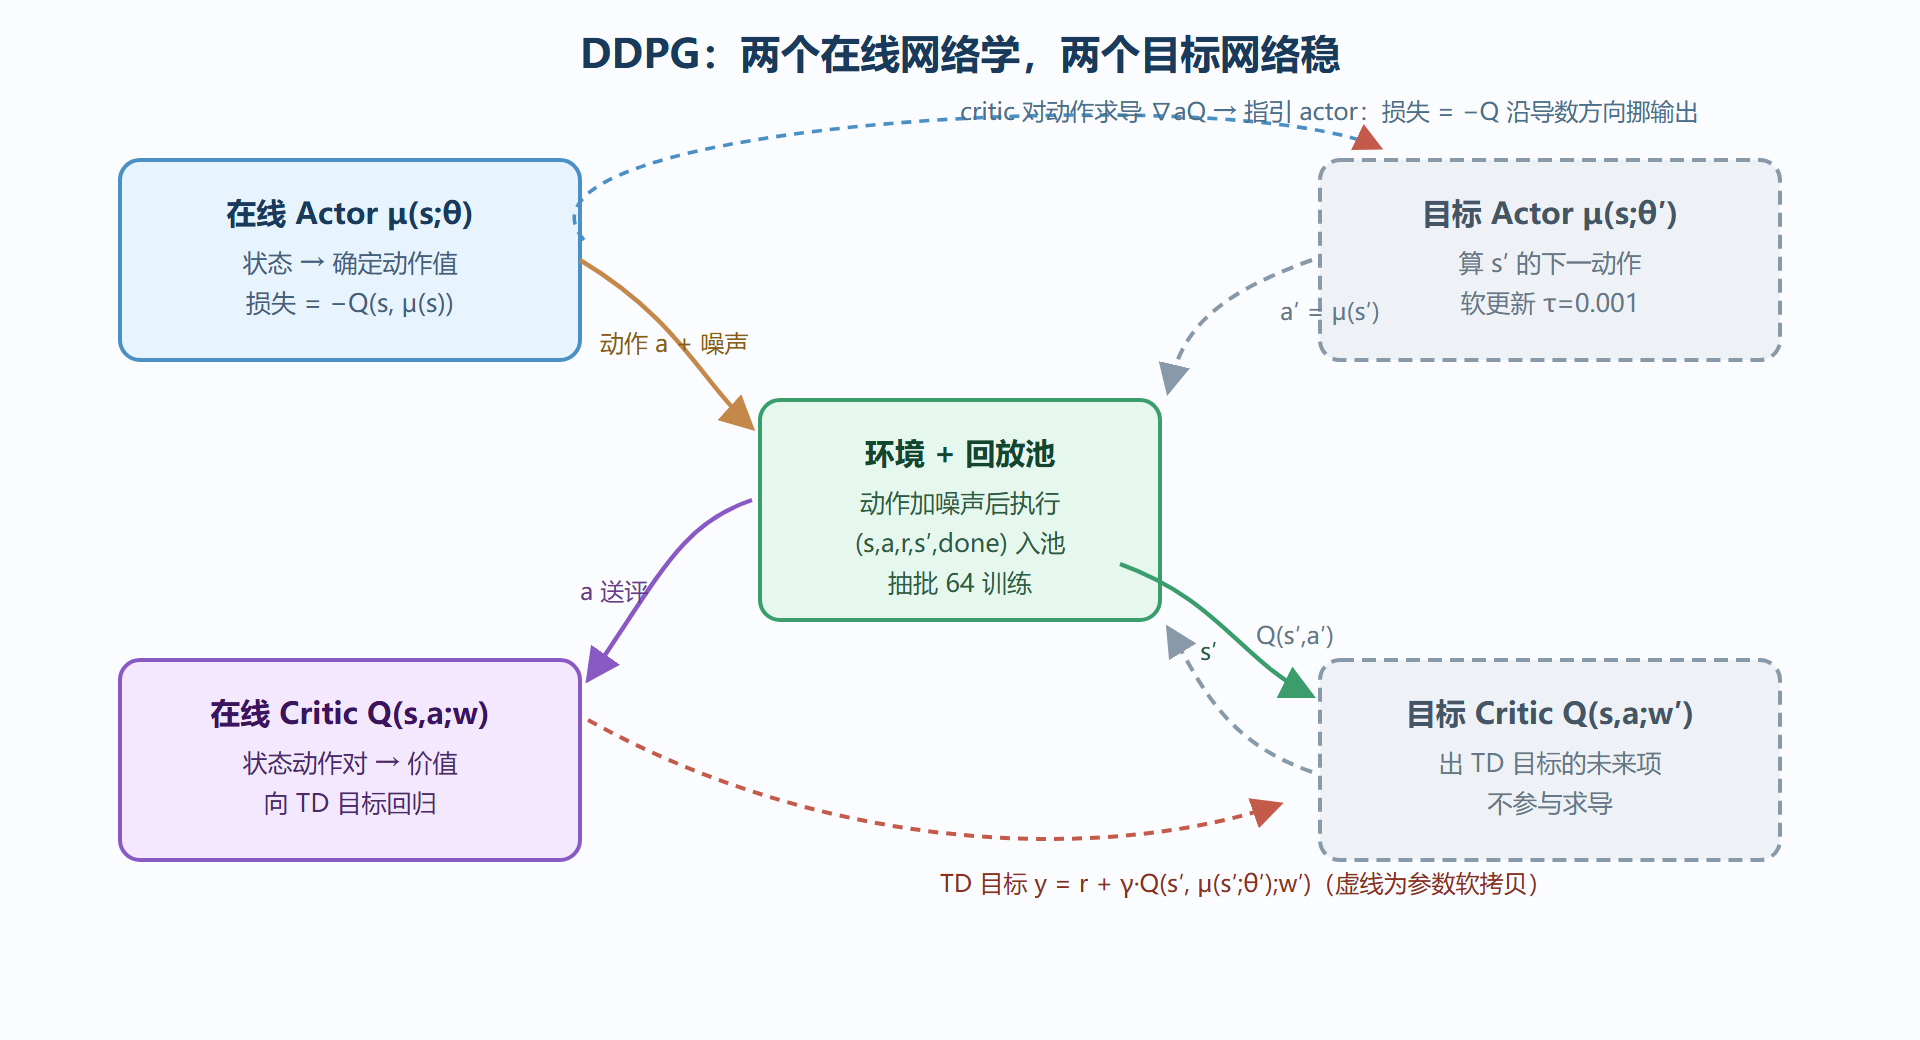
拆开看两段。前半段 ∇_a Q 是 critic 网络对动作输入的偏导数——"在这个状态,把动作往正方向挪一点,价值涨多少"。后半段 ∇_θ μ 是 actor 网络的普通反向传播——"参数怎么改能让输出动作变大"。两段相乘:critic 告诉方向,actor 照着挪。与随机策略梯度(用 log π 加权)相比,DPG 不需要"把好动作推得更常出现",因为只有一个动作可推——问题从"调整分布"简化成"挪动输出点",梯度形式也因此干净。
这带来一个结构性风险:critic 必须在 actor 指定的动作附近足够准。actor 挪出 critic 训练数据覆盖的区域后,∇_a Q 是凭空外推的,可能指向荒谬方向——DDPG 的训练崩塌大多源于此(外推误差被自举放大)。后续 TD3 用双 critic 取最小值、SAC 用最大熵框架分别收拾这个病,此处先记账。
四个网络的协作与两台移植的稳定器
DDPG 一共四个网络:在线 actor μ(s;θ)、在线 critic Q(s,a;w)、目标 actor μ(s;θ⁻)、目标 critic Q(s,a;w⁻)。训练循环借自 DQN,改一处关键细节——软更新:
# DDPG 训练核心(PyTorch 风格,网络定义从略) replay = ReplayBuffer(200_000) # 稳定器一:回放池 for step in range(total_steps): a = actor(s) + OU_noise() # 确定动作 + 外部探索噪声 s2, r, done = env.step(a) replay.push((s, a, r, s2, done)) if step > 1_000: # warm-up 后开练 s_b, a_b, r_b, s2_b, d_b = replay.sample(64) with torch.no_grad(): a2 = target_actor(s2_b) # 目标 actor 出下一动作 y = r_b + gamma * (1 - d_b) * target_critic(s2_b, a2).squeeze(1) critic_loss = ((critic(s_b, a_b).squeeze(1) - y) ** 2).mean() opt_critic.zero_grad(); critic_loss.backward(); opt_critic.step() actor_loss = -critic(s_b, actor(s_b)).mean() # 梯度上升 → 取负号 opt_actor.zero_grad(); actor_loss.backward(); opt_actor.step() for t, o in zip(target_actor.parameters(), actor.parameters()): t.data.mul_(tau).add_(tau * o.data) # 稳定器二:软更新 τ=0.001 for t, o in zip(target_critic.parameters(), critic.parameters()): t.data.mul_(tau).add_(tau * o.data)
逐处点名。回放池:与 DQN 同理,斩样本相关、提复用率——它在这里合法的前提是 DPG 属于 off-policy(行为策略含噪声,学习目标只关心 μ)。软更新 τ=0.001:DDPG 不用 DQN 的硬拷贝,而是每步朝在线参数挪千分之一——四个网络的存在使硬拷贝的"参数断层"伤害更大(目标 actor 与目标 critic 必须彼此一致),软更新把目标端的漂移抹成连续坡。actor 损失取负:框架都是"最小化损失",actor 要梯度上升,等价于最小化 −Q。done 清零:老规矩,1.3 节的账在这兑现。
图:DDPG 四网络数据流——critic 当尺,actor 当手
演练与选型收束
用一个 Pendulum 式任务验证概念(摆杆起立,连续力矩 [-2, 2])。训练几百回合后,从 replay 抽一个状态,打印 actor 输出与 critic 对动作的偏导:
probe_s = torch.as_tensor([[0.8, 0.3]]) # 摆角 0.8, 角速度 0.3 a = actor(probe_s) print(f"actor 输出力矩: {a.item():+.3f}") # 例如 +1.42 q_curve = [critic(probe_s, torch.as_tensor([[t]])).item() for t in (-2.0, -1.0, -0.5, 0.0, 0.5, 1.0, 2.0)] print([f"{v:+.2f}" for v in q_curve]) # 典型输出: ['-4.10', '-1.95', '-0.88', '-0.10', '+0.71', '+1.55', '+1.90'] # critic 的 Q 随力矩增大而上升 → ∇aQ > 0 → actor 的损失 -Q 会继续推大力矩输出, # 直到动作触界或 critic 曲线在此区间趋平(外推区,正是 TD3 双 critic 打压的区域)
这段探针代码是调试 DDPG 的基本功:看 actor 输出是否卡在动作边界(常见病:探索噪声太小或 critic 外推),看 critic 曲线在动作域内是否平缓合理(大起大落说明 critic 没学好)。
最后收束选型:离散动作选 DQN 系(第 4 章);连续动作在 PPO(随机策略、实现简单、样本吞吐大)与 DDPG 系(确定性、样本效率高、对超参更挑剔)之间选。后者家族的演进是 TD3(双 critic 取 min、延迟更新、目标平滑)与 SAC(最大熵探索),它们与 PPO 共同构成今天工业界的默认工具箱——第 6 章的工具链一节会再次给出这张选型表。
- 确定性策略输出单一动作值,探索外包给噪声源,样本效率高于随机策略。
- DPG 的梯度 = critic 对动作的导数 × actor 对参数的导数,critic 是尺、actor 是手。
- DDPG 移植 DQN 双稳定器,软更新 τ≈0.001 替代硬拷贝抹平四网络一致性。
- critic 外推误差是 DDPG 的病根,TD3 与 SAC 是两味对症药。
- 探针调试法:查 actor 是否卡边界、critic 曲线是否平缓。