5.5 PPO 数字演练:ratio、clip 与超参数
5.5 PPO 数字演练:ratio、clip 与超参数
本节摘要:本节把 PPO 的裁剪目标放进六个具体样本里手算一遍:给定新旧策略的概率与优势估计,逐样本算出 ratio、裁剪后的目标、以及每个样本本轮贡献的梯度方向。算完再给超参数表:clip 范围 0.2、GAE 的 λ、epochs 数、学习率——每一项标注敏感度与调整方向。目标是让 PPO 从"背公式"变成"能验算"。
演练:手算一个 batch 的 clip
设定:旧策略 π_old 在状态 s 下动作"右"的概率是 0.50;一轮 epochs 训练中,新策略 π_θ 给"右"的概率依次变化。优势估计 A 由 GAE 算出(细节见第 5 章),clip 范围 ε=0.2。六个样本如下表,逐个计算目标值 min(ratio·A, clip(ratio, 0.8, 1.2)·A):
| 样本 | π_old(a|s) | π_θ(a|s) | ratio | A | ratio·A | clip(ratio)·A | min → 目标 | 梯度激励 |
|---|---|---|---|---|---|---|---|---|
| 1 | 0.50 | 0.55 | 1.10 | +2.0 | +2.20 | +2.20 | +2.20 | 继续放大(未触界) |
| 2 | 0.50 | 0.62 | 1.24 | +2.0 | +2.48 | +2.40 | +2.40 | 已越界,梯度为零 |
| 3 | 0.50 | 0.40 | 0.80 | +1.0 | +0.80 | +0.80 | +0.80 | 恰在界上,激励消失 |
| 4 | 0.50 | 0.45 | 0.90 | −3.0 | −2.70 | −2.70 | −2.70 | 继续压低(未触界) |
| 5 | 0.50 | 0.38 | 0.76 | −3.0 | −2.28 | −2.40 | −2.28 | 已越界,梯度为零 |
| 6 | 0.50 | 0.58 | 1.16 | −1.0 | −1.16 | −1.20 | −1.20 | 未触上界,正常压制 |
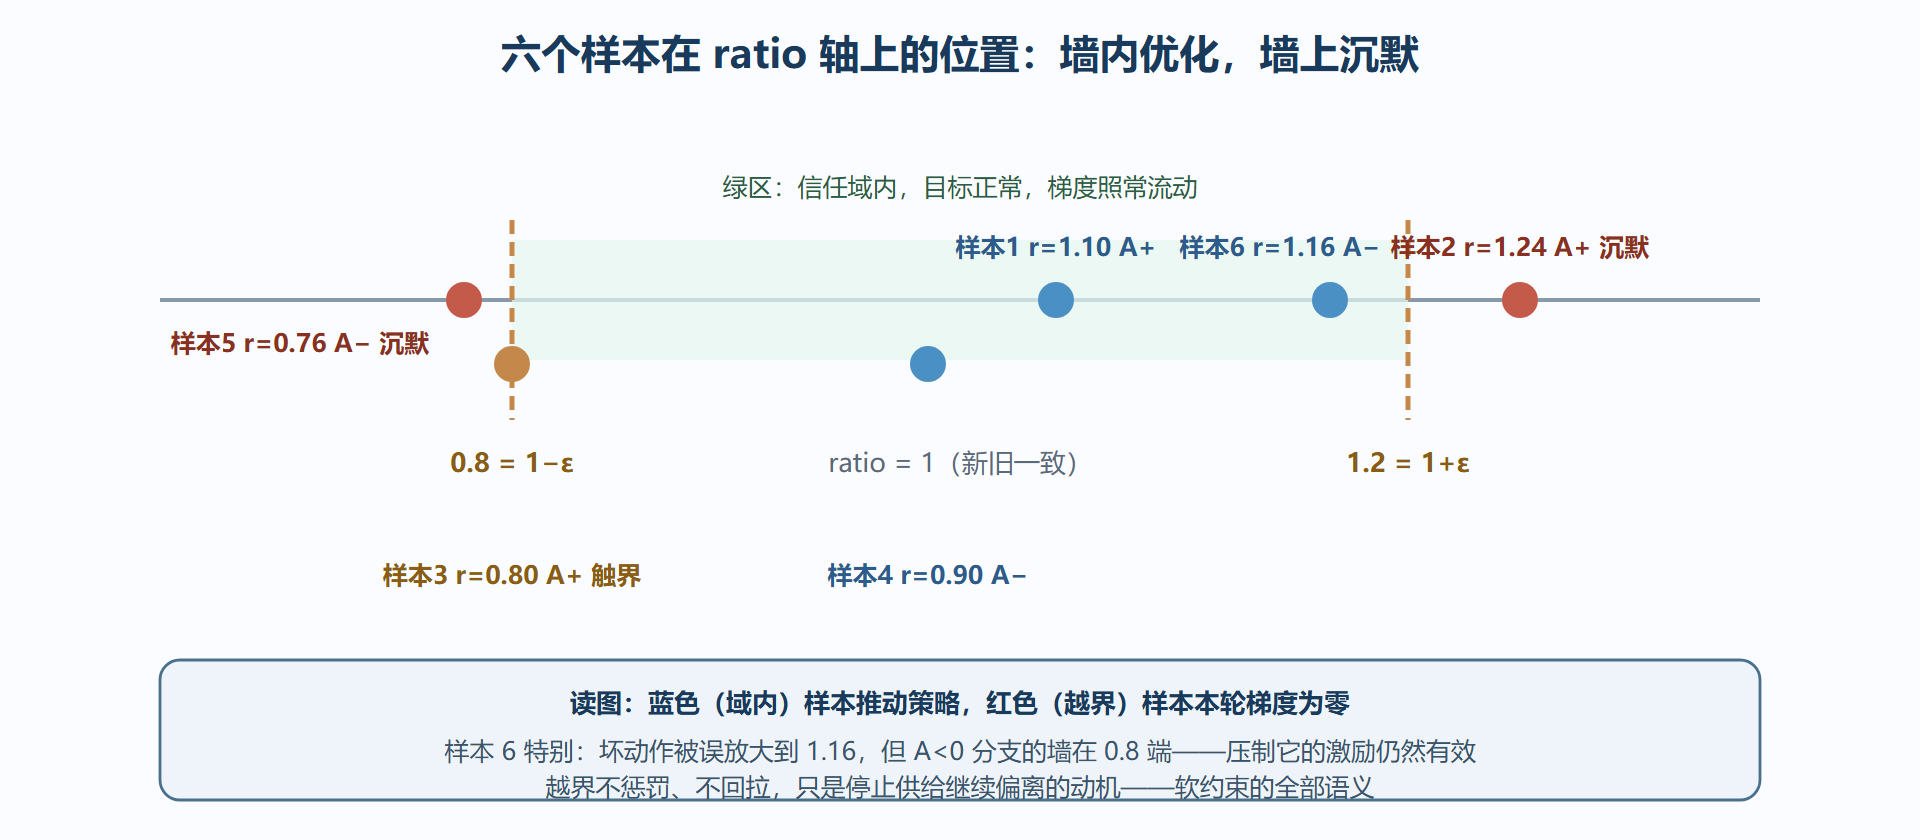
逐条读。样本 1 与 2 都是优势 +2.0 的好动作:样本 1 的 ratio=1.10 还在信任域内,目标随 ratio 增长,梯度继续推高概率;样本 2 的 ratio=1.24 已越过 1.2,未裁剪目标 +2.48 比"越界墙" +2.40 更高,但 min 选取了墙值——梯度为零,策略不再因这个样本继续膨胀。**样本 5** 是负优势样本:ratio=0.76 跌破 0.8,min 选了未裁剪值 −2.28(比墙值 −2.40 大),梯度同样为零——"坏动作压到 0.76 倍就到此为止"。**样本 6** 最容易被误读:优势为负、ratio 又大于 1(新策略反而放大了坏动作),min 选了裁剪墙 −1.20,梯度仍在——这个样本此刻的使命是把"误放大的坏动作"压回去,正是需要的方向。
一个 batch 汇总:目标均值 = (2.20 + 2.40 + 0.80 − 2.70 − 2.28 − 1.20) / 6 = −0.13,梯度上升把它推高——有效梯度只来自未触界的样本 1、4、6,越界的 2、3、5 坐观其成。这个"部分样本沉默"的机制,就是 PPO 稳定的全部秘密。
图:clip 区间图——六个样本在墙上的位置
完整实现:裁剪目标只有几行
把上面的表翻译成代码(PyTorch 风格),这是 PPO 的心脏:
def ppo_loss(logp_new, logp_old, advantages, clip_eps=0.2): ratio = (logp_new - logp_old).exp() # π_new / π_old(对数域相减) surr1 = ratio * advantages # 未裁剪目标 surr2 = ratio.clamp(1 - clip_eps, 1 + clip_eps) * advantages return -torch.min(surr1, surr2).mean() # 取负:梯度上升 → 损失下降 # 一次完整更新(n 步滚动 + 多轮 epochs): for epoch in range(ppo_epochs): # 典型 3~4 轮 for batch in rollout_batches: # 每批 2048~4096 帧 logits = actor_net(batch.states) dist = Categorical(logits=logits) logp_new = dist.log_prob(batch.actions) loss = ppo_loss(logp_new, batch.logp_old, batch.advantages) \ + 0.5 * value_loss(batch.returns, value_net(batch.states)) \ - 0.01 * dist.entropy().mean() # 熵正则保探索 opt.zero_grad(); loss.backward() nn.utils.clip_grad_norm_(actor_net.parameters(), 0.5) opt.step()
三个实现细节对应演练中的数字。logp_new - logp_old 在对数域做差再 exp,数值稳定(概率连乘会下溢);clamp 就是那两堵墙;min 在越界区自动选择墙值,让梯度消失。注意同一批数据会跑 3 到 4 个 epochs——这正是 PPO 相对 vanilla 策略梯度的样本效率红利:clip 保证多轮更新中 ratio 不至于跑飞,第 5 章"数据必须即采即用"的枷锁被松开到"一批数据最多用四轮"。
超参数实录:敏感度排序
按"调错的代价"从高到低排:
| 超参数 | 推荐值 | 敏感度 | 调整方向 |
|---|---|---|---|
| clip ε | 0.2 | 高 | 曲线不稳→0.1;学得慢→0.3 |
| epochs 数 | 3~4 | 高 | 加多必过拟旧数据,KL 早停兜底 |
| 学习率 | 3e-4(Adam) | 高 | 与 epochs 联动,崩先降它 |
| GAE λ | 0.95 | 中 | 小偏自举稳,大偏采样准 |
| 每批帧数 | 2048~4096 | 中 | 太小梯度噪,太大更新稀 |
| 熵正则系数 | 0.01 | 中 | 策略过早确定→0.03 |
| 折扣 γ | 0.99 | 任务定死 | 时距决定,见 1.2 |
| 梯度裁剪 | 0.5 | 低 | 常规保险 |
排查顺序建议:训练崩 → 先降学习率、减 epochs;学得慢 → 加大 clip 到 0.3 或提学习率;回报上去又掉 → 熵正则加码、检查优势是否被 critic 的偏差污染。另一个容易忽略的数值健康项:优势标准化——每批优势减均值除标准差,让梯度量级与任务奖励量级脱钩;不做这一步,奖励量级大的环境里 PPO 的有效学习率会虚高,症状与"学习率太大"一模一样。
- ratio 在对数域计算;clip 的两堵墙是 1±ε;min 选择保守分支。
- 越界样本梯度归零而非受罚——软约束,靠新数据自然回调。
- 多轮 epochs 是 PPO 的样本效率来源,clip 是让它安全的前提。
- 调参先动学习率与 epochs;优势标准化是隐藏的健康开关。