6.2 基于模型的强化学习与 MCTS:AlphaGo 路线
6.2 基于模型的强化学习与 MCTS:AlphaGo 路线
本节摘要:前文的算法都是无模型的——环境怎么变只能靠真试。基于模型的强化学习把转移规律学进网络(世界模型),然后在"想象中"规划;蒙特卡洛树搜索(MCTS)是想象力的执行引擎,AlphaGo 用"两个网络剪枝 + MCTS 推演"击败了围棋。本节讲清模型学习的动机与误差代价、MCTS 四阶段循环的每一步,以及 AlphaGo 组合拳里每个部件解决什么问题。
一、下棋为什么不能只靠 Q 表或 DQN
围棋 10^170 个状态,DQN 的函数逼近可以上,但真正的死结是信用分配的时距:一步棋的价值要在几百步之后才显现,无模型方法靠真实对局一格格倒灌(3.5 节的涟漪),需要的对局量是天文数字。换个角度想:人类棋手不靠"下过 10^170 局",靠的是推演——看到一步棋,在脑内往下演算十几手,评估局面再回头。这个"脑内对弈"有两个零件:一个局面评估器(现在这个形势对谁有利),一个走子生成器(这种局面下值得考虑哪几手棋)。基于模型的强化学习把这两个零件显式建出来,在模型里规划而不是在现实里试错。
世界模型就是这个可推演的环境替身:给定 s 与 a,预测 r 与 s'。学习它是一个标准的监督回归问题(用真实交互数据训练),比直接学策略容易得多——预测"会发生什么"远比判断"该怎么办"信息密度高。学成之后收益双份:其一,规划——在模型里展开搜索树,评估不同走法;其二,数据增广——模型生成的 imagined 轨迹可以喂给无模型算法(Dyna 架构的思想),一份数据当两份用。代价也明码标价:模型误差会被规划器放大利用——模型在数据稀疏处瞎猜,规划器专挑瞎猜出来的"完美路线"走(模型作弊,与第 1 章奖励作弊同源的病),这是基于模型方法的核心风险。
二、MCTS:四阶段循环
蒙特卡洛树搜索是把"推演"组织成可执行算法的经典框架。每走一步棋之前,它从当前局面出发做 N 次模拟(AlphaGo 每步几千到几万次),每次模拟走完四个阶段:
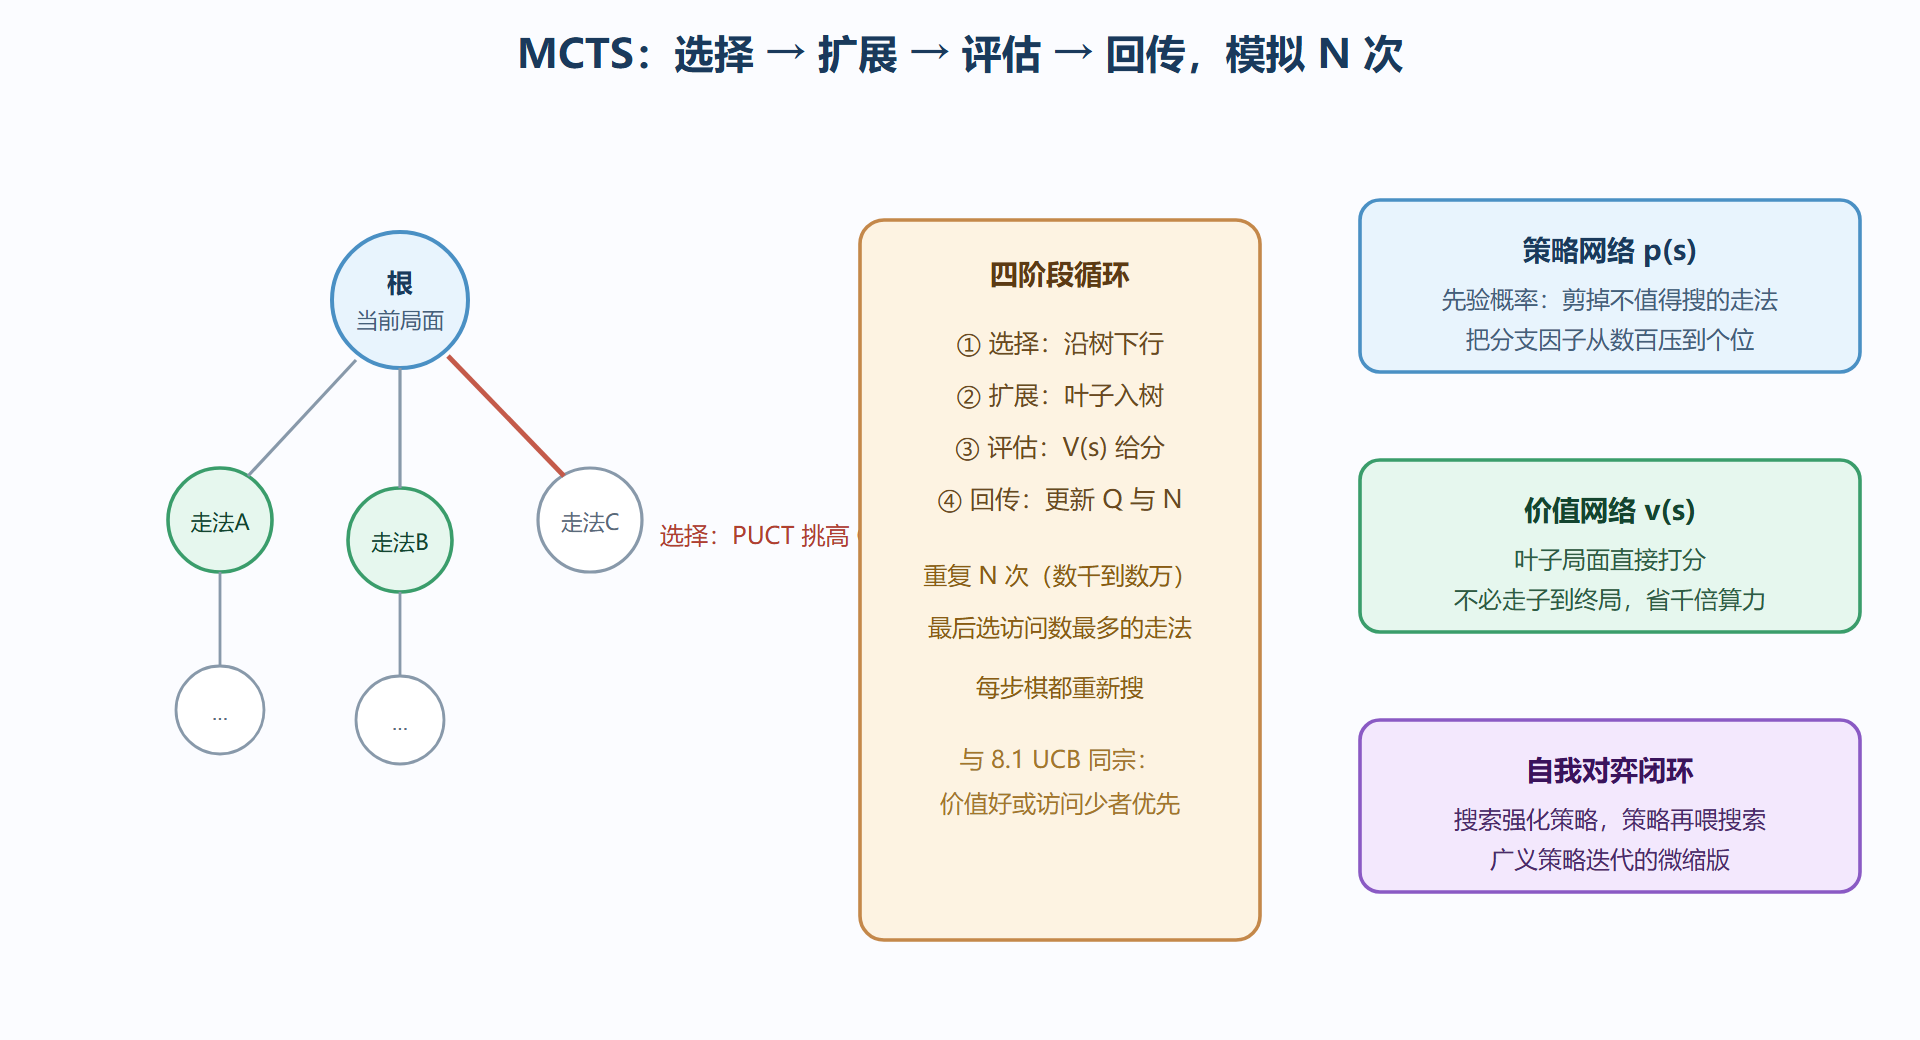
选择:从根节点沿树往下走,每个内部节点用 UCB 变体(PUCT)挑分支——Q 值高(历史战绩好)或访问少(探索奖金高)的孩子优先,公式与 ⟦undefined⟧ 节 UCB 同宗。扩展:走到叶子,把新局面加入树。评估:这个新局面值多少?两条路取加权——价值网络 V(s) 直接给分(快、有泛化),或快速走子到终局看胜负(慢但无偏,AlphaGo Lee 版用过、后续版本基本砍掉)。回传:把评估值沿来路回传,更新路径上每个节点的访问计数与平均价值。
N 次模拟后,根节点选访问次数最多的孩子作为实际落子(不是价值最高的——访问数才是搜索深度的投票)。搜索完走出一步,对手落子后,以新局面为根重新搜索(旧树的子树可以复用)。整个过程本质上是策略迭代在搜索树上的微缩版:搜索改进策略(每步走得更强),策略网络又被新对局数据继续训练——广义策略迭代的又一化身。
图:MCTS 四阶段循环与两个网络的剪枝分工
三、AlphaGo 的组合拳:每个部件堵一个洞
零起点直接 MCTS 在围棋上不可行——分支因子约 250,深搜几十层就是 250^40 的组合爆炸。AlphaGo 用两个网络把树剪成可行尺寸。策略网络 p(s) 给每个合法走法出先验概率:搜索时只在概率最高的少数分支展开(且 PUCT 公式里先验直接参与选择打分),分支因子从 250 压到 10 上下,等效搜索深度提升一个数量级。价值网络 v(s) 直接评估叶子局面,替代"快速走子到终局"——单次评估从千次模拟降到一次前向。自我对弈解决训练数据来源:让当前系统与历史版本对弈几万局,胜负标签训练价值网络、落子训练策略网络,两者变强后搜索更强,生成的对局质量更高——数据与模型交替升级的闭环。人类棋谱则是零起点的启动数据(AlphaGo Lee 版);到 AlphaGo Zero 连棋谱都不要,纯自我对弈从随机策略起步,反而超越前作——人类先验里有错误定式, zero 版不受其累。这是"数据来源"问题的一堂大课:专家数据是脚手架,不一定是地基。
四、无模型与有模型:合流的现代形态
把两条路线并排放:无模型(DQN、PPO)不学环境,靠海量真实交互硬学价值或策略,稳但费数据;有模型先学环境再规划,省数据但吃模型误差。现代强系统的共同形态是两者杂交:EfficientZero 把 MCTS 塞进无模型的样本预算里;Dyna 式架构用世界模型生成 imagined 数据喂 PPO;World Models 一线把"在梦中训练"推到极致。判断依据回到本源问题:**你的环境交互贵不贵?**游戏引擎免费转,无模型够用;机器人一次摔跤就是真金白银,模型的价值立现。
- 世界模型 = 可推演的环境替身;模型误差会被规划器放大利用(模型作弊)。
- MCTS 四阶段:选择(PUCT)、扩展、评估、回传;按访问数落子。
- AlphaGo 双网络分工:策略网络剪分支、价值网络省评估;自我对弈闭环训练两者。
- AlphaGo Zero 的教训:人类数据是脚手架而非地基,纯自我对弈可以更强。
- 无模型与有模型的合流是现代主流,选择依据是交互成本。
一次模拟的逐数字走查
拿一个分支因子只有 3 的玩具局面把四阶段走一遍,数字全部摆在明面上。根节点 S0,三个孩子 A、B、C。此刻树里 A 被访问过 20 次、Q 值 0.5;B 访问 10 次、Q 0.4;C 是新节点。第一次模拟的选择阶段:PUCT 得分 = Q + c·先验·√(总访问)/(1+访问)。设先验全为 0.3、c=1.5、总访问 30:A 得 0.5 + 1.5×0.3×√30/21 ≈ 0.5+0.118=0.618;B 得 0.4 + 1.5×0.3×√30/11 ≈ 0.4+0.224=0.624;C 未访问,得分 0 + 1.5×0.3×√30/1 ≈ 2.46——探索奖金把新节点直接顶到最前,模拟走向 C。扩展与评估:C 入树,价值网络给 v(C)=−0.2。回传:C 的访问变 1、Q 变 −0.2,路径上父节点按符号取平均更新。下一次模拟时 C 的探索奖金骤降为 1.5×0.3×√31/2 ≈ 1.25,若其 Q 没起色,模拟将转向别的分支。注意两个设计细节:新节点的一次"高定价"保证了每个分支至少被看一眼;而 Q 值更新用的是逐步平均,访问越多估计越稳、奖金占比越小——搜索强度自然从"广撒网"过渡到"深挖好分支"。AlphaGo 的真实搜索只是把 3 个分支换成几百个、把 v(C) 换成深度网络、把单次模拟重复几千次,骨架一模一样。
模型误差的量化与防御
"模型误差会被规划器放大"值得给出量化的样子。实验设计:真实环境是一维动力学(噪声 0.05),学习一个前向模型,然后把规划深度从 1 步拉到 10 步,统计每步规划的"模型预测与真实转移的平均偏差"。典型曲线:单步偏差约 0.03,三步累计 0.08,五步 0.15,十步 0.4——误差按步数超线性累积,因为规划器会专门挑选模型"自信但错误"的方向(误差相关性在分支选择里被放大)。防御三板斗各有价目。回溯 Horizon:规划深度减半,误差平方级下降,但远见也减半,适合误差主要来自长程的场景。不确定性感知:模型输出连同不确定度一起给规划器,深规划只在低不确定分支展开——代价是要多训练一个集成或贝叶斯头。真实数据校准:规划出的轨迹里按比例掺真实交互数据(Dyna 式),让价值学习不被模型轨迹独占——内存与管理成本换稳健性。选哪板斧的判据回到一句话:你的任务里,错一步的代价随深度怎么涨,涨得越快越要收缩 Horizon。