6.1 探索与利用进阶:UCB、Boltzmann 与好奇心
6.1 探索与利用进阶:UCB、Boltzmann 与好奇心
本节摘要:ε-greedy 的探索是"瞎均匀":不管哪个动作没被试过、试过多少次,一律等概率乱选。本章把探索升级成可计算的策略:UCB 给"不确定性高的选项"加置信加分,Boltzmann 按"温度"把价值转成采样概率,好奇心驱动则完全跳出外部奖励、用预测误差发内在工资。这三条线各有数学根基与失败模式,本节逐一过堂并给出选型建议。
一、ε 衰减只是入门答案
先复盘基础款的三个毛病。其一,不分青红皂白:ε 概率触发时,已被证明极差的动作与从未试过的动作等概率——探索预算被大量浪费在已知垃圾上。其二,对历史无知:探索强度只由外部时间表(ε 衰减曲线)决定,与智能体自己的知识状态无关——有的状态早该利用了,它还在乱掷骰子。其三,对状态无感:同一 ε 全局生效,而真实任务里"值得探索的状态"高度不均。升级的方向因此明确:让探索决策吃进不确定性信息。
二、UCB:给少见的选项发置信加分
UCB(置信上界)来自多臂老虎机的最优解。选臂时不再只看均值估计,而是看"均值估计 + 不确定性奖金":
选 argmax_a [ Q̂(a) + c · √( ln t / N(a) ) ]
N(a) 是动作 a 被选过的次数。公式读法:没被选过或选得少的动作,第二项大——像给陌生选项发探索补贴;选得越多补贴越小,ln t 保证总额度增长缓慢(数学上可证明遗憾界为对数级,优于 ε-greedy 的线性遗憾)。c 是探索系数,典型从 1 起调。把它搬进强化学习只需把"臂"换成"状态-动作对":Q̂(s,a) 用当前估计,N(s,a) 用访问计数。一个数字例子:动作 A 估计 0.8 试过 100 次,动作 B 估计 0.5 只试过 3 次,t=1000 时 UCB 的奖金分别是 c·√(6.9/100)=0.26c 与 c·√(6.9/3)=1.52c——c=1 时 B 的总分 2.02 反超 A 的 1.06,陌生选项获得一次机会;若 B 这次表现差,N 涨到 4,奖金骤降到 1.31c,几次之后它自然出局。**UCB 的探索是自适应的:越陌生越敢试,试过就收敛,不需要人工衰减时间表。**
三、Boltzmann:按温度采样
另一条升级路线不改"选谁"而改"怎么选":把各动作的价值经 softmax 变成采样概率,温度 T 控制分布的陡峭程度:
P(a) = exp(Q(s,a)/T) / Σ_b exp(Q(s,b)/T)
T 大时概率接近均匀(强探索),T 小时趋于贪心(强利用),训练中让 T 逐步退火即可。与 ε-greedy 的关键差别:乱选也按价值的比例乱选——次优但不错的动作比垃圾动作被选中的机会大得多,探索质量更高。数字例子:三个动作 Q 值 [1.0, 0.8, 0.2],T=1 时概率约 [0.44, 0.36, 0.20];T=0.5 时指数翻倍变 [0.53, 0.36, 0.11];T=0.1 时变成 [0.88, 0.12, 0.0003]——温度每降一档,最优动作的概率优势就放大一截,而最差动作几乎出局。Boltzmann 天然适配策略梯度思想(它就是一个参数化的随机策略),在第 5 章的框架里它不过是一个带温度调度的策略网络。
图:三种探索策略的决策依据对比
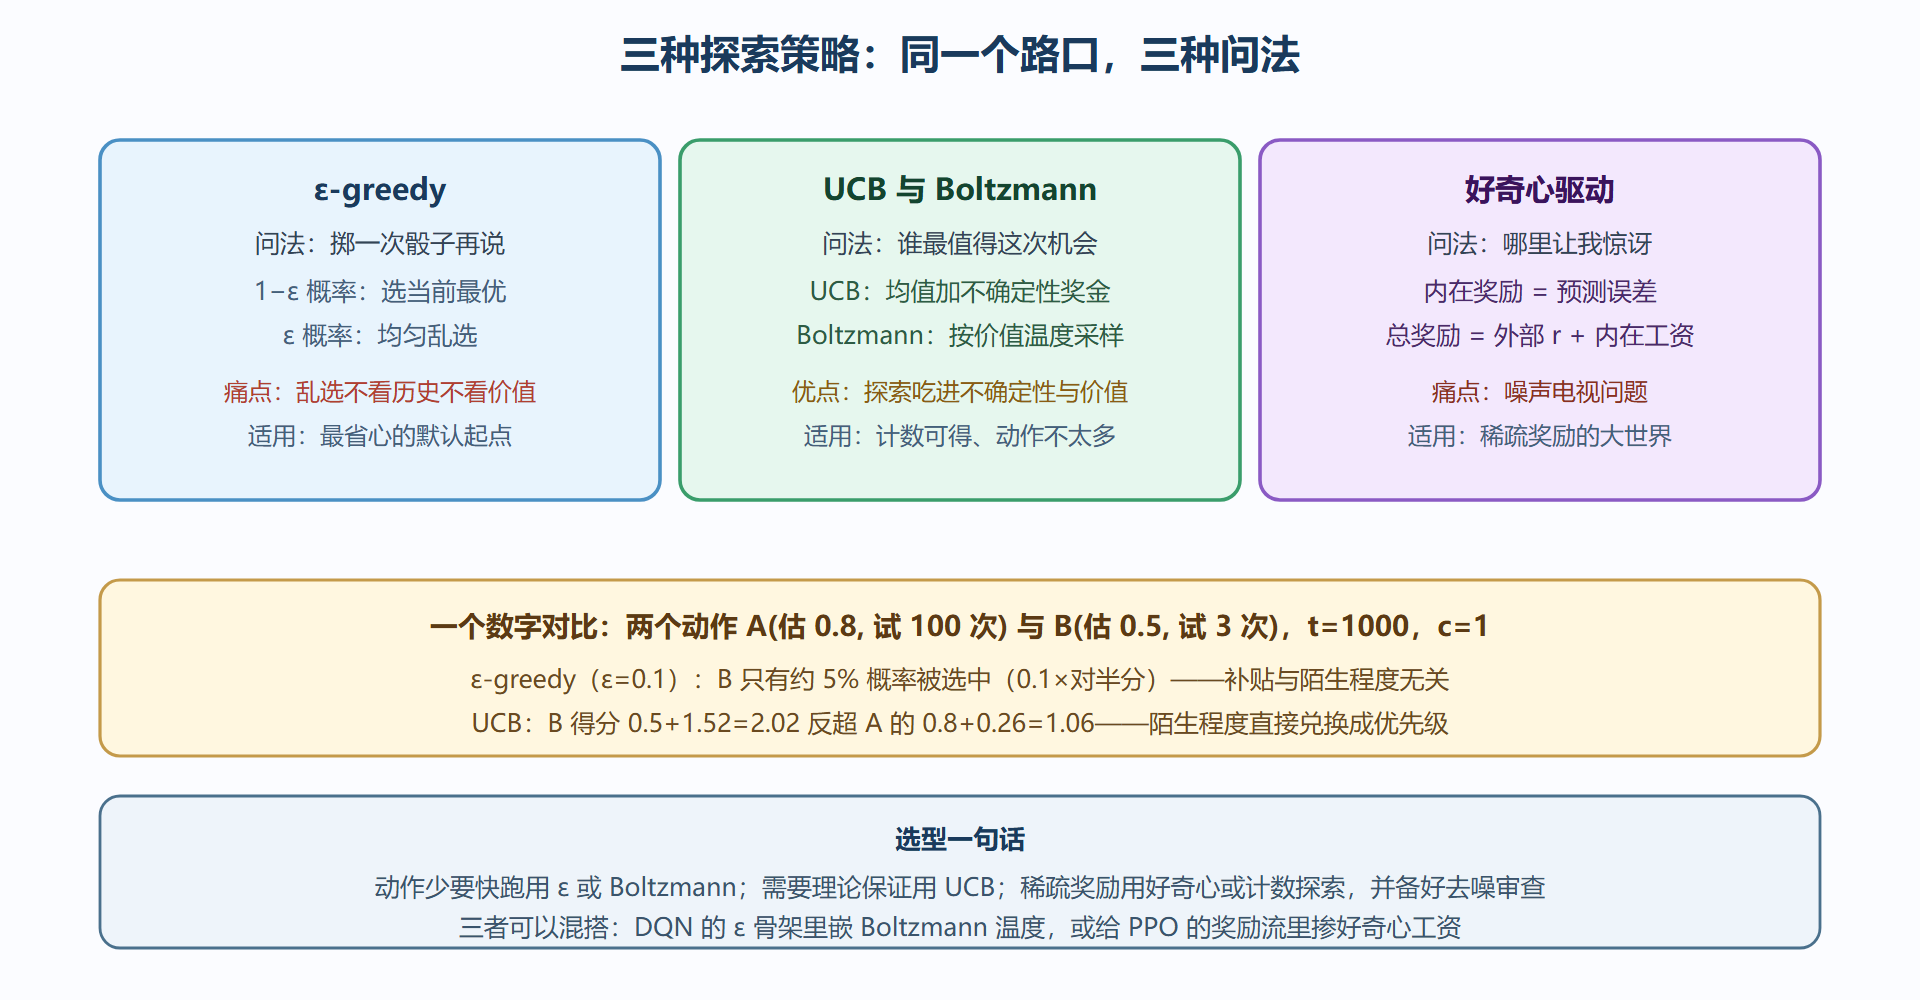
四、好奇心:给探索发内在工资
前两种策略仍在"外部奖励的框架内"优化。稀疏奖励任务(迷宫只有出口 +1,Montezuma 复仇只有钥匙才给分)里,外部信号稀薄到无法引导任何探索。好奇心驱动的思路釜底抽薪:给智能体发"内在工资"——预测误差。实现是一个可训练的前向模型 f(s,a) 预测下一状态,真实 s' 与预测的差(编码空间里算距离)就是内在奖励 r_int。模型预测不准的地方(= 见得少的地方)工资高,智能体自然被吸向新奇区域;随着经验积累,熟悉的区域预测变准、工资归零,注意力自动转向新区域。
内在奖励与外部奖励相加进总回报,任何算法(DQN、PPO)都能直接吃。威力在稀疏奖励上立竿见影:经典实验里,纯外部奖励的智能体在 Montezuma 复仇上得分为零,加好奇心后能稳定找到第一把钥匙。但它的失败模式同样著名——噪声电视问题:把一台显示随机噪声的电视放进环境,随机画面的预测误差永远不降,智能体会被吸在电视机前看到天荒地老。预测误差混淆了"新奇"与"随机";修补思路包括学习一个随机性感知的模型(只对可预测的随机性好奇)、用逆动力学模型定义"可控制的新奇"(ICM 的做法)等。这条线提醒我们:内在动机的设计本身就是一个奖励设计问题——第 1 章的"奖励作弊"教训,在内在奖励上原样重演。
五、选型与实操清单
- ε-greedy:默认起点,实现零成本;动作空间大时探索效率低。
- UCB:需要动作计数,适合表格或低维离散动作;理论遗憾界漂亮。
- Boltzmann:与策略梯度无缝衔接;温度调度是额外超参。
- 好奇心:稀疏奖励的大世界;必须审查"噪声电视",内在奖励系数常设为外部奖励的 0.1 到 1 倍量级。
- 实操检查表:训练日志里记录"每个动作的访问计数分布"——若尾部动作长期为零,探索在白干。
探索预算的账本:一次完整对比
把三种策略放进同一个十臂环境跑两万步,记录两个量:总奖励与"最优臂占比"(最优臂被选中的频率)。典型结果长这样。ε-greedy(ε=0.1 固定):总奖励居中,最优臂占比稳定在 0.9 附近——但注意它有 10% 的预算永远浪费在随机臂上,其中大量是已知垃圾臂。UCB(c=1):前五百步总奖励落后(探索补贴凶),之后反超并贴着理论上限走,最优臂占比爬到 0.97 以上;它的遗憾(与全知最优的差距)按对数增长,两万步时只有 ε-greedy 的三分之一。Boltzmann(T 从 1 退火到 0.1):走势介于两者之间,温度调好后与 UCB 接近,但对价值估计的尺度敏感——Q 值整体放大十倍,等价于温度缩小十倍,超参随任务量级漂移是它的额外维护成本。三份账本读出的结论一致:探索策略的差异在短程最明显,长程都会收敛到好策略;任务交互越贵,越值得为 UCB 类的"不确定性感知"多付的实现复杂度买单。
稀疏奖励任务的探索配方
把本节工具组合成一个稀疏奖励任务(只有通关才有 +1)的完整配方。第一层,计数探索:对状态(或其编码)做访问计数,未访问或低访问的状态给探索奖金——这是最便宜的"好奇"替身,玩具任务上就够用。第二层,好奇心模块:状态高维(图像)时计数失效,换前向模型的预测误差当内在奖励,权重设为外部奖励量级的 0.5 到 1 倍,同时给内在奖励加天花板防止单点吸干预算。第三层,探索起点与课程:随机开局(每个回合从随机状态出发)直接制造状态覆盖,比任何内在奖励都便宜;课程式地把目标距离逐步拉远,让"倒灌"的涟漪(第 3 章的图像)始终有相邻的已知 territory 可以扩张。第四层,审查:日志里盯两个指标——单位时间新状态发现率(应先高后低)与内在奖励占比(训练后期应趋近零)。占比不降说明前向模型没学好或在"噪声电视"前驻足,发现率长期为零说明探索已死、该换层了。四层按成本从低到高叠,多数任务用不完三层。