6.8 框架与环境:Gymnasium 与 Stable-Baselines3
6.8 框架与环境:Gymnasium 与 Stable-Baselines3
本节摘要:从零实现一个 DQN 或 PPO 是理解算法的最好方式,但做项目时重复造轮子是浪费。生态已经把轮子造好:Gymnasium(原 Gym 的继承者)定义了环境的标准接口,Stable-Baselines3 提供一套经过验证的算法实现,两者拼起来就是"十行代码跑通 PPO"的现代工作流。本节讲清标准接口的五要素、自定义环境的包装要点与常见坑、向量化并行加速,以及算法库的正确打开方式——基线先行,再考虑自研。
一、工具链的三层结构
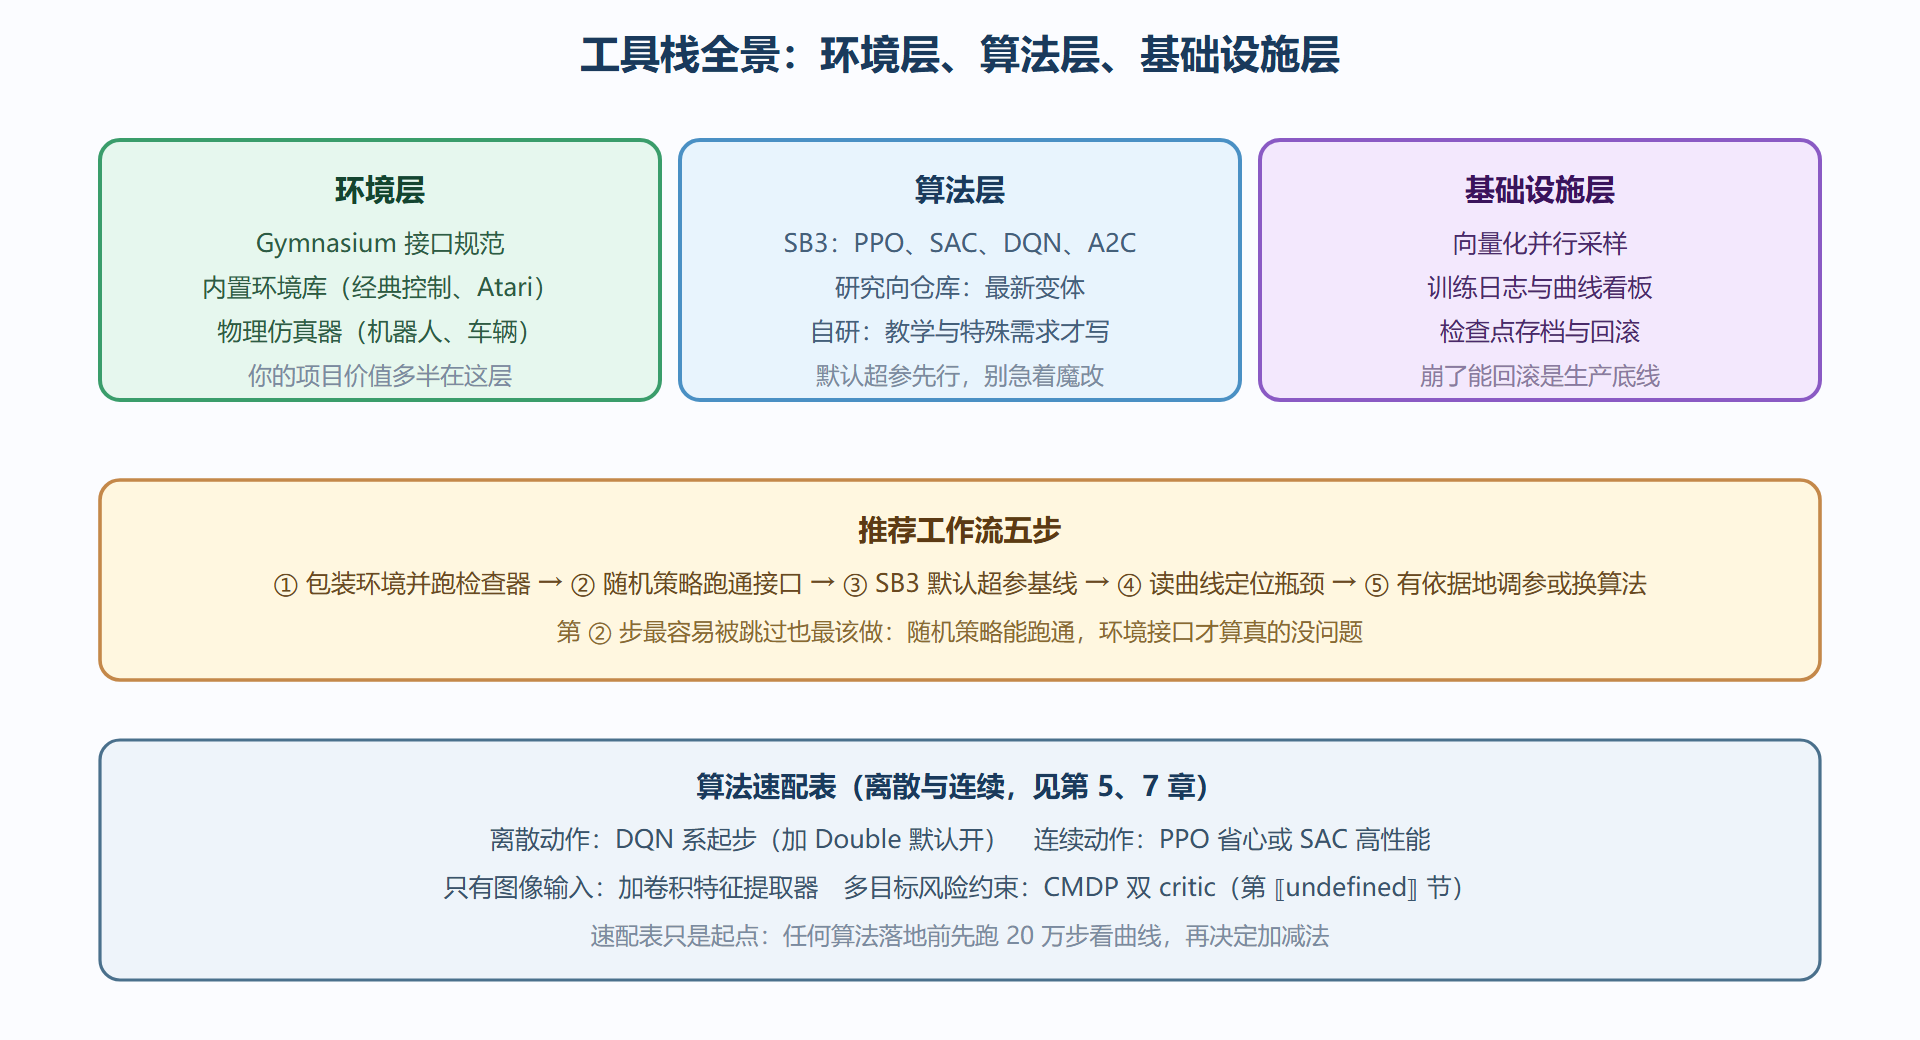
把一个强化学习项目拆开,从下到上三层。环境层:任务的仿真或接口,负责"收动作、给状态与奖励"。算法层:训练循环与网络更新。基础设施层:日志、存档、评估、并行采样。自己写代码意味着三层全包;用生态则环境层交给 Gymnasium 接口规范,算法层交给 Stable-Baselines3(以下记作 SB3),基础设施层的大部分由两者的配套设施覆盖。分层认领后,你的精力可以从"写对训练循环"转移到"把环境建模对"——后者才是项目的价值所在。
二、Gymnasium:环境的标准接口
一切环境实现同一组约定,核心五件套:reset() 开新回合返回初始观测与信息;step(action) 推进一步返回五元组(观测、奖励、terminated、truncated、info);action_space 与 observation_space 声明动作与观测的形状类型;render() 可视化。两个 terminated 与 truncated 的区分是老 Gym 教训的遗产——前者是任务真的结束(到达终点、失败),后者是人为时间截断,价值学习只认前者清零未来项(1.3 节的规矩在这里落地成接口约定)。
用这套接口把本书的 4×4 网格世界包装成"正规军":
import gymnasium as gym from gymnasium import spaces import numpy as np class GridWorld(gym.Env): def __init__(self, size=4): super().__init__() self.size = size self.action_space = spaces.Discrete(4) # 上下左右 self.observation_space = spaces.Box(0, size - 1, shape=(2,), dtype=np.int32) self.goal = (0, size - 1) # 右上角出口 def _obs(self): return np.array(self.pos, dtype=np.int32) def reset(self, seed=None, options=None): super().reset(seed=seed) self.pos = (self.size - 1, 0) # 左下角出发 return self._obs(), {} def step(self, action): dr, dc = [(-1,0),(1,0),(0,-1),(0,1)][action] r = min(self.size - 1, max(0, self.pos[0] + dr)) c = min(self.size - 1, max(0, self.pos[1] + dc)) self.pos = (r, c) terminated = (self.pos == self.goal) reward = 1.0 if terminated else -0.04 return self._obs(), reward, terminated, False, {}
包装自定义环境的高频坑有三个,踩过的人都懂。其一,观测范围与声明不符:observation_space 声明 0 到 3,代码却让坐标爬到 4——向量化环境下直接崩溃,且报错位置离病灶十万八千里;写完先跑官方的检查器(环境检查工具会自动遍历边界)。其二,回合忘了终止:智能体卡在死角永远走不完,训练"卡住"的假象其实是环境永不 reset。其三,奖励泄漏随机性量级:奖励里混入大幅随机项(比如按真实股价结算),学习信号被噪声淹没——在包装层就把奖励归一化掉。
三、SB3:算法的正确打开方式
环境齐了,训练只剩几行:
from stable_baselines3 import PPO from stable_baselines3.common.env_util import make_vec_env from stable_baselines3.common.evaluation import evaluate_policy env = make_vec_env(GridWorld, n_envs=8) # 8 个环境副本并行采样 model = PPO("MlpPolicy", env, verbose=1, learning_rate=3e-4, n_steps=128, batch_size=64) model.learn(total_timesteps=100_000) mean_r, std_r = evaluate_policy(model, env, n_eval_episodes=20) print(f"评估: {mean_r:.3f} ± {std_r:.3f}")
这段代码里有三个工程习惯值得养成。向量化并行(make_vec_env 的 n_envs):8 个副本同时采样,单位墙钟时间的样本量翻倍不止,还顺带稀释了样本相关性(5.3 节 A2C 的红利在这里白拿)。训练与评估分离(evaluate_policy):训练时的回报是探索策略挣的(带 ε 或熵噪声),评估才是贪婪策略的真实水平;混为一谈会误判收敛。回调监控:用配套的日志回调(如 EvalCallback、CheckpointCallback)定期评估并存档,训练崩了能回滚到最优检查点,而不是从头再来。
SB3 之外的版图一句话带过:要最新算法(Rainbow、SAC 变体、离线 RL)看研究向仓库;要超大规模分布式(成百环境、多机)看工业向框架;要做严肃仿真(机器人、自动驾驶)配物理引擎级仿真器。SB3 的生态位是"文档全、接口稳、默认超参能打"——对大多数项目,它的默认配置就是你该从哪开始的地方。
图:强化学习工具栈全景——从仿真到交付的装配线
四、从基线到自研的决策线
什么时候该自己写算法?决策线画三条。默认用 SB3 默认超参——大多数任务的性能天花板取决于环境建模与奖励设计,不在算法细节。默认超参跑不动、且诊断指向算法机制(比如高估病、外推病)——先开 SB3 已有的开关与变体,仍不够再考虑换算法族。只有研究性质的特殊需求(新探索机制、非标准约束)才值得自研,且自研时也建议"先复现基线再改",确保代码正确性有对照。把这条决策线反过来读就是本书前八章的位置:理解机制(算法层为什么这样设计)是为了在第三层决策时有判断依据,而不是为了天天造轮子。
- 三层结构:环境层(项目价值所在)、算法层(生态成熟)、基础设施层(生产底线)。
- Gymnasium 五件套:reset、step、两个 space、render;terminated 与 truncated 必须分清。
- 自定义环境先跑官方检查器;观测越界、回合不终止、奖励带噪声是三大坑。
- 向量化并行提采样吞吐,评估与训练分离防误判收敛。
- 基线先行:默认超参 → 开已有开关 → 换算法族 → 才轮到自研。