6.9 训练技巧与调试:奖励设计与收敛诊断
6.9 训练技巧与调试:奖励设计与收敛诊断
本节摘要:强化学习项目的失败,八成不在算法而在两处:奖励写歪了,或曲线读不懂。本节前半给出奖励设计的工程守则与"塑形过度"的反例,后半是一份六种典型训练曲线的病因对照表——每条曲线长什么样、病灶在哪、先动哪个旋钮。这是全书算法知识的"诊断科":前几章讲的每个机制(倒灌、方差、高估、外推)都会在这里变成曲线上的具体长相。
一、训练曲线是最诚实的老师
调试强化学习与调试普通程序的方法论不同:它很少有崩溃栈,只有缓慢说谎的数字。训练在跑、损失在降、奖励在涨,全都不代表它在学对的东西——奖励可能涨向一个作弊解,损失可能在向错误的收敛点前进。因此第一守则:**永远同时看多条曲线,单曲线不说明问题。**最小监控集是四条:回合奖励(滑动平均)、回合长度、价值估计均值(Q 或 V)、策略熵(或探索率的实际触发频率)。四条曲线的相对走势,比任何单条的绝对值更有信息量:奖励涨而熵骤降,可能是过早收敛;价值均值上飘而奖励平躺,是高估病的标准脸。
二、奖励设计:写目标函数,不是写分数
奖励设计的守则可以压成五条。其一,先写规范目标,再谈塑形:把"你到底想要什么"用一句话说清(安全送达、最大化净收益),确认奖励函数是它的单调代理,而不是拍脑袋的分数堆。其二,每项奖励都要过审问:"这一项会激励什么投机行为?"清扫任务的罚灰尘项,会激励把灰尘扫进地毯下(第 1 章的例子);电商奖励点击,会诱导标题党。其三,量级配比显式化:主任务奖励与每步时间罚、中间进展奖的比值,决定智能体的行为优先级——终局 +1 配每步 -0.04,等价于告诉它"20 步内到才划算";这些数字要按任务时距(1.2 节的 γ 视野)联合设计。其四,警惕稀疏与稠密的两端:纯稀疏学不动,过度稠密则塑形绑架目标(下述反例)。其五,留一个"奖励消融"实验:把可疑的奖励项删掉重训一次短程,看行为是否明显变化——变了说明该项在主导策略,需要复查它是否忠于意图。
塑形过度的经典反例值得完整讲一遍。某个赛船游戏的奖励设计是"穿过检查点加分",且检查点可以来回刷。智能体学出的策略:在两个相邻检查点之间画圈刷分,永不冲线——奖励函数字面上最优,任务目标完全落空。修复思路是给单项奖励加"距离终局的进展"约束(势函数塑形:只在真实缩短了与目标的距离时给分,数学上可证不改变最优策略)。判断塑形是否绑架了目标,就看智能体的策略里有没有"刷分动作"——那些人类玩家绝不会做、却反复出现的行为。
三、超参调优的次序与幅度
超参不是均匀重要,按敏感度排队动手(与 4.4、5.5 的算法级清单互补,这里是全局次序)。第一梯队:学习率与 γ——先按任务时距钉死 γ(迷宫百步任务 0.99,短视任务 0.9),再扫学习率(数量级扫:1e-3、3e-4、1e-4)。第二梯队:探索参数(ε 衰减速度或熵系数)——探索不足的曲线特征是早熟平台,过度则收敛极慢。第三梯队:批大小、网络宽度、目标更新节奏。第四梯队:各种变体开关。每次只动一个参数、固定随机种子跑两到三个种子取均值——强化学习的种子方差巨大,单次实验的结论经常是噪声。预算有限的土办法:先用十分之一训练量粗筛参数组,再对入围者全程训练。
四、六种典型曲线的病因对照
图:训练曲线诊断图——六种病脸与先动的旋钮
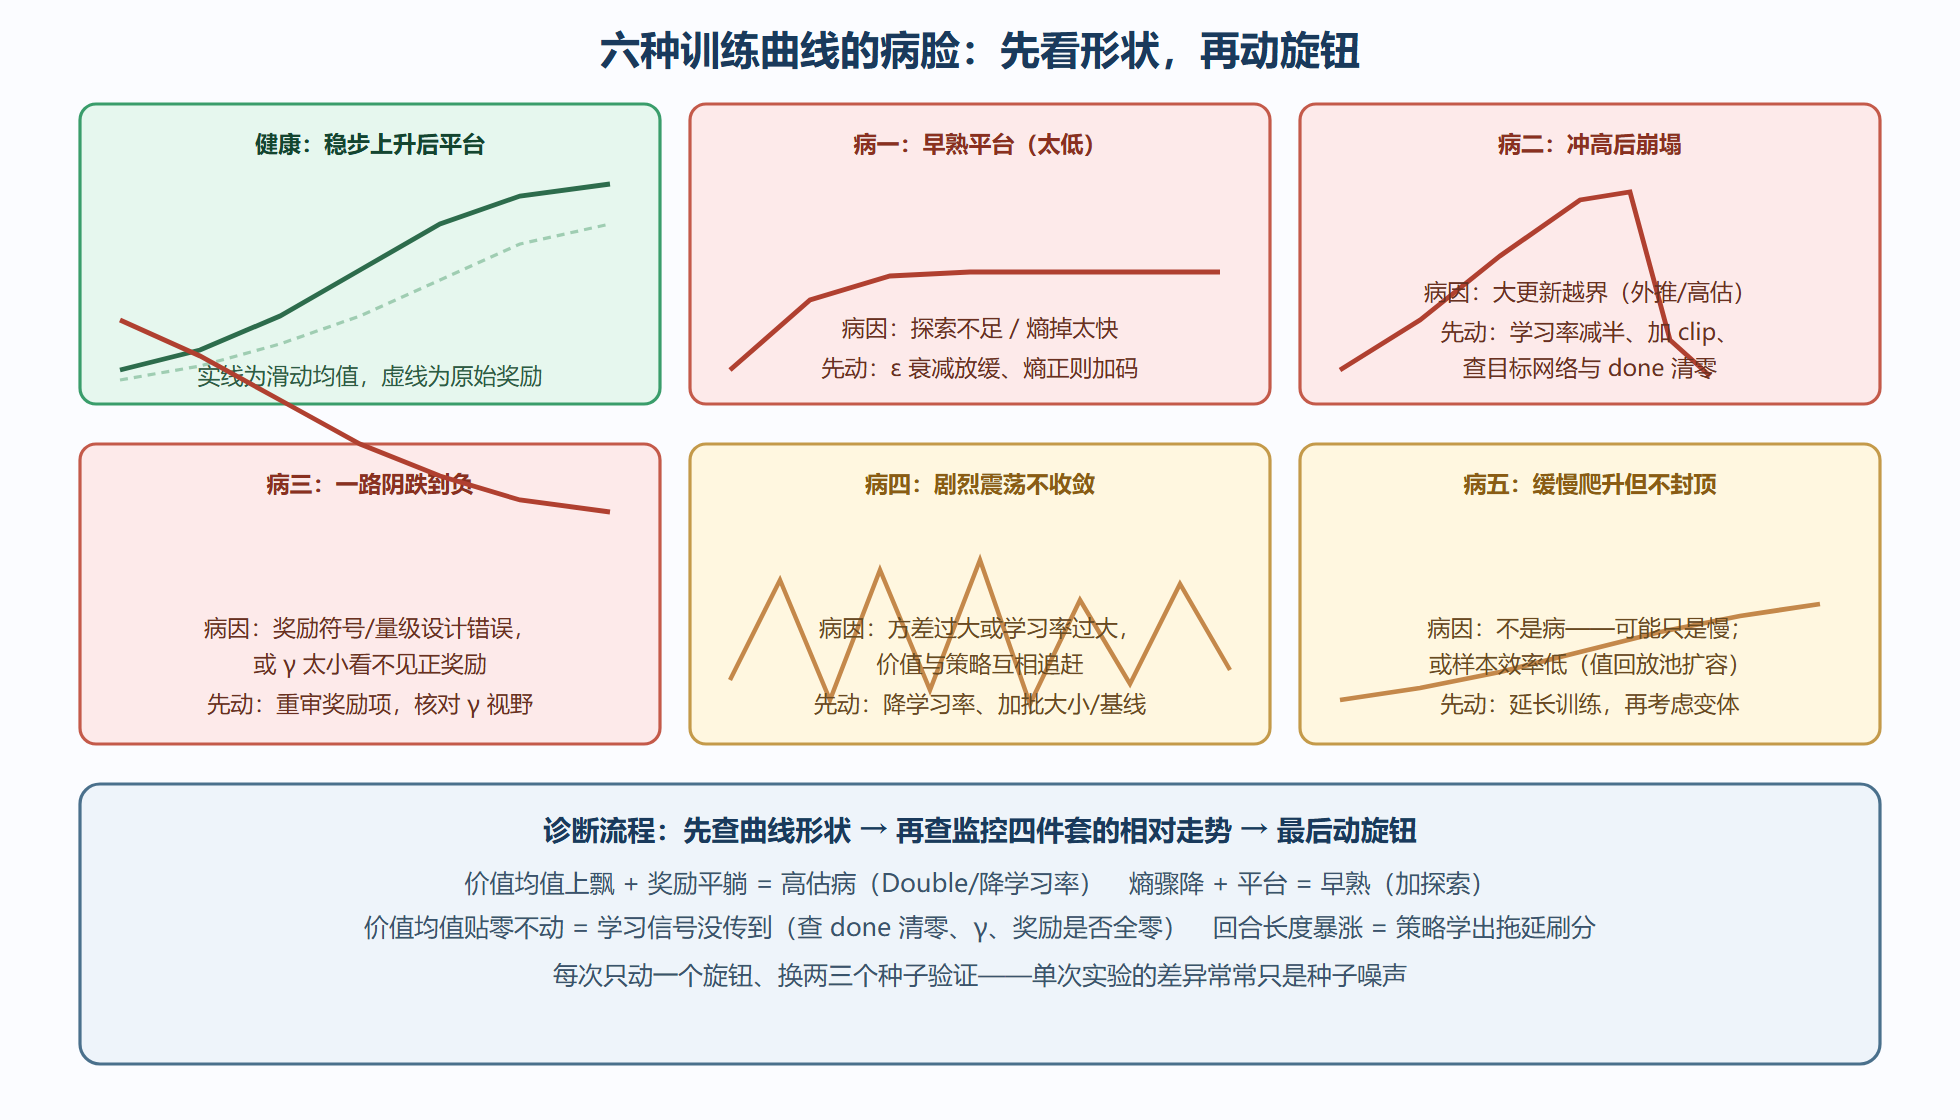
对照图的用法是"先分诊再开药"。两个组合症状特别值得记。价值均值上飘 + 奖励平躺:高估病的标准组合(第 3 章埋线、第 4 章 Double DQN 兑现),先降学习率再上变体。回合长度暴涨 + 奖励平稳:策略在"拖延刷分"——每步惩罚太小或有可刷的中间奖励,回奖励设计层整改。还有一个反直觉提醒:评估回报与训练回报要分开看——训练回报是探索策略挣的,收敛判断只看贪婪评估;训练回报不涨而评估回报涨,恰恰说明探索在退火、策略在纯化,是好现象。
五、收敛之后:别急着庆祝
训练曲线平台了,还有三道验收。种子验收:至少三个种子都到同量级平台,单种子平台可能是运气。过拟合检查:换随机种子开局、或环境参数微扰(摩擦力加减一成)重评估——性能断崖说明策略背下来了特定轨迹而非学会了策略,仿真任务的常见病。行为审视:录几段策略执行的视频亲眼看,许多"指标健康"的策略会做出人类一眼看出危险或荒谬的动作——指标是代理,眼睛才是最终裁判。这三道过完,才谈得上"训练收敛"四个字。
- 同时监控四条曲线:奖励、回合长度、价值均值、策略熵;相对走势比绝对值重要。
- 奖励设计五守则;塑形过度的标志是"刷分动作"——人类绝不会做、策略反复做的行为。
- 调参次序:γ 与学习率 → 探索 → 批与结构 → 变体开关;一次一个旋钮多种子验证。
- 六种病脸:早熟、崩塌、阴跌、震荡、慢爬,以及"不是病"的健康慢。
- 收敛后三道验收:多种子、参数扰动、录像目检。
一次完整诊断的现场还原
把诊断流程走成一次实录。现象:PPO 在自定义仓储环境上训练二十万步,回报平台在 40 左右,业务方预期是 90。第一步看四件套:熵已经掉到初值的 3%,价值损失平稳,回合长度从 60 步涨到 210 步——回合变长而回报不涨,第一嫌疑是"拖延刷分"。第二步核对奖励项:发现每步有一个很小的"减少积压"正奖励,而积压可以通过来回倒货维持——奖励字面上最优、业务上无意义,与赛船绕圈的病理相同。第三步修奖励:把"积压减少量"改为"积压相对初始值的净下降"(势函数式塑形,只认净进展不认动作),重训。第四步看响应:回合长度回落到 70,回报平台升到 85,熵回升到 12%——两个症状同时缓解,说明病灶判断正确。整个诊断用了三轮短程实验(各五万步),耗时不到一个工作日。这次还原想传达的不是技巧清单,而是工作方式:曲线异常先假设"奖励在激励错误行为",用回合长度与熵佐证,再核对每一项奖励的激励语义——顺序反了,调参就是无底洞。
奖励设计的四个反向审查问题
正向设计容易,反向审查难——写完奖励函数后强迫自己回答四个问题。问题一:把奖励函数给一个"只懂优化不懂意图"的optimizer,它可能找到的最荒谬的极值点是什么?想不出来就真的跑一个随机搜索看它往哪钻。问题二:奖励的每一项量纲是否可比?时间罚以秒计、能耗罚以焦耳计、任务奖以次数计,加在一起之前没换算,就等于让智能体自己投票决定什么重要。问题三:有没有"免费的中间状态"?凡是智能体可以反复进出、反复领分的状态(检查点、积压减少、温度回到区间),都是刷分候选。问题四:稀疏到什么程度?估算一下随机策略平均多少步能碰一次非零奖励——超过有效视野(1/(1-γ))的量级,学习信号就传不回来,需要塑形或课程。四个问题答完,通常能拦下大半的奖励事故;剩下的小半,交给训练曲线去暴露——那时你已经知道该往哪里看了。