4.2 全局路径规划:Dijkstra 与 A 星
4.2 全局路径规划:Dijkstra 与 A 星
本节摘要:全局规划在已知地图上找一条从起点到目标的最优路。本节从 Dijkstra 的盲目扩张讲起,用一组扩展次数的数字引出 A* 的启发函数,给出可采纳性与一致性两条设计准则,并附一份能跑的栅格 A* 代码。
两个数字,看清 A* 赚在哪
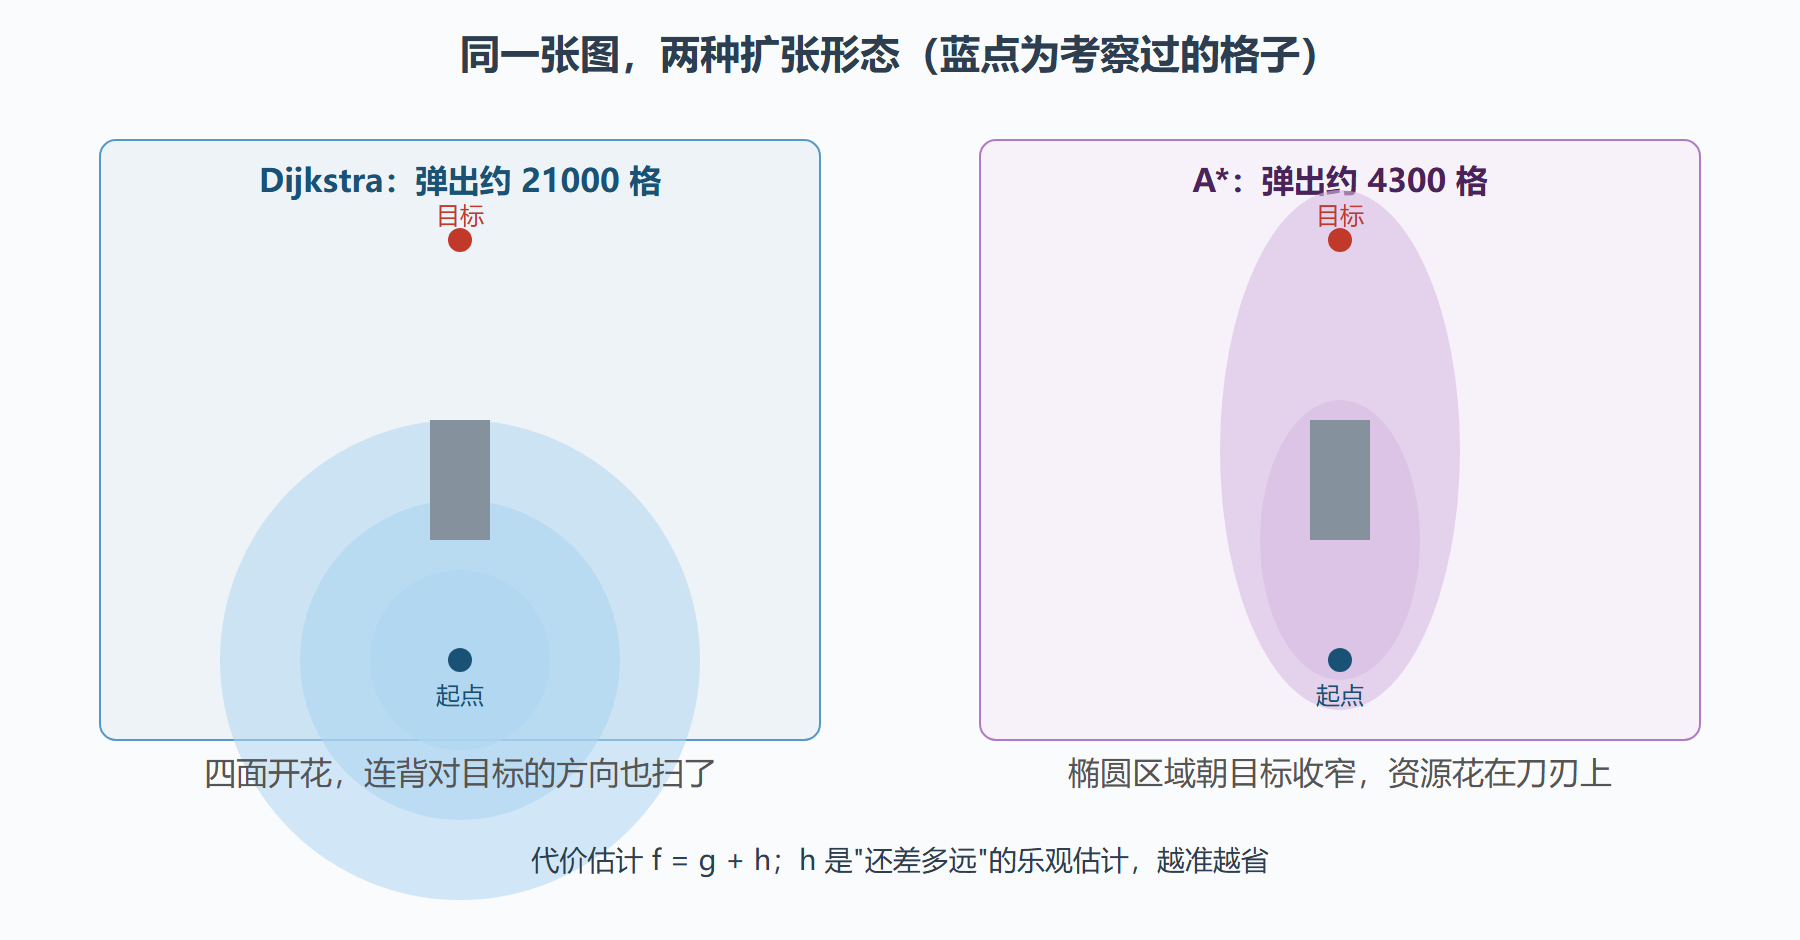
同一张 200×200 栅格图,从左下角到右上角,中间一道带门的墙。两个算法各跑一遍,统计"从优先队列弹出了多少个节点"(即考察了多少格):Dijkstra 均匀向四周扩张,弹出约 21000 个节点;A* 用欧氏距离当启发函数,弹出约 4300 个。五倍的差距来自同一个思想——Dijkstra 只回顾过去(到起点已花多少),A 还展望未来(到目标还差多少)*。展望越准,瞎逛越少。
A* 对每个节点维护估计值 f(n) = g(n) + h(n):g 是起点到 n 的实际代价,h 是 n 到目标的估计(启发函数)。h 恒为零就退化成 Dijkstra。
启发函数的设计准则
h 不是随便猜的,两条数学性质决定 A* 的行为:
可采纳性(admissibility):h 永不高估真实剩余代价。此时 A* 找到的路必是最优的。曼哈顿距离(|Δx|+|Δy|,四邻接栅格的精确下界)、欧氏距离(直线距离,任何移动方式的理论下界)都可采纳。
一致性(consistency):h(n) ≤ c(n, n′) + h(n′),即启发值沿任何一条边的变化不超过边代价。一致的启发必然可采纳,且保证节点第一次被弹出时其 g 值已是最优——不用重复扩展,工程实现更省心。
选哪个 h 有讲究,数字说话:四邻接栅格用曼哈顿距离最"紧"(恰好等于真实下界,搜索量最小);八邻接(允许斜走)用对角线距离(切比雪夫式修正);连续空间用欧氏距离。启发越紧、越接近真值,A 扩展的节点越少*——极端情形下 h 正好等于真实代价,A* 直奔目标零弯路。
图:Dijkstra 均匀扩张与 A* 定向扩张的形态对比
栅格 A* 完整实现
import heapq, numpy as np NEIGH = [(-1,0,1.0),(1,0,1.0),(0,-1,1.0),(0,1,1.0), (-1,-1,1.414),(1,1,1.414),(-1,1,1.414),(1,-1,1.414)] def astar(grid, start, goal): """grid: 占据栅格(True=不可走),八邻接,切比雪夫启发""" H, W = grid.shape def h(p): # 八邻接下界:对角线距离 dx, dy = abs(p[0]-goal[0]), abs(p[1]-goal[1]) return (dx + dy) + (1.414 - 2) * min(dx, dy) openq = [(h(start), 0.0, start)] g = {start: 0.0} came = {start: None} popped = 0 while openq: f, gc, cur = heapq.heappop(openq) popped += 1 if cur == goal: # 一致启发:弹出即最优 path, node = [], cur while node: path.append(node); node = came[node] return path[::-1], popped for dx, dy, c in NEIGH: nxt = (cur[0]+dx, cur[1]+dy) if not (0 <= nxt[0] < H and 0 <= nxt[1] < W): continue if grid[nxt]: continue # 膨胀障碍 ng = gc + c if ng < g.get(nxt, float('inf')): g[nxt] = ng; came[nxt] = cur heapq.heappush(openq, (ng + h(nxt), ng, nxt)) return None, popped
读代码时注意两处工程细节:字典 g 兼任"已访问"与"代价记录",松弛条件 ng < g.get(...) 保证更短的路径能覆盖旧记录;一致性启发下目标弹出即刻返回,省掉一遍收尾松弛。
全局规划的另一半真相
权重化 A(Weighted A)**:f = g + ε·h,ε 取 1.5 到 3,放弃最优性换速度,路径长度增加通常不到 10%,扩展节点数减半以上——实时系统里几乎都是它的地盘。
动态环境:地图变了(新障碍出现)整条路作废重搜太浪费。D* Lite 类增量算法记住上一轮的搜索成果,只修复受影响的部分;高频重规划场景(探索机器人)收益巨大。
h 的局限:启发函数只看得见几何,看不见动力学——它不知道差速底盘不能横着走、不知道转弯要减速。所以全局路径只是"粗坯",能不能走要交给局部层(4.3)与轨迹层(4.5)修正。
⚠️ 常见坑:在膨胀图上用 A*,忘了膨胀是"安全声明"而非"物理墙"。机器人停在离膨胀格一厘米处被误判为碰撞,其实是把"我不该去"当成了"我不能在"。分层检查(规划用膨胀图、执行前用真实障碍复核)可解。
本节要点
- A* = Dijkstra + 未来展望:f = g + h,h 越紧搜索越省,可采纳保最优、一致性保效率。
- 启发函数按邻接方式选下界:四邻接用曼哈顿、八邻接用对角线、连续空间用欧氏。
- 权重化 A* 用 10% 的路径长度换一半以上的搜索量,实时系统默认选项。
- 全局路径是粗坯:几何最优不等于运动学可行,后续要靠局部层与轨迹层打磨。
跳点搜索:均匀栅格上的再提速
A* 在均匀大栅格上仍有大量"没必要的对称扩展"——大片空地上的搜索等价于同一个问题的无数种平移。跳点搜索(JPS)利用栅格的对称性剪枝:只在"被迫邻居"(障碍强制的转折点,即跳点)处停下递归,中间的直线与对角推进一步到位。效果在开阔地图上非常显著:扩展节点数再降一到两个数量级,且保持最优。代价是 JPS 只适用于均匀代价的八邻接栅格——代价地图里的衰减梯度一出现,前提就破了。工程分工因此清晰:粗网格全局搜索用 JPS,带代价梯度的精细搜索用加权 A*,两层配合各取所长。
内存与时间的工程账
大规模栅格搜索的内存账:open 集合用优先队列(二叉堆),closed 用哈希表,200 乘 200 的地图全程搜索峰值内存可控;但 5000 乘 5000 的园区级地图就会吃力。三个省内存的手法按代价排序:一是"lazy expansion"——格子不预先分配,访问到才创建;二是分块搜索——先在粗分辨率(10 倍降采样)上搜出走廊,再只在走廊附近的高分辨率上精搜,内存与时间双双下降一个量级;三是路径缓存——高频重复的起终点对缓存结果,地图版本变更时整体失效。时间账里还有一条常被忽视:启发函数的内层调用次数是扩展数的常数倍,把曼哈顿距离这类简单启发写成内联计算,整体耗时可有可感知的下降。
问题:路径找到了但"穿过"禁区边缘怎么办
大概率是代价图与禁区图的优先级没理顺。禁区必须编码为"不可通行的硬约束"(代价 254 且膨胀层不得削它),而不是高代价的软惩罚——软惩罚在加权 A* 的大 epsilon 下会被绕行的成本收益"说服"穿越。规范做法是代价图分层时把禁区层置顶且不可覆盖,并在单元测试里放一条"任何路径到禁区的最小距离不小于零"的断言,让这类错误在回归测试里现形而不是在验收现场。