6.1 学习型机器人
6.1 学习型机器人
本节摘要:强化学习让机器人从试错中自己长出控制与规划策略,模仿学习让它从人类示范里偷师。本节讲清两种学习的数据来源与适合任务、仿真到实机迁移的差距根源,以及学习方法替代不了传统方法的那些部分。
一段历史里的转折
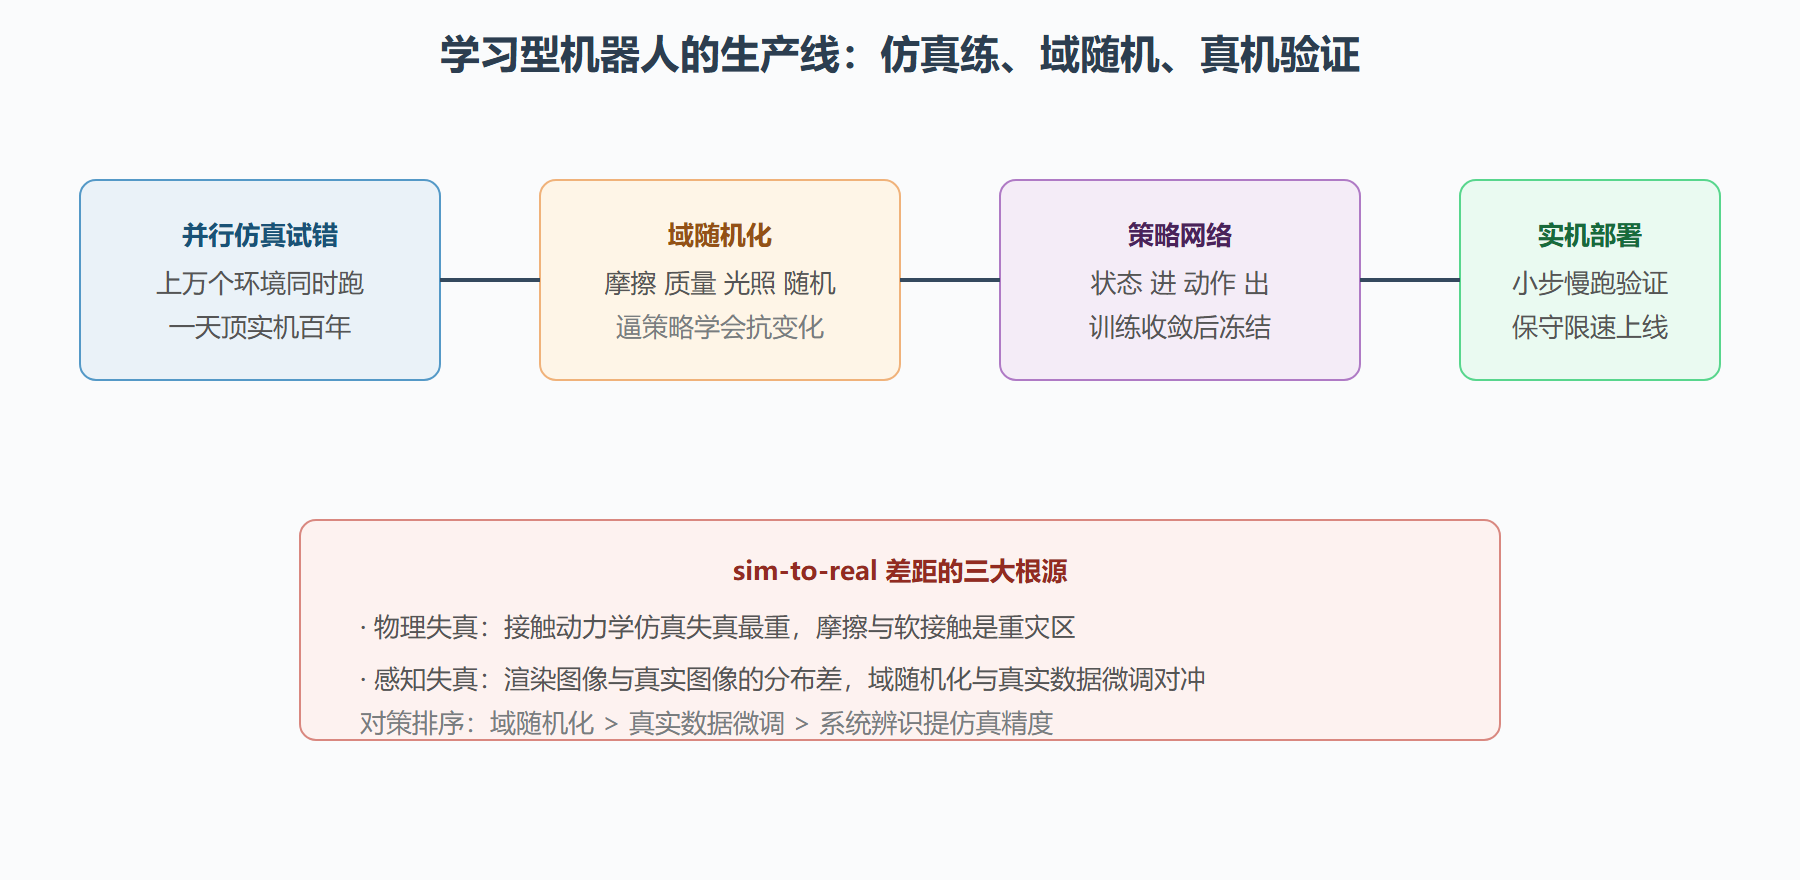
早期的强化学习机器人实验有个共同画面:机械臂在桌面上抖动上万次,试图学会把方块推到指定位置——能学成,但试错成本让工业界直摇头。转机发生在两条线上。一是仿真并行化:在虚拟环境里同时跑上万个机器人试错,一天 equivalent 于实机百年;二是 2015 年后深度网络接手策略表示,非线性高维问题(视觉输入直接输出动作)从不可能变成日常。今天四足机器人穿越乱石滩的灵活动作、机械臂抓取不规则物体的策略,多数出自这条"仿真试错 + 真实迁移"的流水线。
两种学习,两种数据
强化学习(RL):不给人示范,只给奖励函数——机器人自己试错,奖励引导策略收敛。适合"目标好定义、过程难描述"的任务:行走(奖励=前进距离减能耗减摔倒)、抓取(奖励=物体到位)。痛点是奖励设计:奖励函数里没写的目标会被策略"聪明地"牺牲——只奖励速度的策略会把腿甩得即将散架。这被称为奖励黑客(reward hacking),是 RL 工程的第一大坑。
模仿学习(IL):直接从人类示范学"状态到动作"的映射。适合"过程好示范、目标难写成奖励"的任务:叠衣服、擦桌子、接电话。痛点是分布偏移:策略只见过示范里的状态,一旦执行偏差进入陌生状态就无措——对策是数据聚合(DAgger 类思路,让专家在策略自己跑出的轨迹上补标注)或加大示范多样性。
# 强化学习闭环的最小骨架(概念代码) for episode in range(EPISODES): state = env.reset() # 仿真环境重置 done = False while not done: action = policy(state) # 策略网络给动作 next_state, r, done = env.step(action) buffer.add(state, action, r, next_state) # 存经验 state = next_state # 经验回放中采样更新策略:让高回报动作出现概率上升 for _ in range(UPDATES): batch = buffer.sample(BATCH) update_policy(batch) # 梯度上升近似策略梯度
图:从仿真试错到实机服役的迁移链路
学习方法替代不了的部分
对照前五章,有边界的学习结论值得刻在工程直觉里:
替代了什么:难以建模的接触动力学(腿足行走的复杂落地、灵巧手的抓取);难以手写的响应式策略(乱石滩上每一步落点);高维感知到动作的直接映射。这些场合传统方法要么建不出模,要么调不出参。
替代不了什么:可证明的安全性(学习策略没有稳定性证明,安全等级应用仍需传统监控层兜底——第 5.4 节的安全体系原样适用);可解释的失效分析(策略挂了,你很难说清为什么);小数据场景(示范几百条的模仿学习泛化有限,而传统控制零样本就能跑)。工业现实的选择因此很清晰:学习层负责"难"的部分,传统层负责"稳"的部分——底层仍是模型控制与安全停障,学习策略跑在中间层,出问题降级回传统栈。
⚠️ 常见坑:奖励函数里忘写能耗与平滑项。学出来的策略"能完成任务"但剧烈抖动,硬件寿命骤减——奖励是 RL 的全部价值观,漏写的都会被牺牲。
本节要点
- RL 吃"目标好写、过程难教"的任务,IL 吃"过程好示范、奖励难写"的任务,数据来源决定分工。
- sim-to-real 差距三大根源是物理失真、感知失真与辨识不足,域随机化是第一对策。
- 学习策略无可证明的安全性与可解释性,必须架在传统安全层之上、以传统栈为降级出口。
- 奖励函数是 RL 的全部价值观,能耗、平滑、安全项漏写即被牺牲。
模仿学习的数据账本
模仿学习的成败取决于数据,账本要算三笔。量:单任务的示范量级,简单抓取数百条可用,叠衣服这类长时序任务上万条起步;质:示范的一致性比数量更致命——十个演示者十种习惯的混合数据,策略学到的是"平均动作"(往往不成立于任何真实场景),规范做法是同一任务由少数受训演示者完成并统一操作规程;价:遥操作采集的人工成本是每条数据以分钟计的真人时间,这正是数据采集机器人(自动跟随演示者动作的从臂)成为产业热点的原因。账算完你会发现:模仿学习适合"高频复用的窄任务",广谱能力仍靠基础模型路线,两条线的经济账完全不同。
从离线到在线:策略的保鲜问题
学习策略部署后不是一劳永逸:夹具磨损、物料批次变化、季节光照漂移,都在缓慢劣化策略的输入分布。保鲜机制三件套:性能监控——任务成功率的在线统计与阈值告警(第 5 章的语义级监控在学习场景的对应物);数据飞轮——把部署环境的真实运行数据(尤其失败案例)持续回流标注,定期增量训练;灰度回滚——新策略先在单机上灰度验证,出问题一键回滚旧版。没有保鲜机制的策略部署等于"一次性的拟合",两个月后的表现会默默偏离验收水平,而团队毫不知觉。
问题:怎么判断我的任务该用学习还是传统方法
给一个四问判断器。第一问:任务的核心难点是"难建模的物理"(接触、柔性、形变)还是"难编写的语义"(物体多样性、场景理解)?两者是,学习有机会;核心难点是精度与确定性,传统方法优先。第二问:失败代价多大?失败代价高(伤人、损货)的学习应用必须有传统安全层兜底,预算算清楚。第三问:数据采集成本可承受吗?按上面的账本估。第四问:任务会长期稳定存在吗?学习投入是重资产,临时性任务不值得。四问下来,多数项目的答案是清晰的混合:传统栈做底,学习层啃硬骨头。
补学习型机器人的评估纪律:模仿学习与强化学习在机器人上的最大陷阱是评估过拟合——在训练环境(初始状态分布、物体外观、桌面材质)里测得的成事率,换一个场景就腰斩。规范的做法是三个分布的分层评估:训练分布内( sanity check)、近邻分布(换初始状态采样种子)、外推分布(换光照、换物体、换桌面),报告三档成事率而不是单一数字。第二个纪律是数据接口的版本管理:演示数据的采集协议(相机标定、时序对齐、动作空间)一变,旧数据全部贬值,数据集要带协议版本号。第三个纪律是安全兜底:学习策略外面包一层传统安全监控(工作空间、速度、力矩限制),策略再差也出不了 cage——上线评审时这三条纪律齐不齐,是判断团队成熟度最快的试纸。