1.2 偏差、方差与过拟合:必考的白板推导题
1.2 偏差、方差与过拟合:必考的白板推导题
本节摘要:泛化误差可以分解为偏差的平方加方差加不可约噪声。偏差来自模型假设太粗,方差来自对训练样本扰动太敏感,过拟合是低偏差高方差的典型症状。这一节给你完整的推导路径、追问防御与降低两者的手段清单。
上一节定下了学习范式,这一节回答范式之下的第一性问题:模型的误差到底从哪来。这是全书被追问次数最多的一条数学链——你将在第 2 章看到,L1、L2 正则化是它的工程化落地;在第 2.2 节看到,Bagging 与 Boosting 的分野就是降方差与降偏差的分野。先把推导吃透,后面处处是它的回声。
主问题还原
面试官在白板上写下:请推导一下,为什么泛化误差可以分解成偏差、方差和噪声三项?
这不是背诵题,面试官想看你能不能在白板上从期望出发一步步展开。推导卡壳的候选人,后续追问会直接转向工程题,等于主动放弃了展示数学功底的机会。
标准答案
设样本特征为 x,真实关系为 y = f(x) + ε,其中 ε 是零均值、方差为 σ² 的噪声;模型在训练集 D 上学得预测 ĝ(x)。以 D 为随机变量取期望,测试点上的期望平方误差展开如下(推导可用文字口述,符号关系建议边写边讲):
Err(x) = E_D[(y - ĝ(x))²] = E_D[(y - f(x))²] ← 噪声项,不可约 + (f(x) - E_D[ĝ(x)])² ← 偏差平方:模型平均预测偏离真相 + E_D[(E_D[ĝ(x)] - ĝ(x))²] ← 方差:预测随训练集波动的幅度 合并即:Err = Bias² + Variance + IrreducibleNoise
口述推导的关键动作有三步。第一,在差里同时加减一个 E_D[ĝ(x)],这是全场的枢纽;第二,交叉项 E_D[(f(x) - E_D[ĝ])(E_D[ĝ] - ĝ)] 里前者与 D 无关、后者期望为零,整项消掉;第三,强调 σ² 与模型无关——再好的模型也吃不掉数据里的固有噪声,这句结论要说出来,面试官在等它。
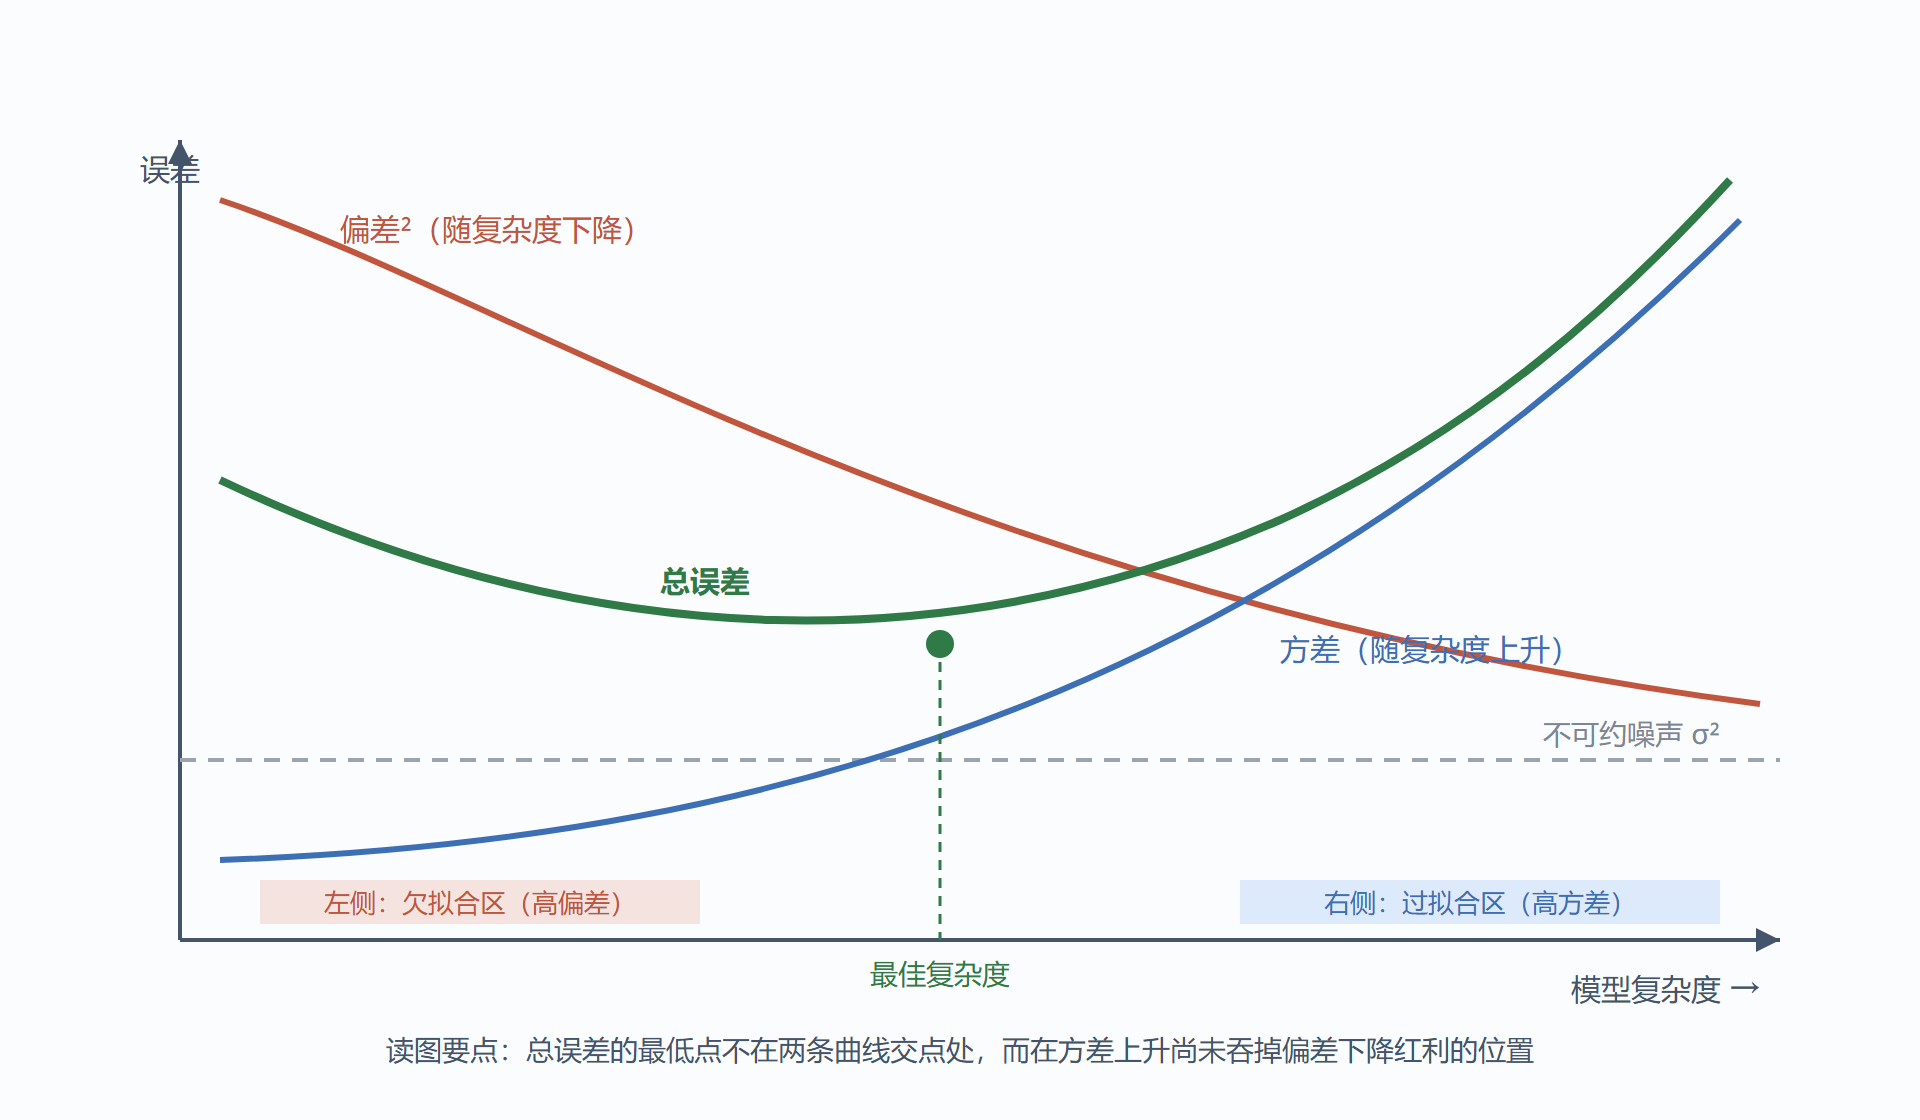
图:偏差-方差权衡与总误差的 U 形曲线
追问一层:正则化为什么能抑制过拟合
追问:「那 L2 正则化是怎么在这个框架里起作用的?」
面试官在验证你能否把统计概念接到优化目标上。参考答法:过拟合的直接表现是方差大,而方差大的模型往往系数幅值大、曲面扭曲剧烈——训练集里一点扰动就能让预测摆动很大。L2 在损失里加入系数平方和的惩罚项,等价于给系数施加一个往回拉的力:优化不再单纯追训练误差,而是在训练误差与系数规模之间做交易。牺牲一点点偏差(训练误差略微升高),换来系数变小、预测面对样本扰动更钝感,也就是方差下降。若总误差曲线原本在过拟合区,这笔交易是赚的。至于 L1 为什么会产出稀疏解、和 L2 的几何差别在哪,第 2.1 节会用正则化路径图专门展开——这里先给出「正则化=用偏差换方差」这个框架性答案即可。
追问二层:Bagging 降方差、Boosting 降偏差,为什么
追问:「都说集成学习有效,Bagging 和 Boosting 分别在降什么?」
这题在考你对偏差方差框架的理解是否到了能解释算法设计的程度。
- Bagging(如随机森林)降方差:对训练集做自助重采样训练多棵强而各异的树,平均之后,各棵树各自的方向性波动互相抵消——平均不改变期望(偏差基本不动),但方差按相关性越低抵消越狠。随机森林再对特征做随机子集采样,就是刻意让树之间更不相关,把方差压得更低。
- Boosting(如 GBDT)降偏差:串行训练,每一步新模型去拟合当前全体模型的残差,逐步把累计的系统性错误补上。补的是「一直算错的部分」,即偏差;但串行依赖也让模型对训练数据越来越贴合,方差随之走高,所以 Boosting 对过拟合更敏感,需要学习率与早停来控场。
一句收束:Bagging 是「一群差不多强的人投票,错得不一样所以稳」,Boosting 是「一个不断改错的学生,越改越准但容易钻牛角尖」。这两种直觉的完整对比在第 2.2 节还会以对比矩阵的形式再现。
易错点
- 把噪声项说成可以靠收集更多数据消除。噪声是 label 本身的随机性,加数据只能压方差,压不掉它——这是推导题最经典的扣分点。
- 「高方差就是过拟合」说反条件。过拟合通常表现为低偏差高方差,但高方差不必然伴随低偏差;严谨说法是过拟合状态下模型把训练集噪声也拟合了。
- 只画 U 形曲线讲不出横轴。横轴是模型复杂度(树深、多项式阶数、系数规模),讲不出横轴的曲线等于没讲。
- 声称「训练误差低所以泛化好」。方向反了:过拟合的定义特征恰恰是训练误差与泛化误差的裂口。
评分要点
这一题的分档通常这样划:能背出三项分解的结论,及格;能在白板上完成「加减期望预测」并说明交叉项消去的原因,良好;在推导之外能主动连接正则化与集成学习,用同一框架解释不同算法的设计动机,优秀。表达上有一个细节值得注意——先写结论三项,再回头推导,比从期望定义闷头推到底观感好得多:面试官随时可以打断,结论先行保证他任何时候叫停你都已经有分。
下一节把「模型好不好」从误差语言换成指标语言:混淆矩阵、ROC、PR 曲线怎么读、怎么选、什么时候会骗人。
高频追问速答
问:训练误差和泛化误差的差值,能用偏差方差语言描述吗?
可以,这个裂口主要由方差贡献:模型对训练样本的特异性记得越牢,换一批样本时预测摆动越大,训练与测试的表现差距随之拉大。偏差部分在训练与测试上表现相近——模型系统性算错的部分在哪批数据上都错。这句解释能把「过拟合是方差病」说得比「过拟合就是学多了」专业得多。
问:增加数据量对三项各有什么影响?
方差随样本量增大而收敛下降——样本越多,模型见过的「世界」越完整,对抽样的敏感度越低;偏差不受数据量影响,它来自模型形式的错误,只能靠换更强的模型或特征工程缓解;噪声项纹丝不动。所以「多收集数据」这条万能建议只解决方差侧的问题,说不出这个边界就是没理解分解式。
问:交叉验证和这一节什么关系?
交叉验证是用重复抽样估计「泛化误差」的手段,而偏差方差分解解释了这个误差的构成——前者是量尺,后者是理论。面试里主动把两章连起来讲,展示的是知识网络的完整性。
表达纪律:推导题收尾时永远补一句「每一项对应什么工程手段」——偏差大换模型、方差大加数据或正则、噪声大重新审视问题定义。
一个可背的微型案例
用多项式拟合直觉收尾:一阶多项式拟合弯曲数据是高偏差(欠拟合),十五阶多项式是高方差(过拟合),三到五阶常是甜点。面试白板上画三个拟合示意图只需半分钟,却能把抽象框架钉进面试官的视野——画图的人永远比背图的人 memorable。
**追加一问:k 折交叉验证能同时估计偏差和方差吗?**不能直接拆分——它估计的是总误差;但对不同模型族对比其交叉验证分数的均值与波动,可以近似观察「谁偏差大、谁方差大」。分解式是理论透镜,交叉验证是测量仪器,两者角色不同、互相不可替代——把这个关系说清,是把两个考点串成一张网的机会。