1.3 评估指标追问链:从混淆矩阵到 ROC 与 PR
1.3 评估指标追问链:从混淆矩阵到 ROC 与 PR
本节摘要:一切分类指标都从混淆矩阵的四个格子里长出来。精确率管「报出来的准不准」,召回率管「该报的漏没漏」,ROC 看全阈值下的排序质量,PR 曲线在不平衡场景下更诚实。本节给你指标族谱、ROC 与 PR 的选择标准,以及「AUC 很高但业务没用」这道经典追问的拆法。
第 1.2 节把误差拆成了偏差与方差,但那是站在损失函数视角。面试的下一站是把同一件事翻译成业务能听懂的语言:模型报出的正例有多少是真的,真的正例你抓住了多少。指标追问链的特征是环环相扣——从准确率问起,五步之内必然问到不平衡场景,然后考察你是否知道此时哪些指标已经失真。
从混淆矩阵开始的家谱课
主问题:「给我讲讲分类评估指标,从哪讲起?」
推荐从混淆矩阵开讲而不是从准确率开讲:四个格子(TP、FP、FN、TN)是所有指标的公共祖先,从这里出发,任何指标都能现场推出来,不用背。
标准答案
以二分类为例:精确率 P 等于 TP 除以 TP 加 FP,衡量每次报警的可信度;召回率 R 等于 TP 除以 TP 加 FN,衡量对真实正例的覆盖度;两者是彼此的拉锯——阈值调高报警更准但漏得更多,调低则相反。F1 是二者的调和平均,任何一边趋零都会把 F1 拖向零。准确率 Accuracy 是全体判对比例,只在类别分布均衡时有参考意义。
随后主动抛出适用边界:当正负样本悬殊时,准确率会被多数类绑架——百分之九十九的负样本里,全预测负的傻瓜模型准确率也有百分之九十九。这句话是你主动把话题引向 ROC 与 PR 的钩子,比等面试官追问更显主动。
追问一层:ROC 与 PR 曲线到底怎么选
追问:「ROC 曲线和 PR 曲线分别什么时候看?」
面试官在考你对曲线背后统计量的理解,而不是让你背两条曲线的形状。
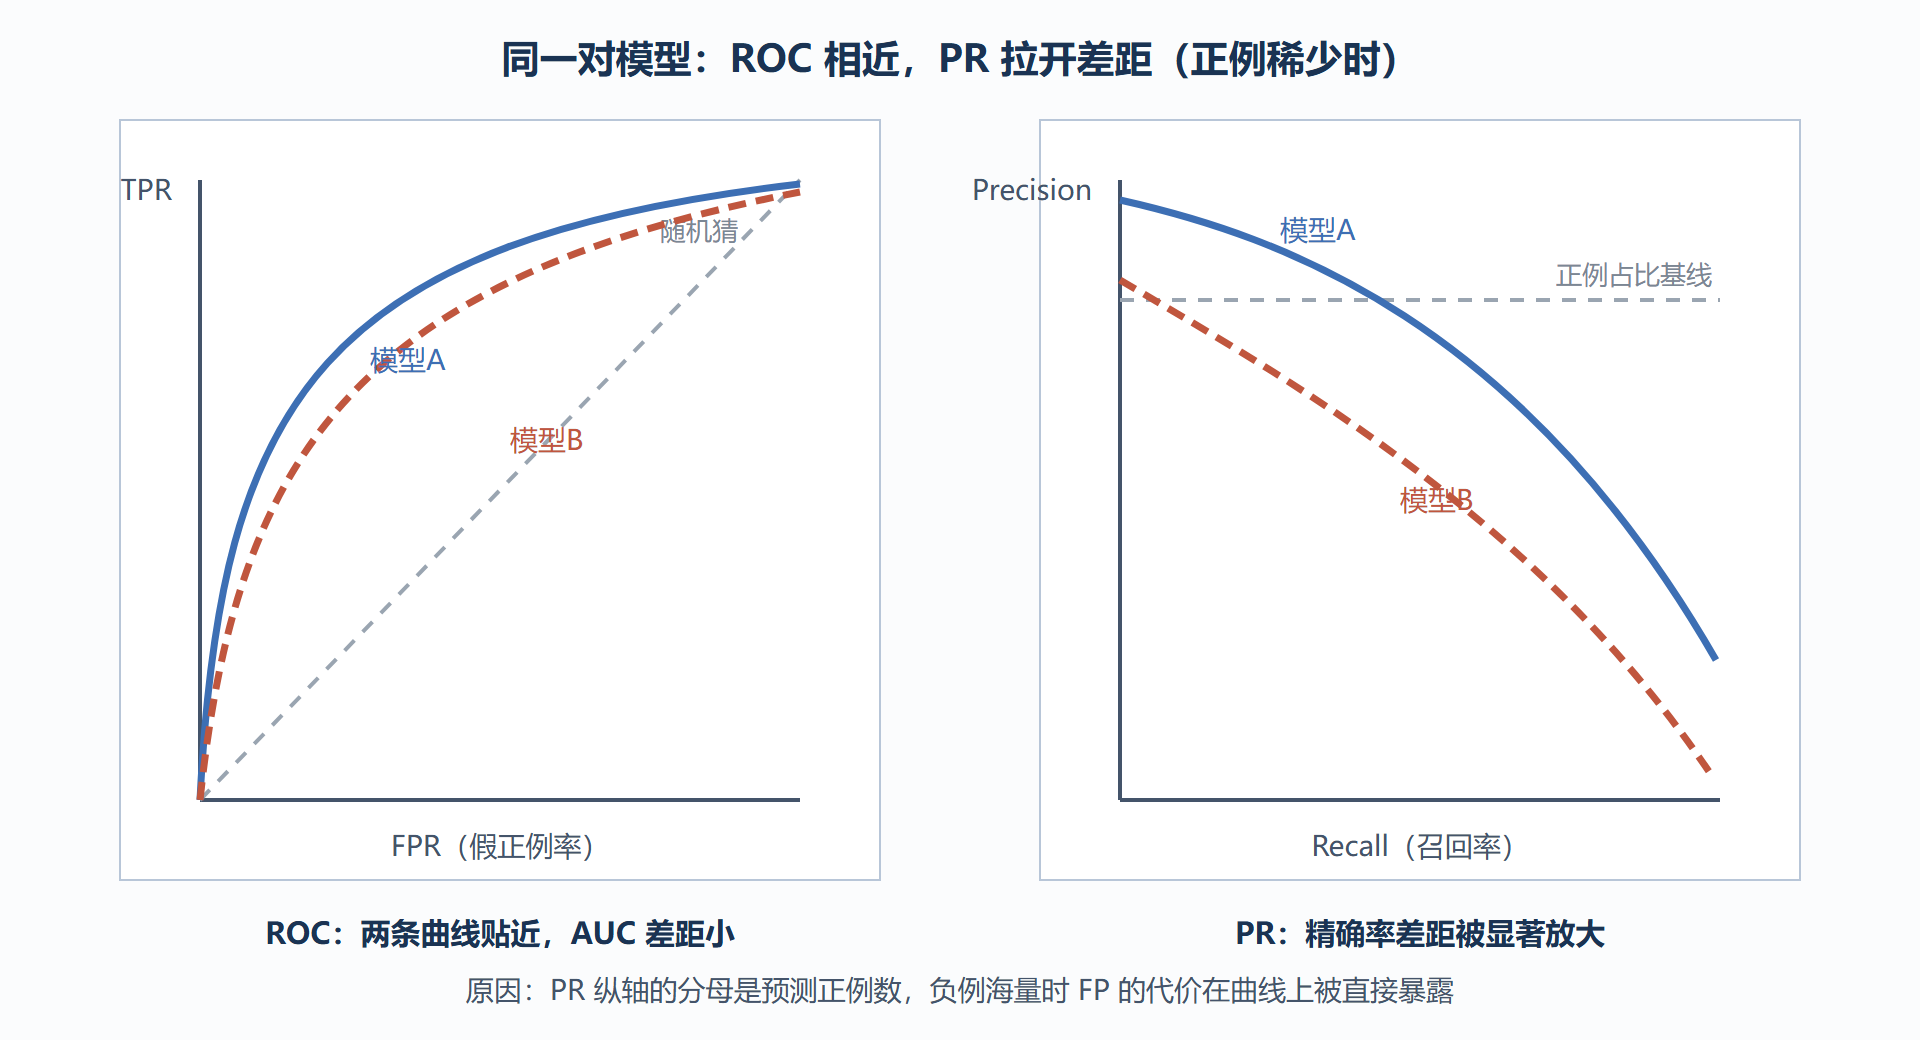
- ROC 曲线:横轴 FPR(负例中被误报的比例),纵轴 TPR(正例中被抓住的比例)。它的两个坐标轴分母分别是负样本总数与正样本总数,因此对类别比例的变化相对钝感——正负比例翻转,曲线形状基本不动。适合描述模型整体的排序能力,也适合类别分布相对均衡的场景。
- PR 曲线:横轴召回率,纵轴精确率,纵轴的分母是「预测为正」的数量,与正例的绝对数量强相关。负例暴涨时,FP 水涨船高,精确率被系统性压低,曲线形状明显变化。所以在欺诈检测、广告点击、罕见病筛查这类正例稀少的任务里,PR 曲线对模型差异更敏感,也更贴近「报警值不值钱」的业务视角。
图:ROC 与 PR 曲线对照(同一模型在均衡与不平衡场景下)
追问的追问:「AUC 等于零点五说明什么?」——说明模型的正例打分与随机猜测无异;若离线 AUC 长期在零点五附近徘徊,先怀疑特征无区分力,再怀疑标签与特征之间发生了泄漏错位。
追问二层:AUC 很高,业务方说没用,怎么回事
追问:「离线 AUC 零点九五,上线后运营说报警太多没人看,问题出在哪?」
这是指标题的压轴追问,考你是否理解「排序质量」与「工作点选择」的分离。
参考答法分三层。第一层,AUC 衡量的是全阈值下的排序能力,它不承诺任何一个具体阈值上的表现;AUC 高只说明把正例排在前面是大概率,不说明报警量可控。第二层,业务方抱怨的「报警太多」是精确率问题——在正例稀少时,即便排序完美,要抓住大部分正例也不可避免地带出海量误报,这正是上一问 PR 曲线尾部的形状。第三层,解决办法不是换模型而是选工作点:按业务能承受的日报警量反推阈值,用 top-K 精确率或指定召回下的精确率作为汇报指标;若业务要求「报出来的至少八成是真」,这已经是对精确率的硬约束,训练目标与阈值策略都要围绕它调整。能把「指标失灵」归因到「指标选错」而非「模型不行」,这题才算答完。
from sklearn.metrics import (roc_auc_score, average_precision_score, precision_score, recall_score, f1_score) proba = model.predict_proba(X_val)[:, 1] # 正例概率 print("ROC-AUC :", roc_auc_score(y_val, proba)) # 排序质量,对不平衡钝感 print("PR-AUC :", average_precision_score(y_val, proba)) # 不平衡时更敏感 pred = (proba >= 0.3).astype(int) # 阈值是业务决策,不是默认 0.5 print("P/R/F1 :", precision_score(y_val, pred), recall_score(y_val, pred), f1_score(y_val, pred))
代码里藏着这节的全部要点:同一份概率输出,指标结论随你问的问题而变;阈值永远该由业务代价决定,默认值只是懒惰。
易错点
- 把 ROC 说成「对不平衡免疫」——它只是不敏感,PR 在极端不平衡下仍是更诚实的放大镜,绝对化表述会被抓着追问。
- F1 说成算术平均。调和平均的特征是「惩罚短板」,一边为零整体归零,这正是业务想要的对齐方式。
- 多分类场景硬套二分类公式而不说明平均策略:macro 对每类一视同仁,micro 被大类主导,weighted 按支持度加权——报哪个数必须先说清楚。
- 把 AUC 解释成「正确分类的比例」。正确解释是:随机取一正一负两个样本,正例得分高于负例的概率。
评分要点
及格线是四个格子与 P、R、F1 的公式;良好线是主动对比 ROC 与 PR 的分母结构并给出场景化选择;优秀线是在「离线好在线差」的追问里,把问题拆解到排序质量与工作点选择两个层面,并给出以业务约束反推阈值的方案。这节的指标语言会贯穿全书:第 1.4 节的不平衡处理本质上是给这些指标补妆,第 6 章的交叉验证则负责让这些数字本身变得可信。
高频追问速答
问:多分类的 ROC-AUC 怎么算?
常见两种口径:一对一(每类对其余算一个二分类 AUC 再平均)与一对一配对(各类两两配对算 AUC 再平均)。macro 平均让小类话语权与大类相同,适合关注少数类的场景;不说明平均策略就报数,是这个考点的常见扣分点。
问:Brier 分数和 AUC 有什么不同?
AUC 只关心排序,Brier 关心概率与真实结果的数值距离——一个校准极差但排序尚可的模型可以有体面的 AUC 和糟糕的 Brier。凡是要把输出概率直接当风险定价用(定价、限额、期望损失)的场景,必须同时报校准类指标。
问:线上指标和离线指标为什么经常对不上?
离线用的是历史快照、闭环了的选择偏差(旧模型挑过的样本)与固定阈值,线上是开放分布、实时反馈与新阈值环境。除了排查泄漏,标准动作是把离线评估改造得更像线上:时间切片验证、反事实评估、影子流量测试。
表达纪律:报任何指标先报口径——哪个数据集、哪种平均、哪个阈值。无口径的数字在资深面试官耳中等于噪声。
混淆矩阵的现场演算示范
给一个能背的算例:一千个样本、一百个正例,模型报出八十个正例,其中六十个是对的。精确率等于六十除以八十是零点七五,召回率等于六十除以一百是零点六。面试官说「讲讲精确率召回率」时,主动给出这组自设数字并现场算出两个指标,证明你对公式的掌握到了应用层,而不是默写层。