2.1 线性回归与逻辑回归:损失函数之问
2.1 线性回归与逻辑回归:损失函数之问
本节摘要:线性回归与逻辑回归共享同一个线性主体,分歧全在损失函数:前者用均方误差拟合连续值,后者用交叉熵拟合对数几率。本节按「最小二乘怎么解、为什么逻辑回归不能用均方误差、L1 与 L2 各自怎么压系数」的追问链推进,L1 的稀疏性给出几何与梯度两条独立解释。
这一节是第 1 章抽象框架的第一次落地:偏差方差权衡在这里变成看得见的系数收缩,正则化路径图会亲眼展示「偏差换方差」这笔交易怎么发生。它同时是第 2.2 节的对照组——理解了线性模型的凸损失为什么好优化,才能理解树模型为什么干脆放弃梯度走分裂的路。
主问题:从最小二乘说起
主问题:「线性回归的损失函数为什么是均方误差,有没有更讲道理的解释?」
直接答「惯例如此」就浪费了这题。有两条独立且都漂亮的论证路径,面试里至少要走出一条。
标准答案
路径一是概率视角:假设噪声服从零均值同方差的高斯分布,则似然函数取对数后恰好等价于最小化残差平方和——最小二乘是高斯噪声假设下的极大似然估计。路径二是几何视角:均方误差对应在特征空间里找 y 的正交投影,正规方程 X 转置 X 逆 X 转置 y 就是投影矩阵的解析表达。两条路径都指向同一个目标,这才是均方误差「讲道理」的地方:它不是拍脑袋选的,而是高斯世界里的最优选择。
正规方程值得多记一句:X 转置 X 可逆性依赖特征间线性无关,共线性严重时矩阵病态,这正是岭回归(L2)登场的历史动机——给对角线加上常数项让矩阵变得可逆,原始叫法里的「岭」就是这么来的。
追问一层:逻辑回归为什么不用均方误差
追问:「逻辑回归也是回归,为什么损失换成交叉熵,用均方误差会怎样?」
这是线性模型追问链里出现频率最高的一题,推荐按「三个死因」作答:
- 死因一,非凸:把 sigmoid 套进均方误差后,损失关于参数不再凸,梯度下降可能停在糟糕的局部极小;交叉熵加对数几率是天然凸的,全局最优有保证。
- 死因二,梯度消失:sigmoid 的导数在预测远离目标时趋近于零。均方误差的梯度里含这个导数因子,错得越离谱学得越慢;交叉熵的梯度恰好是「预测值减真实值」,错得越大纠正越猛。
- 死因三,统计错位:逻辑回归的观测是伯努利变量,它的自然损失就是对数似然的负数(交叉熵)。用高斯的均方误差去拟合零壹数据,等于声明了错误的噪声模型,估计失去渐近有效性。
交叉熵还有一层好讲的解读:它等价于极大化训练集上的似然,等价于最小化预测分布与经验分布的 KL 散度——三个「等价」能让面试官确认你不是背的。
import numpy as np def bce_grad(X, y, w): """交叉熵损失的梯度:恰好是 (sigmoid(Xw) - y),不含 sigmoid 导数因子。""" p = 1.0 / (1.0 + np.exp(-X @ w)) return X.T @ (p - y) / len(y) def mse_grad(X, y, w): """均方误差损失的梯度:多乘一个 p*(1-p),错得越远梯度越小。""" p = 1.0 / (1.0 + np.exp(-X @ w)) return X.T @ 2 * (p - y) * (p * (1 - p)) / len(y)
两行梯度代码是这个考点最干净的演示:差异全在尾部那个因子上。
追问二层:L1 与 L2 的稀疏性从哪来
追问:「都说 L1 产生稀疏解,为什么恰好是 L1?L2 为什么不行?」
面试官期待两条独立解释,能都讲清是明确的加分信号。
解释一,几何等高线。损失函数的等高线与正则项的约束区域相切处即最优解。L2 的约束区域是光滑圆盘,切点几乎总在圆弧上,两个方向都留一点系数;L1 的约束区域是带尖角的菱形,等高线大概率撞在角上——角点意味着某些坐标严格为零,稀疏由此产生。维度越高、角越多,撞角的概率越大。
解释二,梯度视角。L1 对每个系数的惩罚梯度是恒定的符号量(绝对值的导数),无论系数多小都施加同样力度的回拉,小系数会被直接推过零点;L2 的惩罚梯度正比于系数本身,系数越小拉力越小,永远「拉到接近零但到不了零」。
图:正则化路径——系数随惩罚强度增大被逐步压缩
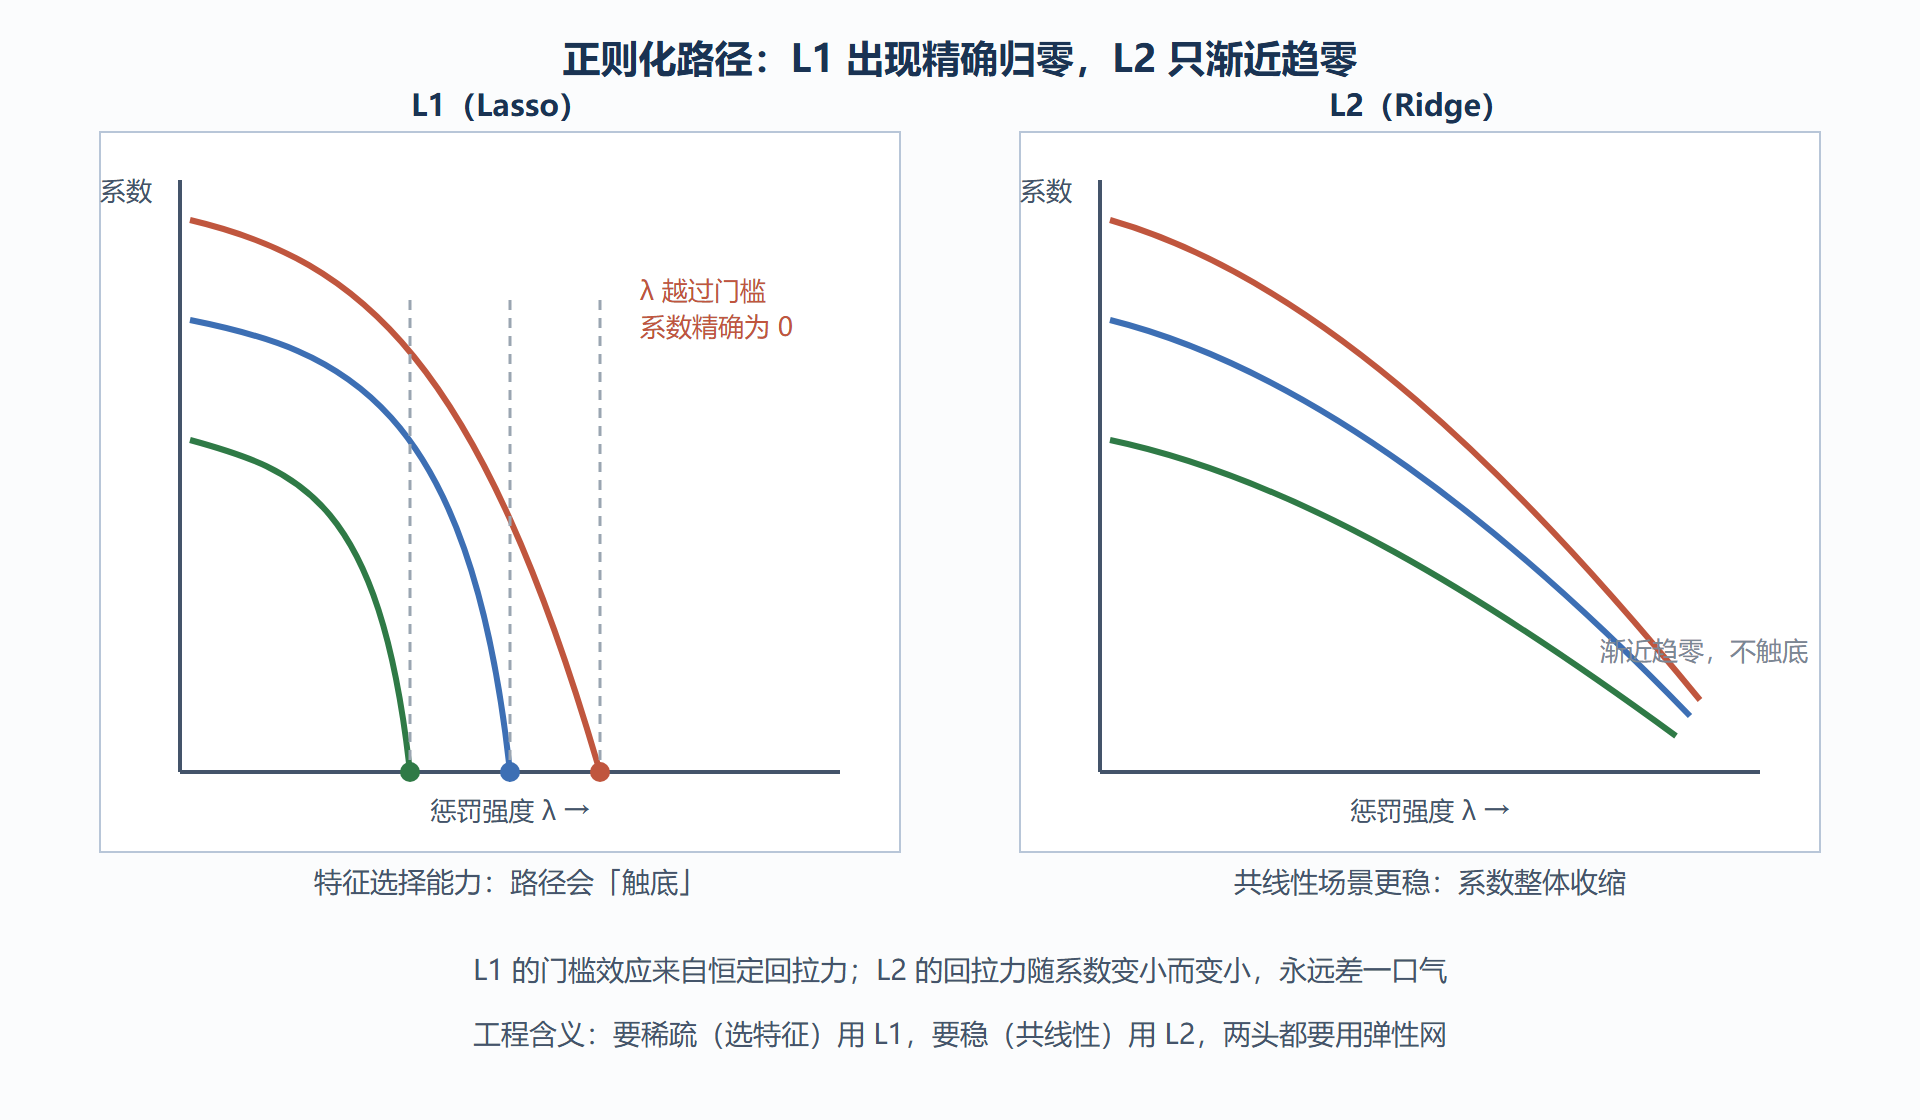
两种解释之外的第三句话:稀疏性是内嵌的特征选择——L1 把没用的特征的系数直接归零,模型自带可解释性,这是它在文本高维稀疏场景长盛的原因。两者都不理想时的合体方案是弹性网,惩罚项写成 L1 与 L2 的加权和,保留分组选择能力。
易错点
- 说「L1 是 L2 的特例」或「L1 处处可导」。绝对值在零点不可导,L1 的优化靠次梯度或近端方法,这句写错会被数学敏感的面试官当场抓住。
- 把逻辑回归说成「回归模型」。它是对数几率的线性模型、分类器;名字里的回归是历史残留,值得主动点破以防误解。
- 声称「正则化一定降低测试误差」。λ 过大时偏差吃掉方差红利,欠拟合登场——回到第 1.2 节的 U 形曲线。
- 忽略「正则化前必须先标准化特征」。惩罚对系数尺度敏感,量纲未对齐时惩罚就是在偏袒某些特征。
评分要点
及格:说清两种损失各自的形式与逻辑回归的 sigmoid 映射;良好:给出交叉熵对均方误差的三重优势,或 L1 稀疏性的任一条完整解释;优秀:双解释齐备,并能连到弹性网、概率校准与「先标准化再正则」这类工程细节。这一节的投资回报极高——它几乎原样出现在从初级到资深的每一轮笔试面试里。
下一节把镜头转向另一棵常青树:决策树,以及它背后那条从单树到 XGBoost 的集成演进链。
高频追问速答
问:多重共线性对线性模型有什么影响,怎么处理?
共线让系数估计的方差爆炸——系数在相关特征之间任意分摊,符号都可能翻转,解释性崩坏但预测可能还行。处理按目的分流:只为预测,岭回归收缩即可;要解释与选择,Lasso 或弹性网;要根因,剔除或合并冗余特征。能区分「预测崩」与「解释崩」是这题的高分点。
问:逻辑回归的系数能当特征重要性读吗?
要小心三件事:先标准化否则量纲不可比;相关特征会分摊系数;系数符号在共线下不可信。更诚实的做法是用置换重要性或 SHAP 复核,系数只作初筛参考。
问:为什么工业界那么爱逻辑回归?
三笔账:训练与推理便宜、延迟极低;系数即解释,合规与排障友好;特征工程的所有红利都能直接兑现。在风控、广告的粗排层,逻辑回归长期是性价比之王——「简单模型加好特征」常常打赢「复杂模型加裸特征」。
表达纪律:线性模型题的每句结论都尽量带上「为什么」——它是最适合展示「统计直觉加工程判断」双重功底的题型。
边角案例两则
问:逻辑回归的特征要不要做分箱?
分箱把非线性关系交给离散化处理,配合评分卡建模还能稳定合规审计;代价是信息损失与边界敏感。风控评分卡传统是分箱加权重证据转换,互联网粗排常直接用连续特征加人工交叉——两派都成立,说出取舍比站队重要。
问:最小二乘的解析解什么时候不能用了?
特征维度超过样本量时矩阵不可逆,或样本量太大求逆太贵。前者的解法是正则化或降维,后者的解法是梯度下降或随机投影。解析解与数值解的边界是线性模型题的隐藏考点。