2.2 决策树与集成学习:从分裂准则到 XGBoost
2.2 决策树与集成学习:从分裂准则到 XGBoost
本节摘要:决策树用递归分裂把特征空间切成矩形块,单树易过拟合,集成来救场:Bagging 并行降方差,Boosting 串行降偏差。GBDT 把残差拟合成一条流水线,XGBoost 在它之上补了二阶信息、正则化与工程优化。本节按这条演进链组织全部高频追问。
上一节的线性模型在特征交叉与非线性的边界上力不从心,树模型是另一种极端:不做任何全局假设,让数据自己说话。这条「单树、森林、提升」的演进链是表格数据面试的主航道,其中 XGBoost 与 GBDT 的差异几乎是指定考题——本节把它拆成可背的五点。
主问题:一棵树是怎么长出来的
主问题:「决策树选择分裂特征的准则有哪些,它们有什么区别?」
标准答案
三大准则对应两种任务与一个哲学分歧。ID3 用信息增益,偏爱取值多的特征,取值唯一的特征增益直接拉满,是个著名漏洞;C4.5 用信息增益率,给取值数打了惩罚补丁;CART 用基尼系数(分类)或平方误差(回归),计算不需要对数、支持回归,是现代实现的默认选择。三者本质上都在度量「分裂前后不确定性的下降」,区别在熵的非线性惩罚与可分性度量的细节。
讲完准则要主动补上停机与剪枝:max_depth、min_samples_leaf 是预剪枝的旋钮;后剪枝(如代价复杂度剪枝)先长满再回剪,效果通常更好但更费算力。单树的问题是高方差——数据抖一抖,树形大变,这句话是把话题交给集成的完美引桥。
追问一层:Bagging 与 Boosting 的机制差异
追问:「随机森林和 GBDT 都是树的集成,它们有效的原因一样吗?」
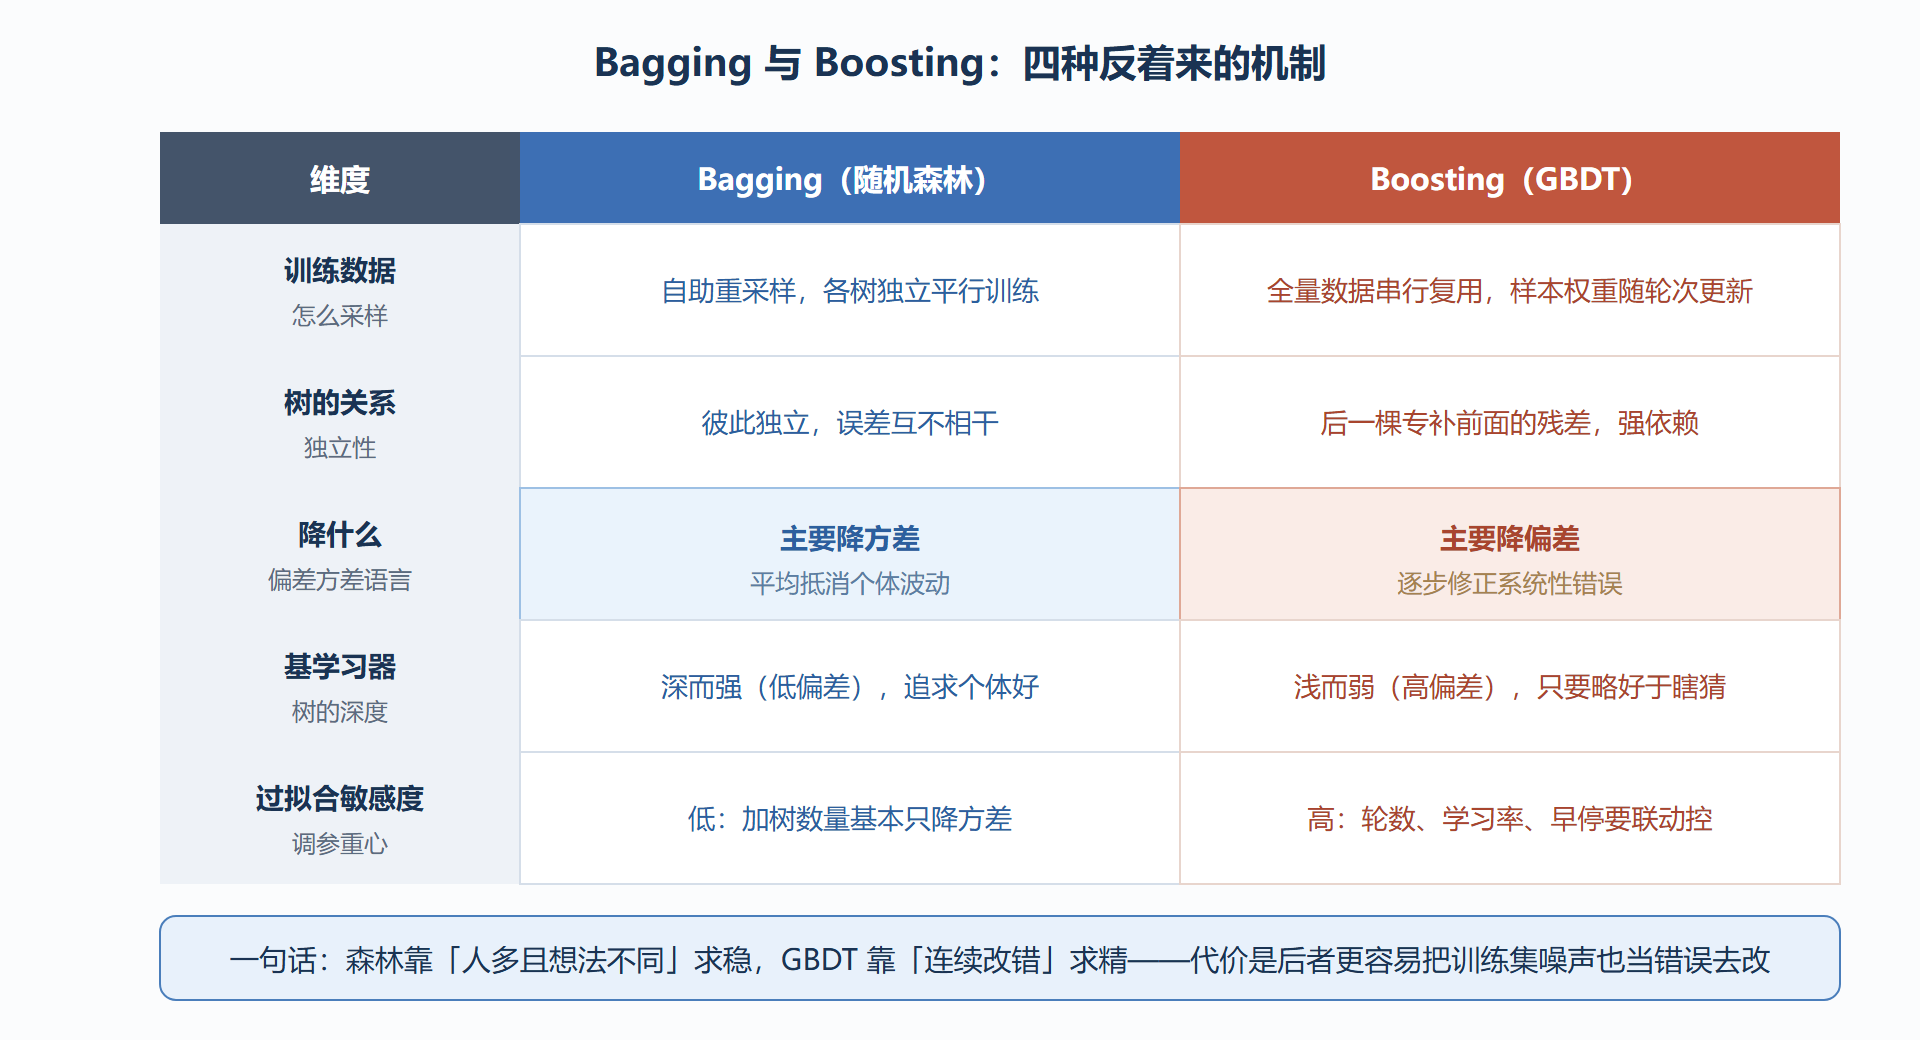
不一样,而且「不一样」正是这道题的得分点。两者在数据、训练顺序、模型角色、鲁棒性四个维度上全是反着来的:
图:Bagging 与 Boosting 对比矩阵
顺带回收第 1.4 节的线头:类别不平衡在随机森林与 GBDT 里都能以样本权重进入分裂增益的计算,不需要造数据。这句能让面试官看到你的知识是连成网的。
追问二层:XGBoost 与 GBDT 到底差在哪
追问:「XGBoost 是 GBDT 的实现还是改进?说得出差异吗?」
标准说法是「框架级改进」,差异可背成五点,建议按「数学、正则、处理、工程、通用性」的顺序输出:
- 二阶泰勒展开:GBDT 只用一阶梯度近似损失下降;XGBoost 对目标函数做二阶展开,用梯度 g 与海森 h 共同刻画每轮的目标,分裂增益与叶子权重都有解析式,收敛更快更稳。
- 显式正则项:目标函数直接带上叶子数与叶子权重的平方惩罚,「树长什么样」由带正则的目标决定,而不像 GBDT 依赖启发式剪枝。
- 更完整的数值处理:原生支持缺失值(样本按增益选择去左还是去右的默认方向)、带权样本、列采样(继承随机森林的招)。
- 工程优化:预排序加分位草图逼近找分裂点、缓存感知访问、并行化的特征级并行,这是「快」的来源。
- 通用性:自定义损失只要给出一阶二阶导即可接入,二阶框架让回归、分类、排序共用一套机制。
LightGBM 若被追问,再补两点:直方图分裂替代预排序,单边梯度采样丢弃小梯度样本——都是拿微小精度换数量级速度的工程交易。
from sklearn.datasets import make_classification from xgboost import XGBClassifier from sklearn.model_selection import train_test_split from sklearn.metrics import roc_auc_score X, y = make_classification(n_samples=20000, weights=[0.95, 0.05], n_features=20, random_state=0) Xtr, Xva, ytr, yva = train_test_split(X, y, test_size=0.25, stratify=y, random_state=0) clf = XGBClassifier(n_estimators=400, learning_rate=0.05, max_depth=5, scale_pos_weight=19, # 代价敏感:负正比倒数 eval_metric="aucpr", # 不平衡场景看 PR 而非 AUC early_stopping_rounds=30, random_state=0) clf.fit(Xtr, ytr, eval_set=[(Xva, yva)], verbose=False) print("PR-AUC:", round(roc_auc_score(yva, clf.predict_proba(Xva)[:, 1]), 4))
这段样板代码把本章三个考点焊在一起:scale_pos_weight 是 1.4 节的代价敏感、eval_metric 选 PR 系指标是 1.3 节的口径换血、early_stopping 是 Boosting 方差控制的落地。
易错点
- 说「随机森林的树越深越好、GBDT 的树越浅越好」却给不出理由。正确叙述是各自匹配降方差与降偏差的角色,而不是死记深浅。
- 把「XGBoost 并行」说成「树之间并行」。并行发生在单棵树内部的分裂候选计算上,Boosting 的串行本质没变。
- 声称 GBDT 拟合「梯度」。准确说法是拟合损失关于当前预测的负梯度在平方损失下恰好是残差,一般损失下是伪残差。
- 忘了 CART 是二叉树,而 ID3、C4.5 允许多叉;被问「C4.5 为什么工程上少见了」要能答出熵计算开销、多叉偏向与只能分类这三条。
评分要点
及格:讲清一种分裂准则与随机森林的基本机制;良好:Bagging 与 Boosting 能用偏差方差语言对齐差异,XGBoost 五点差异至少完整说出三点;优秀:能在白板上写出二阶展开下的分裂增益式,并把缺失值默认方向、直方图加速这类工程细节讲成「精度换速度的交易」。从这一节往后的面试,考官往往不再问概念而直接问取舍——请保持「每句话都带代价」的表达习惯。
下一节进入间隔视角的 SVM:一个把「最大化间隔」刻进目标函数的另类经典。
高频追问速答
问:树的分裂对特征量纲敏感吗?为什么?
不敏感。分裂只比较特征内部的排序,任何单调变换不改变候选分裂点的好坏排序——这与距离类模型形成鲜明对照,也是树模型省去缩放步骤的数学原因。但样本权重与类别权重会改变增益计算,那是另一回事。
问:为什么随机森林对异常值和噪声更鲁棒?
两重平均在起作用:行采样让异常点只进入部分树,列采样进一步稀释其影响;最终预测是全体树的投票或平均,单棵树被异常点带偏的幅度被稀释在集成里。集成不是消除错误,是让错误互相抵消。
问:GBDT 能做分类吗,损失怎么进残差?
能。分类时损失换成交叉熵,每轮拟合的是负梯度(对数几率的伪残差),输出经 sigmoid 映射为概率。「GBDT 拟合残差」的说法只在平方损失下字面成立,一般情形是拟合负梯度——这个修正能救很多追问。
表达纪律:集成题的每个论断都往「降偏差还是降方差」上挂,让面试官看到一棵理论树而不是一堆算法名。