2.3 SVM:最大间隔与核技巧
2.3 SVM:最大间隔与核技巧
本节摘要:支持向量机的全部追问都围绕两条主线:几何上,最大化分类间隔让决策边界对扰动最不敏感;计算上,对偶问题引入核函数,把「线性不可分」变成「高维空间里线性可分」。软间隔的 C 与松弛变量负责在完美间隔与容忍误分之间交易。
线性模型与树模型之后,SVM 提供了第三种世界观:不预测概率、不做递归分裂,而是直接寻找「离两边都尽量远」的那条边界。它在面试里的地位来自推导的层次感——几何、优化、核技巧三层逐级深入,非常适合做追问链的压力测试。这一节同样大量回收第 1 章的语言:最大化间隔本质上是在控制模型的复杂度。
从一张图开始:间隔在哪里
主问题:「解释一下支持向量机和它的最大间隔思想。」
标准答案
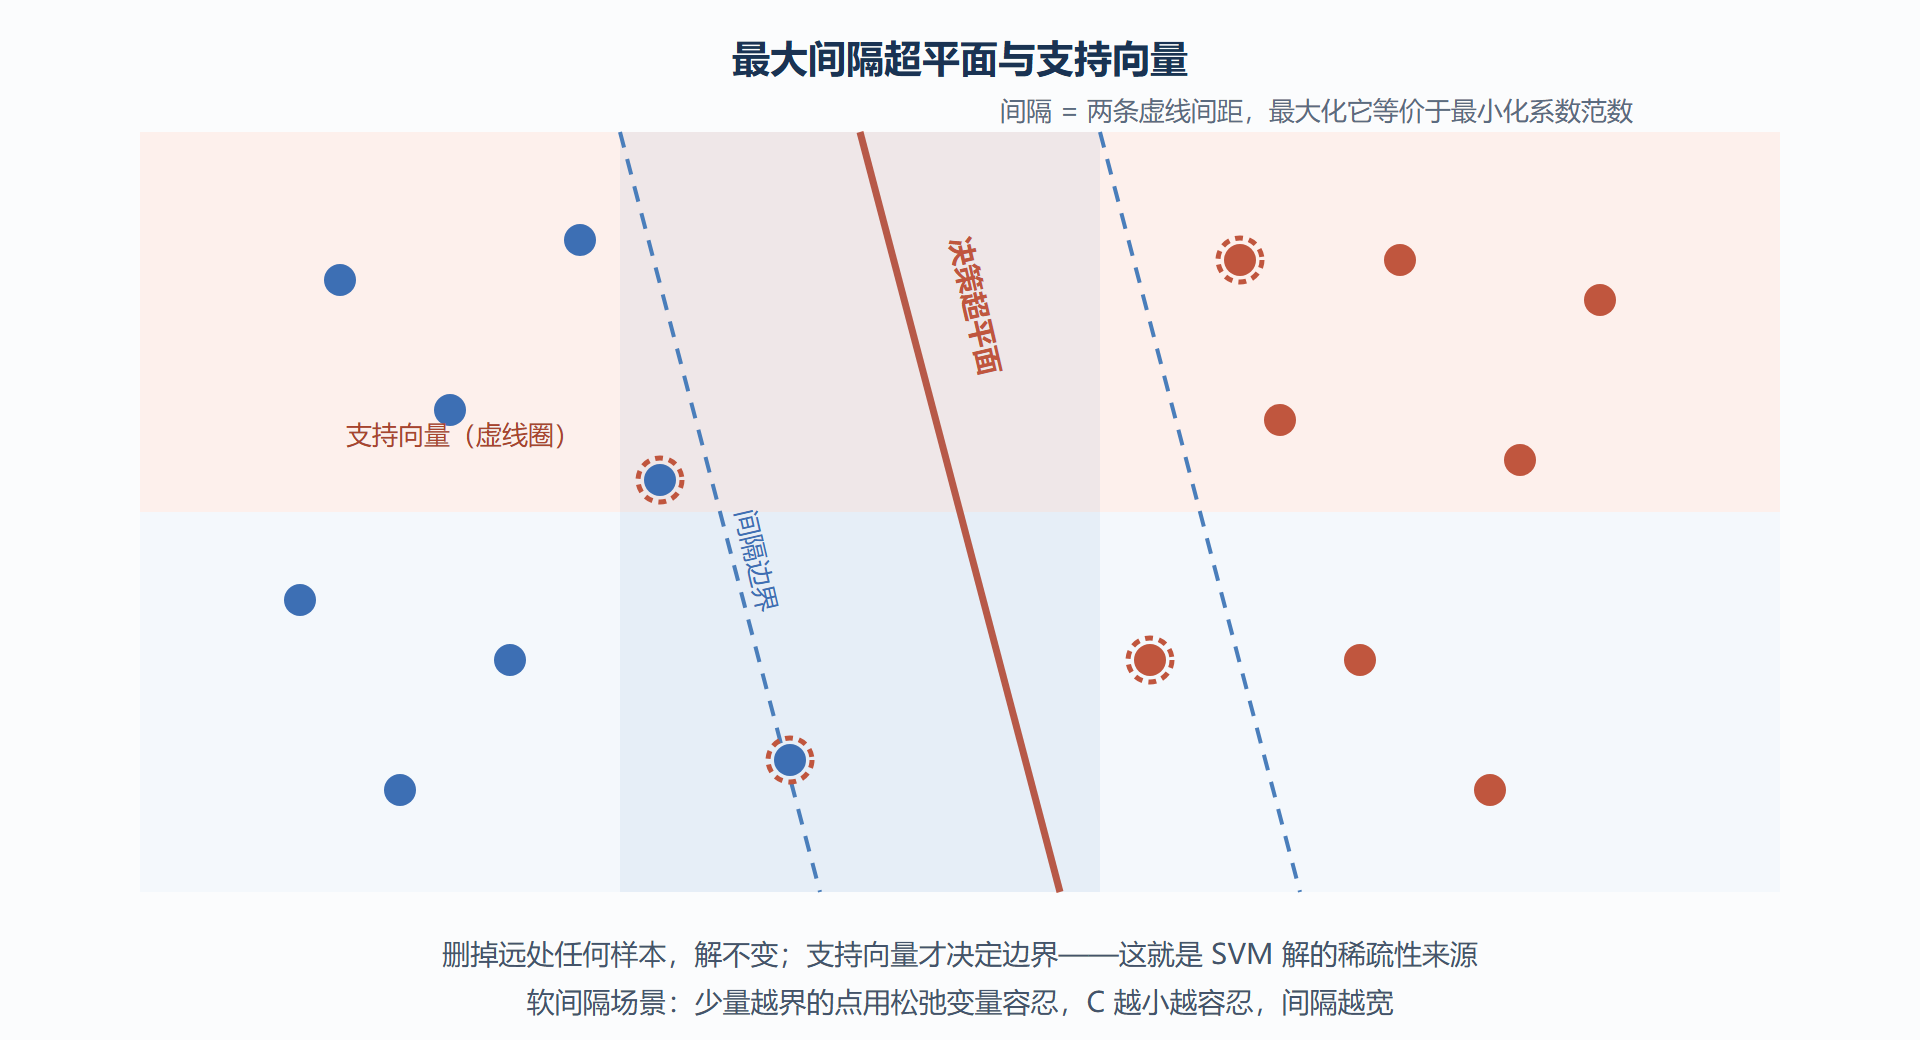
SVM 在特征空间里寻找一个超平面,把两类样本分开,并让两类中离超平面最近的样本到平面的距离(即间隔)最大。那些恰好落在间隔边界上、决定超平面位置的样本就叫支持向量——删掉其余任何样本,解都不变;动一个支持向量,边界就移动。最大化间隔等价于最小化系数的平方范数,在约束「样本被正确分开」之下成为一个凸二次规划问题。
要主动补的一句是「为什么最大间隔好」:间隔越大,边界对样本扰动的容忍度越高,泛化误差的上界与间隔成反比——这是 SVM 与第 1 章偏差方差框架最深的连接,它不靠平均也不靠迭代,直接把「稳」写进了目标函数。
图:最大间隔与支持向量——只有边界上的点说话算数
追问一层:为什么要求对偶
追问:「原始问题已经是凸二次规划,为什么要转到对偶问题?」
这题筛掉过大量背书选手,推荐按「一个数学动机、一个算法动机、一个理论动机」作答:
- 数学动机:对偶把约束从「对每个样本的不等式」简化为「系数非负加一个等式约束」,问题结构更干净;
- 算法动机:对偶形式里样本只以两两点积出现,训练只需内积矩阵(Gram 矩阵),SMO 这类分解算法在此结构上高效工作;
- 理论动机(最重要):正因为只依赖内积,才能把内积替换成核函数,间接在无穷维空间里做线性分类——没有对偶就没有核技巧。
顺带说出 KKT 条件的角色:支持向量的稀疏性由互补松弛条件刻画——非支持向量的拉格朗日乘子严格为零。能点到互补松弛,说明你不是在背「对偶好」。
追问二层:核函数怎么选,什么核都行吗
追问:「随便找一个函数当核可以吗?高斯核和多项式核怎么选?」
先答合法性再答选择,顺序不能乱。
- 合法性:核函数必须对应某个高维空间的内积。实用判据是 Mercer 定理:核矩阵在任意有限样本集上半正定,则该核合法。面试给出「核矩阵半正定」这个可操作检验就足够专业。
- 高斯核(RBF):隐含无穷维空间,能画出任意弯曲的边界,是默认首选;代价是带宽 γ 敏感——γ 大到离谱时训练集完美分类、边界碎成孤岛,典型过拟合,需要与 C 联网格搜索。
- 多项式核:显式的有限维特征交叉,阶数 d 控制交互深度;文本等稀疏高维场景常有稳定表现,但 d 大时数值上溢。
- 工程判断:特征维度极高(如文本词袋)时常接近线性可分,线性核或线性 SVM 又快又稳;样本上万、维度中等、需要非线性边界,RBF 加网格搜索是经典组合;样本量十万级以上,SVM 的核矩阵内存与训练成本会劝退,树集成或线性模型通常接棒——这句「什么时候不用 SVM」是高级感的来源。
硬间隔原始问题: min (1/2)||w||² s.t. y_i(w·x_i + b) ≥ 1 软间隔原始问题: min (1/2)||w||² + C·Σξ_i s.t. y_i(w·x_i + b) ≥ 1 - ξ_i, ξ_i ≥ 0 对偶问题: max Σα_i - (1/2)ΣΣ α_i α_j y_i y_j K(x_i, x_j) s.t. Σ α_i y_i = 0, 0 ≤ α_i ≤ C 预测: f(x) = Σ α_i y_i K(x_i, x) + b (只有 α_i > 0 的支持向量参与求和)
这组式子建议能默写框架而非每个下标:原始、软间隔、对偶、预测四层各说得出「谁约束谁」即可支撑绝大多数追问。
易错点
- 把支持向量说成「离得最远的样本」。恰好相反,是间隔边界上的最近样本。
- 说「核技巧是把特征映射到高维后重新训练」。核技巧的高明处恰恰在于从不显式构造高维向量,只算内积,维度爆炸被完全绕开。
- 混淆 C 与 γ 的职责。C 管误分容忍度(训练错误 vs 间隔宽度),γ 管单个样本的影响半径;过拟合时两者都可能要降,但作用机制不同,混为一谈会暴露没调过参。
- 声称「SVM 输出的是概率」。原生输出是决策函数的带符号距离,概率需要额外做 Platt 缩放校准,这句话能接住「SVM 和逻辑回归怎么选」的后续追问。
评分要点
及格:说出最大间隔与支持向量的含义;良好:完整回答「为什么求对偶」三个动机,或给出核函数的合法性判据与常用核取舍;优秀:能写出软间隔目标函数并解释 C 的交易逻辑,把「样本规模大到什么程度该放弃 SVM」这类工程边界讲清楚。SVM 题的深度上限很高,答到哪一层,基本划定了整场面试技术轮的天花板预期。
下一节换个口味,讲两个「简单得可疑」的算法:KNN 与朴素贝叶斯。它们常被轻视,但追问起来恰恰最容易暴露基本功的成色。
高频追问速答
问:SVM 和逻辑回归怎么选?
看需求清单:要概率输出与校准,逻辑回归原生占优;要边界鲁棒与中小样本非线性边界,SVM 占优;样本量到十万级,SVM 的核矩阵成本失控,逻辑回归或树集成接管。两者的损失函数(hinge 对交叉熵)只惩罚「错得多的样本」与「全体样本」的方式不同,这也解释了 SVM 解的稀疏性。
问:松弛变量和 C 的关系一句话说清?
松弛变量度量每个样本的违约量,C 是违约的总预算单价:C 大,模型拼命迁就每个样本、间隔窄、方差大;C 小,模型容忍误分、间隔宽、偏差大。它是又一个「偏差换方差」的旋钮。
问:高斯核为什么原则上能拟合任何训练集?
带宽足够小时,每个样本都成为自己的支持向量,模型退化为记忆训练集——训练误差可以到零,泛化崩溃。这个极端恰好说明「能拟合」与「能泛化」是两回事,也是 C 与 gamma 必须联调的原因。
表达纪律:SVM 题层层有公式,但每一层都先给几何直觉再落符号,纯符号输出会让非数学背景的面试官失去耐心。
边角案例两则
问:SVM 对特征缩放敏感吗?
敏感——内积与距离直接被量纲支配,不缩放的 SVM 基本不可用,这与 KNN 同病。树模型免缩放而核方法必缩放,这条分界线在选型题里反复出现。
问:支持向量的数量多意味着什么?
意味着数据重叠严重、问题接近线性不可分,模型在「记住边界附近的样本」而不是「抓住结构」;也预示推理成本上升(预测要对全部支持向量算核)。支持向量占比是模型健康度的免费体检指标。