3.2 PCA 与降维:方差最大化怎么推
3.2 PCA 与降维:方差最大化怎么推
本节摘要:主成分分析寻找数据方差最大的正交投影方向:第一主成分是协方差矩阵最大特征值对应的特征向量,后续成分依次取次大者且彼此正交。本节给出完整推导路径、维数选择标准、与 LDA 及 t-SNE 的选型对照,以及「PCA 该放在切分前还是切分后」这个泄漏陷阱。
上一节的聚类把数据切成块,这一节把数据压扁——两者共享同一个母题:在没有标签的世界里,「方差大」是唯一可以仰仗的信号。PCA 的推导是白板题里的常客,且它的每一步都能对应一个几何动作,特别适合展示「数学动作与几何直觉互相翻译」的能力。它同样直接服务第 5 章的特征工程:降维、标准化、特征选择是同一张工具墙上的邻居。
主问题与完整推导
主问题:「推导一下 PCA,为什么第一主成分是协方差矩阵的最大特征向量?」
标准答案
推导分四步走,每步都有明确的几何台词:
第一步(目标):找单位方向 w,使投影后的方差最大。 投影方差 Var(w·x) = w·Σ·w ,其中 Σ 是数据协方差矩阵。 第二步(约束):||w|| = 1(不然方差无界),拉格朗日函数: L(w) = w·Σ·w - λ(w·w - 1) 第三步(求驻点):对 w 求导置零,得 Σ·w = λ·w 。 —— 方向 w 必须是 Σ 的特征向量,投影方差恰为特征值 λ。 第四步(择优):方差最大 ⇒ 取最大特征值对应的特征向量。 后续成分:在正交补空间里重复同一论证,天然得到正交性。
四步的几何台词依次是:压扁方向上数据摊得越开信息越少丢失;方向必须归一否则无穷大;「协方差作用在该方向上只做伸缩」就是特征向量的定义;正交性不用另外强求,是谱定理白送的。另一条等价路径是最小化重建误差——「投影后保留的方差最多」与「丢掉的部分最少」是同一枚硬币的两面,被追问时把这句放出来稳赚。
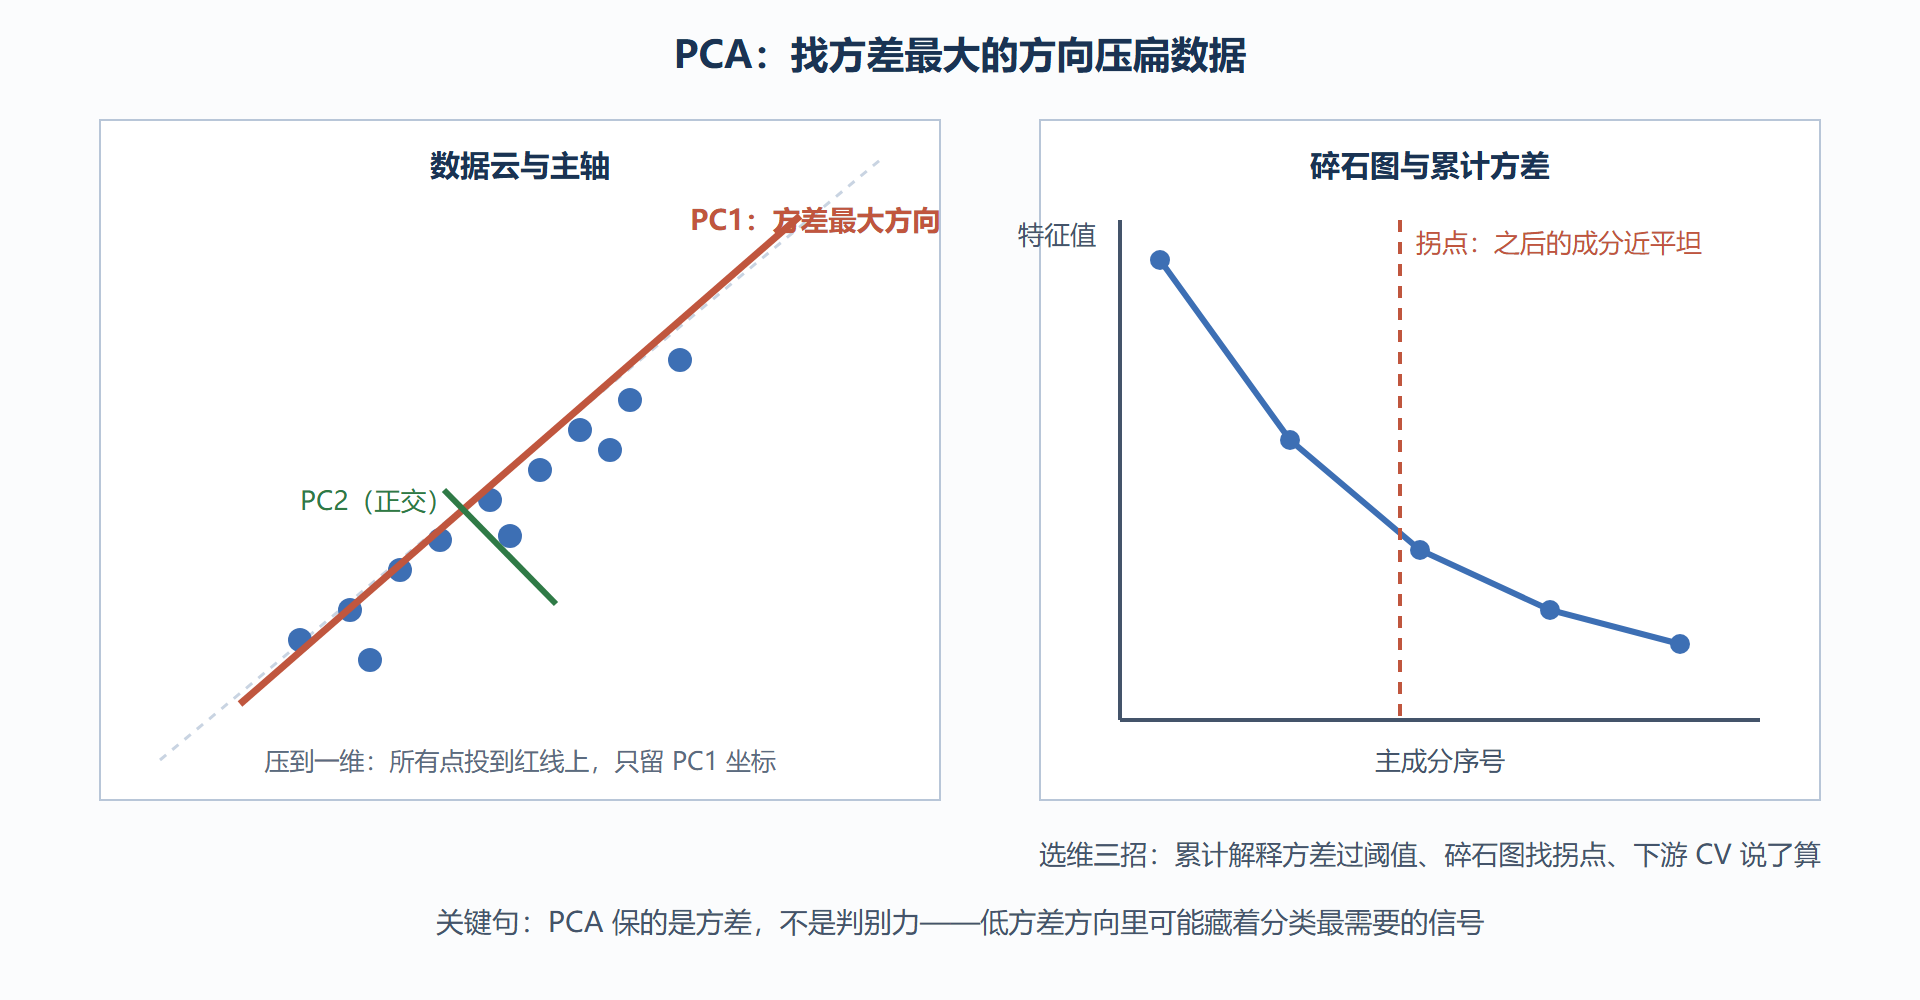
主成分的含义:第一主成分是数据云最长的延伸方向,得分 = 样本在该方向上的坐标;载荷 = 各原始特征在该方向上的权重,用来解释「这个成分在度量什么」。解释成分时看载荷绝对值的头部特征,这是把数学结果翻译给业务的关键动作。
追问一层:维数怎么选,PCA 之后发生了什么
追问:「保留几个主成分?降到低维以后训练的模型变好了吗?」
两个小问分开答:
- 维数选择:按解释方差比,保留累计贡献达到阈值(常用九成上下)的最少成分;或画碎石图找陡坡拐点;若 PCA 是监督流程的预处理,最硬的标准是下游验证分数——成分数放进交叉验证的网格里选(这又把话题递给第 6 章)。
- 效果预期:PCA 不是万能提效药。它去共线性、压噪声、省维度,但它无监督——丢掉的方向是「方差小」的方向,而不是「对标签没用」的方向。若判别信息恰好藏在低方差方向里(分类问题里并不罕见),PCA 反而帮倒忙。这句「PCA 保方差不保判别」是本节含金量最高的单句。
图:PCA 投影几何与解释方差比
追问二层:PCA、LDA、t-SNE 怎么选
追问:「同样是降维,线性判别分析和 t-SNE 什么时候替代 PCA?」
选型回答的骨架是「有监督与否」加「线性与否」:
- LDA(有监督、线性):找「类间散度对类内散度之比」最大的方向,最多产出「类别数减一」维。有标签且目的是分类时,LDA 常比 PCA 更贴任务;但它不能用于无标签的探索性降维。
- t-SNE(非线性、无监督):保持高维邻域结构,把局部相似性翻译成低维距离,适合可视化探索(看簇、看批次效应)。两条硬限制必须主动说:它压缩后的坐标不能作为下游模型的特征用(没有显式映射函数,新样本无法变换);簇间距离与簇大小不具备全局度量意义,看图时别过度解读。
- PCA 的生态位:快、确定性强、有显式变换可复用于新样本、能压共线性,是一切流程的默认起点;探索可视化和非线性结构才轮到别人。
易错点
- 推导时忘写「先中心化」。PCA 的协方差定义在去均值数据上,白板第一步就该把均值减掉,漏了这步整段推导的地基就歪了。
- 说「主成分是原始特征的子集」。主成分是全部原始特征的线性组合,选主成分不是删特征;真要删特征,那是第 5.3 节特征选择的活。
- 把 PCA 当泄漏源而不自知:在全量数据上先拟合 PCA 再切分交叉验证,均值与主轴里已混入验证折信息。纪律与 KNN 的标准化一样——一切统计量只在训练折内估计。
- 声称「PCA 一定能提升下游效果」并拿不出对照实验的口径。
评分要点
及格:说清「方差最大、正交、协方差特征向量」三个关键词;良好:白板完成四步推导,并能讲碎石图或累计方差比的选维逻辑;优秀:主动给出「保方差不保判别」的边界声明,PCA 与 LDA、t-SNE 的选型对答如流,且点出切分前拟合的泄漏陷阱。无监督两节至此收束,下一章进入深度学习——你会发现反向传播、优化器、归一化这些新名词,用的还是这一章和第 1 章反复出现的同一批母语:梯度、方差、正则。
高频追问速答
问:PCA 对特征量纲敏感吗?
极其敏感——协方差被大量纲特征主导,主成分会全部对齐它们。标准动作是先标准化再做 PCA;如果各特征的量纲本身有业务意义(都是同单位的物理量),也可以用相关系数矩阵代替协方差矩阵,等价于标准化后做 PCA。
问:PCA 和奇异值分解什么关系?
PCA 的全部计算可以由 SVD 承载:数据矩阵的中心化版本做 SVD,右奇异向量就是主成分方向,奇异值平方除以样本数减一就是特征值。数值实现上 SVD 更稳定,也避免显式构造高维协方差矩阵——这句是工程加分项。
问:什么情况下不该用 PCA?
特征本身稀疏且要保可解释(主成分是全特征的线性组合,一混就不认识);下游是树模型(树对单调变换与共线不敏感,PCA 的收益有限);判别信息在低方差方向(先验证再降维)。
白板自测:默写四步推导并给每步配几何解释;碎石图三招(累计方差、拐点、下游验证)各说一句。
深水区:三个延伸追问
问:核 PCA 解决什么?
把 PCA 搬进核空间,能捕捉非线性结构(环形数据在核空间变成可线性展开的带状物);代价是核矩阵的规模随样本平方涨、新样本映射需要保留训练样本。一句话对照:线性结构用 PCA,流形结构用核 PCA 或 t-SNE。
问:稀疏数据(文本词袋)上 PCA 合适吗?
稠密化的协方差计算昂贵且结果难解释,截断 SVD(跳过中心化,直接对稀疏矩阵做奇异值分解)是文本上的标准替代——它就是隐语义分析的骨架。
问:PCA 的成分数与下游模型有关系吗?
有:线性模型受益于去共线,树模型几乎不受益;深度管线里 PCA 还能当预训练式的压缩层。成分数最终由下游验证分数定,解释方差比只是先验参考——这是「验证口径优先」纪律的又一次现身。
追加一问:PCA 与特征选择的防泄漏纪律一样吗?
一样且更隐蔽——PCA 的主轴是全量数据算出来的统计量,切分前拟合等于把验证折的方差结构泄进表示。正确姿势与缩放器相同:fit 只在训练折,transform 可以复用到验证与测试折。这条纪律在 5 章与 6 章反复出现,是全书泄漏防线的同一条主脉。