3.1 K-Means 追问链:K 值、初始化与失败场景
3.1 K-Means 追问链:K 值、初始化与失败场景
本节摘要:K-Means 交替执行「分配到最近质心」与「质心移到簇均值」直到收敛,本质是对含簇内平方和目标的最小化。它的追问链由四个软肋牵引:K 怎么选、初始化怎么稳、什么形状会失败、结果怎么评。本节把这四个软肋各配上标准答法与反例。
从本章起,追问的性质变了:监督学习问「错多少」,无监督问「你怎么知道没错」。K-Means 是这场评估危机的最小样本——三行迭代人人会写,但「K 从哪来」「坏初始化怎么办」两问就能筛掉大半候选人。本节先立主问题,再沿软肋逐层追问。
主问题与迭代推导
主问题:「讲一下 K-Means 的过程,它到底在优化什么?」
标准答案
算法两步交替:分配步把每个样本划给最近的质心,更新步把每个质心移到本簇样本的均值,直到分配不再变化。它隐式优化的目标是簇内平方和(各样本到所属质心距离之和),分配步与更新步每轮都让这个目标单调不增,因此必然收敛——但只保证收敛到局部最优。K-Means++ 通过「概率正比于距离平方」的选点策略让初始质心彼此散开,大幅降低坏局部最优的概率。
白板讲解时建议边画边讲:随手点几个点,画出一次分配与一次更新的动作,比背步骤更有说服力。收尾一定要主动说出「局部最优」四个字,它是整条追问链的入口。
追问一层:K 怎么选
追问:「K 怎么定?肘部法到底在找什么?」
参考答法分三个工具加一个兜底:
- 肘部法:扫描 K,画簇内平方和随 K 下降的曲线,找「边际收益骤减」的拐点。局限是很多真实数据的曲线平滑无肘,拐点判断主观。
- 轮廓系数:对每个样本计算内聚度(到本簇其余点的平均距离)与分离度(到最近他簇的平均距离),轮廓等于分离度减内聚度再除以较大者,取值负一到正一。选 K 使全样本平均轮廓最大。被要求现场推公式时,记住核心是「内聚小、分离大、用较大者归一」。
- Gap Statistic:把真实数据的簇内平方和与均匀参考分布的期望做差,差值最大处即最优 K,比肘部法更客观但计算更贵。
- 兜底:很多业务里 K 根本不是统计量而是资源约束——运营分几层、库存分几仓,先问业务再谈统计,这句放在最后往往最加分。
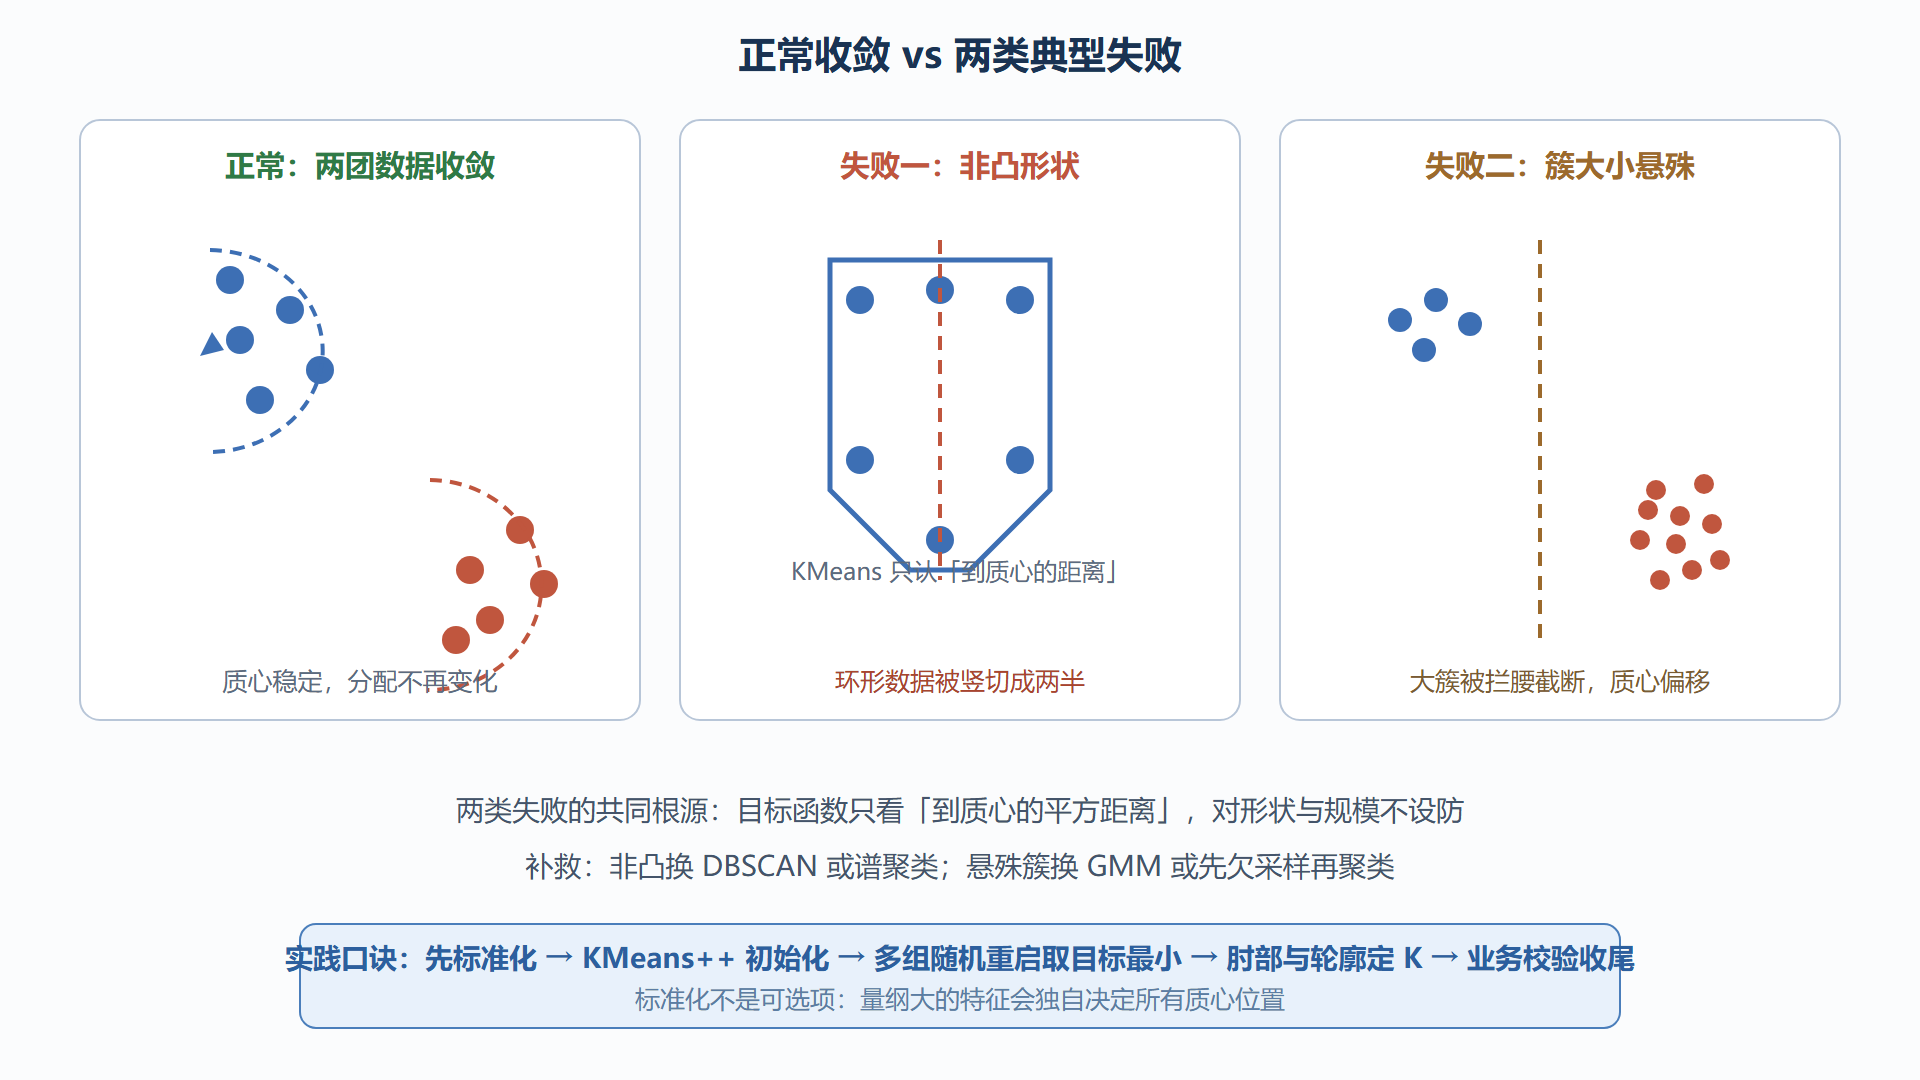
图:K-Means 迭代过程与两次失败场景
追问二层:失败场景与替代方案
追问:「K-Means 什么时候会给出明显不合理的结果?」
背出两个反例就是这题的答案本体:
- 非凸簇:环形、月牙形数据被质心距离硬切成扇形块。根源是「各向同性距离」假设;补救是 DBSCAN(密度可达,任意形状)或谱聚类(先做相似度图的谱嵌入再聚类)。
- 簇大小悬殊或密度不均:大簇被截、小簇被吞。补救是高斯混合模型(GMM)——软分配加每簇独立协方差,EM 框架下给出概率式聚类。
- 另外两个必提的实操坑:必须先标准化(否则量纲最大的特征主导全部距离);多组随机重启取簇内平方和最小的一组,配合 K-Means++ 把重启次数降下来。
易错点
- 断言「K-Means 一定收敛到全局最优」。单调有界只保局部最优,初始化决定落在哪个盆地。
- 肘部法说成「找曲线最低点」。曲线单调下降没有最低点,找的是边际收益骤减的拐点,表述错会被抓。
- 把轮廓系数说成「越接近零越好」。负一到正一,接近零说明样本躺在边界上、簇间粘连。
- 忘记 K-Means 只能处理数值特征——类别变量需要 K-Modes 这类变体,提一句显工程经验。
评分要点
及格:完整说出两步迭代并点出「优化簇内平方和、收敛到局部最优」;良好:三种选 K 工具的原理与局限各说得出,能现场推导轮廓系数;优秀:两类失败场景配对成因(目标函数的几何假设)与替代方案(DBSCAN、谱聚类、GMM),并主动给出标准化的实践纪律。无监督题的分水岭就在「能不能预判失败」——会跑算法的人很多,知道它会在哪翻车的人少。
下一节从离散分组转向连续压缩:PCA 的方差最大化是全章唯一需要完整推导的考点,值得提前活动一下手腕。
高频追问速答
问:K-Means 与高斯混合模型什么关系?
K-Means 是 GMM 的特例:各簇协方差相同且各向同性、混合比例固定、软分配退化为硬分配。GMM 的 EM 框架给出概率归属与椭圆簇形,代价是计算更贵、需要防奇異协方差。面试里能画出这条从 K-Means 到 GMM 的推广链,比多背三个聚类算法更值钱。
问:K-Means++ 为什么有效?
它的选点策略让新质心以正比于距离平方的概率出现在远离已选质心的位置——既保留了随机性(多次重启的意义),又系统性避免质心扎堆,从而大幅降低坏局部最优的概率,并给出接近对数级的近似保证。
问:聚出来的簇怎么向业务解释?
三步走:统计画像(各簇在各特征上的均值与分布对比)、命名(用业务语言给簇起名)、动作映射(每个簇对应什么运营或风控动作)。解释不了动作价值的簇,再高的轮廓系数也只是数字游戏。
白板自测:画出 K-Means 在环形数据上的失败示意,并写出你会改用的两个替代方案及理由。
深水区:评估指标的组合拳
| 指标 | 度量什么 | 局限 |
|---|---|---|
| 簇内平方和 | 紧凑度 | 随 K 单调降,不能单独选 K |
| 轮廓系数 | 紧凑与分离的平衡 | 大簇与小簇混在时偏乐观 |
| 戴维森堡丁指数 | 簇间散度比簇内散度 | 偏好凸簇 |
| 稳定性(重采样对比) | 划分对扰动的抵抗 | 计算贵,但最能反映真结构 |
四个指标各自只看一面,工程口径是「两两组合交叉验证」:轮廓系数选 K、稳定性确认、业务画像定名。稳定性检验的思路(换一批重采样数据,划分是否大致不变)尤其值得在面试里主动提出——它是无监督里最接近「统计显著」的 analog。
**追加一问: minibatch K-Means 牺牲了什么?**用小批量更新质心,速度快一个量级,收敛质量略降且对小数据不划算——大数据场景的标准提速手段,代价要说得出。
追加一问:聚类的结果怎么和下游系统衔接?
三种常见姿势:簇标签直接作类别特征进监督模型(注意与 5.2 节目标编码同样的泄漏纪律——聚类必须在训练折内拟合);簇画像直接驱动运营策略(分群营销、分层风控);簇中心作检索锚点(相似用户召回)。衔接方式决定评估口径——标签进模型看下游指标,策略驱动看业务实验,别拿轮廓系数给业务汇报。
追加二问:什么时候不该聚类?
数据没有天然分组结构(连续梯度型分布)时,强行聚类的「簇」只是切分痕迹;业务要的是排序而非分组时,先问目标再定方法。聚类是手段不是仪式——「不做聚类」有时是最专业的答案。