4.1 反向传播:白板推导的标准解法
4.1 反向传播:白板推导的标准解法
本节摘要:反向传播就是链式法则加动态规划:前向把每层的中间结果缓存,反向按「上游梯度乘本层局部导数」自后向前传播误差。本节给出两层网络的标准推导路径、面试中最常被追问的前向缓存问题,以及梯度消失在此的埋点位置。
深度学习面试的固定节目是「推一下反向传播」。它筛人的方式很直接:背过结论的人推到第二层就乱,理解结构的人闭着眼也知道下一项是什么。这一节的任务是把推导变成肌肉记忆——并且讲清它为什么高效,这是比「会推」更高一档的追问。
主问题:两层网络的完整推导
主问题:「请在白板上推一个两层网络的反向传播。」
标准答案
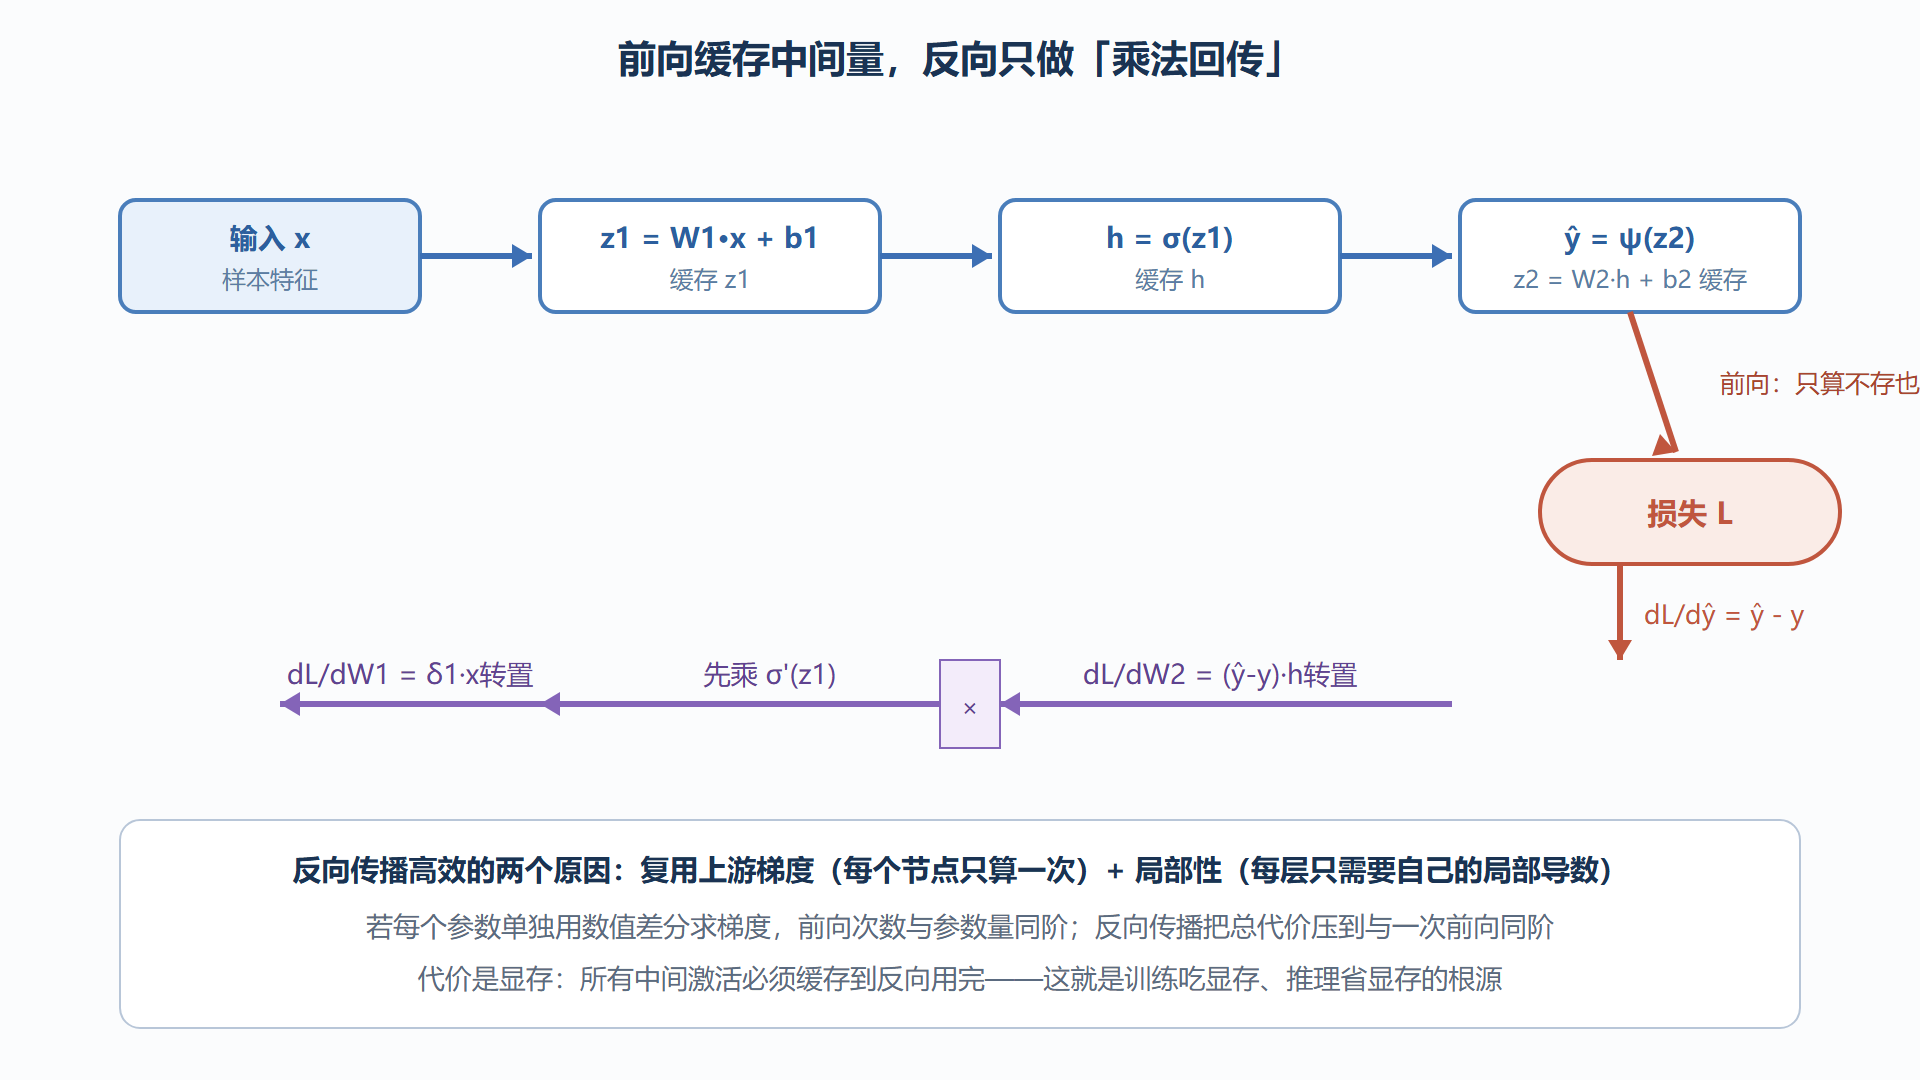
设两层网络:输入 x,第一层线性加激活 h = σ(W1·x + b1),输出层线性加 sigmoid 或 softmax 得 ŷ = ψ(W2·h + b2),损失 L(ŷ, y)。前向时缓存每层的线性输出 z1、z2 与激活输出 h、ŷ;反向时从损失出发,按链式法则逐层左乘局部导数:dL/dz2 = (ŷ - y)(对平方损失与 sigmoid 的组合有这个简洁形式),随后 dL/dW2 = (dL/dz2)·h 转置,dL/dh = W2 转置·(dL/dz2),再乘 σ'(z1) 得 dL/dz1,最后 dL/dW1 = (dL/dz1)·x 转置。每个参数的梯度都能由缓存的中间量与上游梯度拼出。
推导的口述纪律:每写一个梯度,先说「它是上游梯度乘本层局部导数」,再落笔。乱序的根源永远是「直接从参数想起」——正确顺序是沿计算图走,参数只是图上的支点。
图:反向传播的计算流——前向缓存与反向回传
追问一层:为什么要缓存前向中间量
追问:「训练为什么比推理吃显存那么多?」
面试官用显存问题考你是否真理解反向传播的机制。参考答法:反向传播的每一项梯度都由「上游回传的梯度」与「前向的局部量」相乘得到——σ'(z1) 需要 z1,dL/dW2 需要 h。这些中间激活必须从前向一路缓存到反向用完,缓存规模与 batch 大小、序列长度、网络宽度同阶;推理没有反向,随算随丢,显存只够放权重与一层中间量即可。「缓存激活」四个字答出来,这题就结束了。
追问二层:梯度消失埋在哪一环
追问:「梯度消失的原因,在推导里对应哪一项?」
这题把推导与训练现象焊在一起。参考答法:反向传播经过激活层时要乘 σ'(z)——sigmoid 的导数最大值只有四分之一,且两端趋零;层数一深,连乘起来梯度按指数衰减,靠输入端近的层几乎得不到更新。对策按层出:换 ReLU 系激活(正区间导数恒一);归一化(下一节的主角)把激活拉回导数不坍缩的区间;残差连接给梯度开一条直通的高速路,让「乘法链」多了一条「加法旁路」。梯度爆炸是同一机制的镜像,解法是梯度裁剪——按范数缩放,防止单次更新把参数甩飞。
import torch x = torch.randn(8, 16) w1 = torch.randn(16, 32, requires_grad=True) w2 = torch.randn(32, 2, requires_grad=True) h = torch.tanh(x @ w1) # 前向:缓存 h(反向要用) y = h @ w2 loss = ((1.0 / (1.0 + torch.exp(-y))) - torch.ones_like(y)).pow(2).mean() loss.backward() # 反向:autograd 沿计算图回传 print(w1.grad.shape, w2.grad.shape) # 每个参数一份梯度,形状同参数 # 手工对照:dL/dw2 = h转置 @ (dL/dy) manual_dw2 = h.T @ (2 * (1.0/(1.0+torch.exp(-y)) - 1) * (1.0/(1.0+torch.exp(-y))) * (1 - 1.0/(1.0+torch.exp(-y)))) / y.numel() print("autograd 与手推一致:", torch.allclose(w2.grad, manual_dw2, atol=1e-6))
面试里若被要求验证推导,用小张量手算两三个数再对照框架的 grad,是比「我记得结论」硬得多的证据。
易错点
- 把反向传播说成「另一种梯度下降」。它不是优化器,是梯度的高效计算方法;优化发生在拿到梯度之后。
- 推导跳步:直接写 dL/dW1 却没交代中间的 δ1。白板上每个等号都要能被追问「这一步哪来的」。
- 混淆「激活函数的导数」与「损失函数的导数」的挂载位置:前者夹在层与层之间,后者在图的末端。
- 声称「梯度消失已被 ReLU 彻底解决」。深度堆叠下 ReLU 网络照样有衰减问题,归一化与残差缺一不可。
评分要点
及格:说出「链式法则从后往前」并完成一层梯度的展开;良好:两层推导全程无断点,能回答显存与缓存的机制问题;优秀:能指出 sigmoid 导数上界并连出消失/爆炸与对策的完整故事,理解反向传播是把计算复杂度从参数量阶压到前向阶的动态规划。这节推顺了,后面三节的每一个「为什么训练不动」都有了解剖学基础。
高频追问速答
问:反向传播和自动微分什么关系?
反向传播是自动微分的反向模式在神经网络上的应用:沿计算图从输出向输入累积梯度,每个中间节点只计算一次。框架的 autograd 引擎就是通用的反向模式自动微分器——「反向传播」是历史名词,「反向模式自动微分」是实现本质。
问:为什么需要激活函数的非线性?
没有它,多层线性变换的复合仍是线性变换,网络深度失去意义。激活的非线性让网络成为万能函数逼近器;激活函数的导数性质同时决定梯度流通的好坏——这正是 sigmoid 被弃用、ReLU 系流行的原因。
问:batch size 对训练有什么影响?
大批量梯度估计更稳、吞吐更高,但泛化有时变差且需要重新调学习率(线性缩放规则);小批量噪声大、收敛路径震荡,却自带逃离尖锐极小的能力。batch size 与学习率是联动旋钮,独立调它们是常见的实验事故。
表达纪律:推导完成后主动问面试官「需要我对照某个具体损失函数展开吗」——把推导的深度选择权交给对方,是最稳的节奏控制。
深水区:三个延伸追问
问:混合精度训练为什么能加速,会不会伤精度?
前向与梯度用半精度计算提速省显存,另用单精度主权重 accumulation 防止小梯度在半精度下被舍入吞掉,损失缩放再防下溢。「半精度算、单精度存、缩放保底」十二个字是这题的完整答案。
问:梯度检查怎么做?
数值差分(扰动单个参数看损失变化)与反向传播的解析梯度对比,相对误差应在极小量级;因为代价是参数量的前向次数,只在开发期小模型上抽检,生产训练不开。
问:什么情况下梯度是对的但训练还是崩?
学习率过大导致步进震荡、数据管线送错标签、损失实现有 bug(如 log 里有零)。梯度正确只保证「方向信息对」,训练由数据、步长、数值稳定共同决定——排查时把这三者与梯度分开验证。