4.2 CNN:感受野、参数量与权值共享
4.2 CNN:感受野、参数量与权值共享
本节摘要:卷积网络的追问集中在三个可计算量上:输出尺寸、感受野、参数量。三个公式都不长,但要求你能现场算、算完讲得出设计含义——权值共享为什么省参数、堆叠小卷积核为什么划算、池化到底还剩多少存在感。这节的目标是把「听说过 CNN」升级成「能对 CNN 报出数字」。
4.1 节的全连接网络对图像有两个不经济:参数爆炸与平移不敏感。CNN 用三个约束(局部连接、权值共享、层次堆叠)回应,本节的全部追问都从这三个约束的量化后果里长出来。面试官在这里几乎不考名词解释,考的就是「报数字」——说不出公式的 CNN 回答,在资深面试里等于没答。
主问题:先把三个公式摆在桌面上
主问题:「卷积层的输出尺寸怎么算?感受野和参数量呢?」
标准答案
输出尺寸:O 等于 floor((W − K + 2P) / S) + 1,W 边长、K 卷积核、P 填充、S 步幅。感受野:第 n 层的感受野 RF(n) 等于 RF(n−1) + (K(n) − 1) × 前面所有层的步幅乘积,首层感受野等于 K。参数量:一层卷积参数等于 (K × K × 输入通道 + 1) × 输出通道,那个加一是偏置;全连接层参数等于输入维度 × 输出维度,远高于同宽度的卷积层。
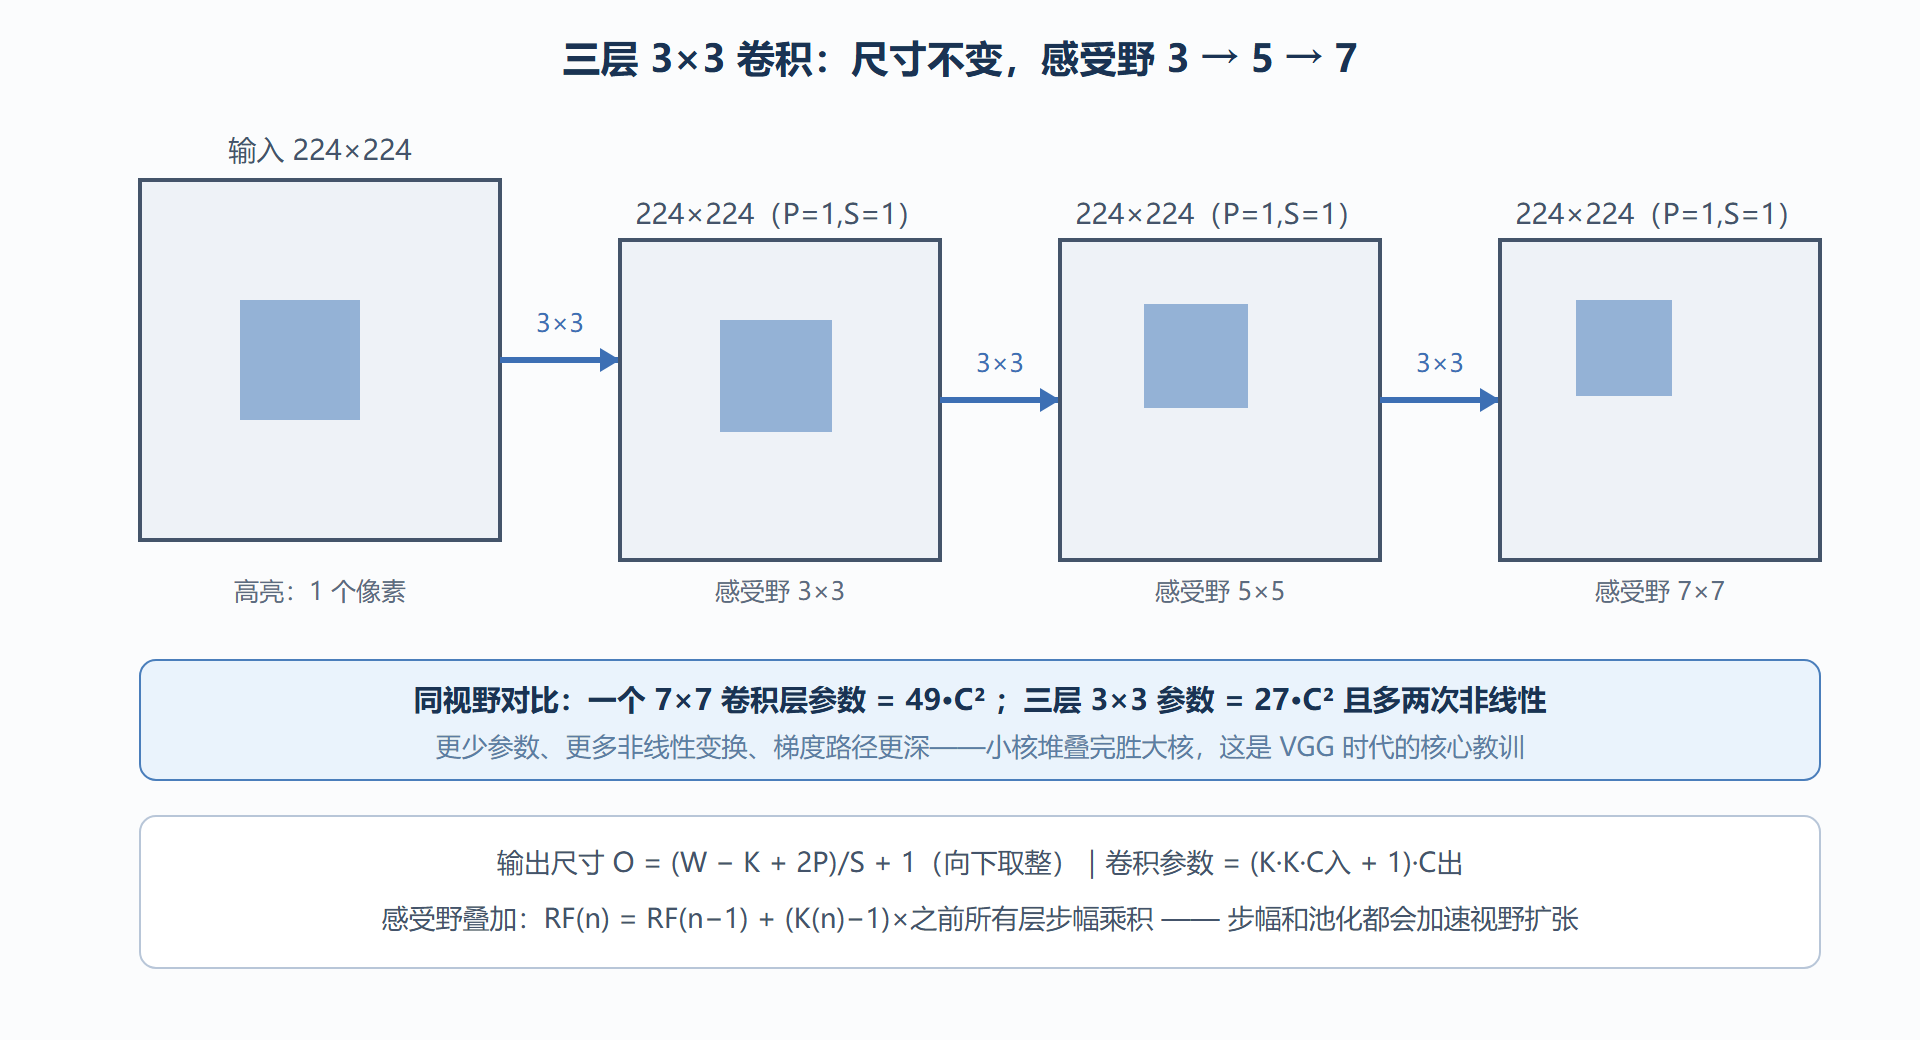
报完公式要立刻配一个数字例子展示熟练度:输入 224,连续三层卷积各用核 3、步幅 1、填充 1,则尺寸保持 224 不变,但感受野从 3 长到 5 再长到 7——「尺寸不动、视野变大」正是现代 CNN 堆叠小核的底层账本。
图:感受野随深度增长与小核堆叠的账本
追问一层:权值共享省在哪
追问:「为什么卷积参数远少于全连接?共享会不会丢信息?」
参考答法分两步。第一步讲省的机理:图像的统计规律具有平移性——「猫耳朵的边缘特征」在图像左上角和右下角是同一种特征,因此同一组核参数在所有空间位置上复用,参数量从「与像素数成正比」降到「与核模式数成正比」。第二步回应「丢不丢信息」:共享丢掉的不是信息而是自由度——每个位置不再允许有专属权重,这本身就是一种归纳偏置(先验),它用牺牲表达自由换来了泛化能力与计算效率。若数据没有平移结构(如表格数据),这个先验失效,卷积就不再是好选择——「归纳偏置匹配数据结构」这句是本节的点睛话。
追问二层:池化与 1×1 卷积的存在感
追问:「现在很多网络把池化换成了 stride 卷积,池化过时了吗?」
参考答法:最大池化带来小幅平移不变性与零参数降采样,但可学习性为零、且在「保持精细定位」的任务(分割、检测)里丢信息;步幅卷积把降采样变成可学习操作,位置信息可以被网络自己取舍。池化没有过时,而是从「标配」退回「选项」。1×1 卷积则正好相反,地位持续上升:它在空间上不聚合、只在通道维度做线性组合,是「升降维 + 跨通道融合 + 控制参数预算」的三合一工具——残差网络里的瓶颈结构就靠它先降后升,把 3×3 卷积的通道数压小再恢复。
import torch.nn as nn def conv_out(w, k, p=0, s=1, d=1): return (w + 2 * p - d * (k - 1) - 1) // s + 1 # 含空洞卷积的一般式 def conv_params(cin, cout, k, groups=1): return ((k * k * cin) // groups + 1) * cout # 含分组卷积的参数量 block = nn.Sequential( nn.Conv2d(64, 16, 1), # 1×1 降维:64 -> 16,省 4 倍预算 nn.Conv2d(16, 16, 3, padding=1), # 3×3 主力:空间特征 nn.Conv2d(16, 64, 1), # 1×1 升维:恢复通道 ) print("三层参数量:", sum(p.numel() for p in block.parameters())) print("对比直接 64->64 3×3:", conv_params(64, 64, 3))
瓶颈块与直连的参数对比是最有说服力的数字:同一视野能力,预算差出一个数量级,这正是「用 1×1 控制账本」的工程价值。
易错点
- 输出尺寸忘了向下取整,或加了两次 padding 却在公式里只加一次。白板上把 W、K、P、S 四个字母先写清楚再代数,出错率骤降。
- 把感受野与输出尺寸混为一谈。尺寸是特征图多大,感受野是「一个激活点看得见原图多大」,两层步幅卷积后尺寸减半、感受野却大增。
- 计算参数量漏掉偏置项或漏乘输入通道。参数量 = (K×K×C入 + 1) × C出,两个坑分别对应加号前后。
- 说「池化层有参数」。池化是固定算子,最大池化参数量为零——这句错了直接暴露没写过网络。
评分要点
及格:写出输出尺寸公式并正确代数;良好:三个量全部现场算对,权值共享能讲到归纳偏置层面;优秀:能把小核堆叠、瓶颈结构、步幅卷积替换池化讲成参数预算与信息保真的交易,并主动用数字对比。CNN 题的特点是答案可验证——对错当场可见,请把每个公式在草稿上代一遍再出口。
下一节把卷积的「空间堆叠」换成「时间展开」:RNN 的梯度问题与注意力对它的接棒,是序列建模追问链的主干剧情。
高频追问速答
问:空洞卷积(dilated convolution)解决什么问题?
在不加参数、不降分辨率的前提下扩大感受野——卷积核元素间插入间隔,视野随膨胀率指数增长。分割任务里它替代部分池化,避免分辨率损失;代价是网格伪影,需要不同膨胀率混合使用。
问:参数量与计算量(FLOPs)的区别,谁更值得关注?
参数量决定显存与模型体积,计算量决定延迟与能耗,两者常不同号:一乘一卷积参数少但若通道数巨大计算量可观;深度可分离卷积大幅砍两者,是移动端网络的标配。部署题先问约束是显存还是延迟,再谈结构选择。
问:为什么现代网络偏爱批归一化放在卷积后激活前?
归一化把卷积输出拉回稳定区间,激活函数工作在导数健康的区域;若放在激活后,会截断激活的稀疏性(ReLU 后再归一化会重写零点)。这是一般惯例,但不是铁律——残差网络里的 Pre-Norm 变体就反着放,训练更稳。
表达纪律:CNN 题永远先代数字再谈观点,一个算对的输出尺寸比三句「性能优异」更有说服力。
深水区:三个延伸追问
问:分组卷积省在哪,代价是什么?
通道分组后各组独立卷积,参数与计算量按组数成比例下降;代价是组间信息不交互,需要通道混洗(shuffle)补救——这是轻量网络的经典交易。
问:全局平均池化替代全连接头好在哪?
参数几乎归零、天然抗过拟合、对输入尺寸不再敏感;代价是空间信息的自由度降低。分类任务几乎统一用它,定位类任务才会保留空间结构。
问:怎么估算一个卷积网络的显存占用?
逐层累加激活内存(批量乘每层输出元素数乘精度字节数)加参数与优化器状态(动量与二阶矩让参数内存翻数倍)。训练瓶颈通常在激活,推理瓶颈在参数——两本账分开算,部署 sizing 才靠谱。