5.1 数据清洗:缺失值与异常值的两难
5.1 数据清洗:缺失值与异常值的两难
本节摘要:缺失值处理的第一问不是「怎么填」而是「为什么缺」——MCAR、MAR、MNAR 三种机制对应完全不同的安全策略;异常值的第一问也不是「怎么删」而是「它是错误还是信号」。本节给出双决策流程与一组必背的反例。
清洗题的追问模式几乎固定:先要一个默认策略,再追问「这个策略什么时候会错」。均值填充、直接删除这类标准答案人人会给,面试官真正在测的是你脑子里有没有「缺失机制」和「异常值语义」这两层分类——它们决定了标准答案何时反噬。
主问题:缺失值怎么处理
主问题:「数据里有缺失值,你怎么处理?」
标准答案
第一步先问缺失机制。MCAR(完全随机缺失):缺失与任何变量无关,删除或均值填充相对安全;MAR(随机缺失):缺失依赖其他已观测变量——年轻人更懒得填收入,此时按「与缺失相关的变量」做分组填充或模型填充;MNAR(非随机缺失):缺失依赖缺失值本身——高收入者不填收入,此时任何基于观测数据的填充都在系统性撒谎,缺失本身要当特征用。第二步选手段:简单填充(均值、中位数、众数)打样;模型填充(KNN、MICE 迭代填充)进阶;树模型管线可以直接用「缺失作独立分支或缺失指示列」;最后一步永远补一列「是否缺失」的指示特征,把「缺」这个信息本身交给模型。
「缺失指示列」这个细节是很多标准教程漏掉的:即使做了填充,缺失本身常与目标相关(不填收入的人违约率可能更高),把指示列交给模型,让它自己学习这层关系。
追问一层:你怎么判断缺失属于哪种机制
追问:「MCAR 和 MAR 怎么区分?拿什么检验?」
这题从名词进到操作,参考答法:做「缺失指示变量分析」——把每列的缺失与否变成零壹变量,与目标变量和其他特征做相关性或假设检验。缺失比例在不同群体间差异显著,基本排除 MCAR;再用领域知识区分 MAR 与 MNAR:缺失若能被已观测变量解释(收入缺失与年龄相关)是 MAR;若只能被未观测的缺失值自身解释(越有钱越不填)是 MNAR。要坦白承认的是 MNAR 无法用数据严格证明,只能靠业务判断——承认这条边界本身就是加分行为。
图:缺失值与异常值的处理决策流程
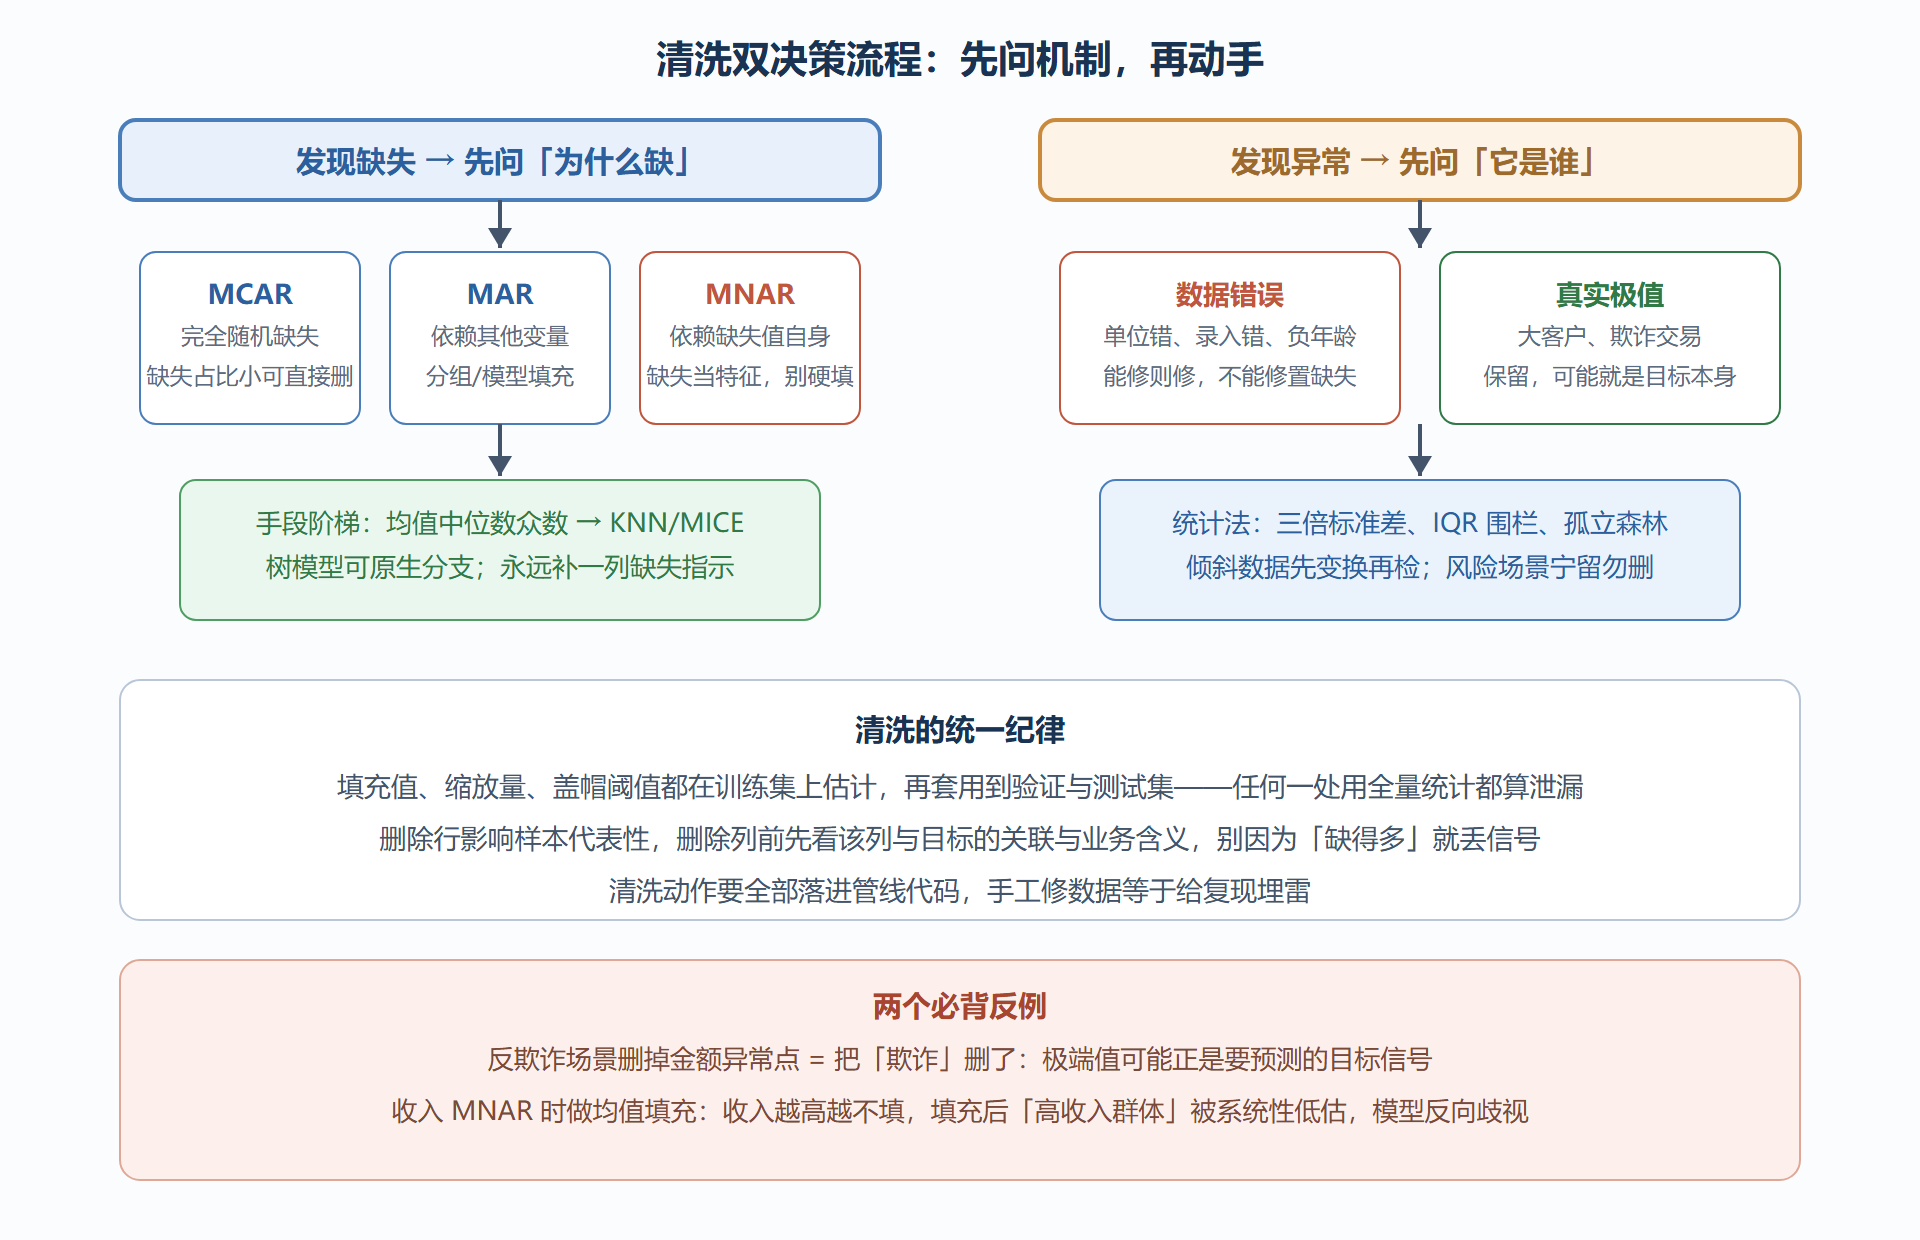
追问二层:异常值的三种来历与对应动作
追问:「异常值怎么检测、怎么处理?」
检测与处理要分开答。检测三法:单变量的三倍标准差(正态假设)或 IQR 围栏(分布自由,适合倾斜数据);多变量的孤立森林与局部离群因子——它们建模「正常模式」再找不合群者,高维下比单变量法可靠。处理则按来历分流:录入与单位错误能修则修、不能修置为缺失(交给缺失值流程);真实极值保留,改用对异常鲁棒的建模选择(树模型、分箱、Huber 损失、rank 变换)——风控与反欺诈场景甚至要反着来,异常点就是主要研究对象。
易错点
- 用全量数据算均值再填充训练集:填充值里混进了测试分布信息,属于最容易被忽视的泄漏,统计量的估计范围必须与训练折一致。
- 对倾斜数据用三倍标准差:均值和标准差本身被极值拖着走,围栏形同虚设;先做对数变换或直接用 IQR。
- 把「删除缺失多的列」当成默认动作。缺失比例高但与目标强相关的列,指示列加填充后可能极有价值——删列的依据是信息价值,不是缺失比例。
- 忘了训练与推理的清洗逻辑必须一致:上线时新数据来了走同一套填充值与盖帽阈值,这些常量要随模型一起版本化。
评分要点
及格:给出均值中位数填充与删除的基本策略;良好:三种缺失机制说清并配检验思路,异常值区分错误与信号;优秀:带出缺失指示列、倾斜数据的围栏选择、「清洗常量随模型版本化」这类生产级细节。清洗题答出生产味,往往能扭转「候选人是竞赛型选手」的印象。
下一节处理清洗完的数据怎么「变形」:缩放与编码的选择题,藏着整章最经典的两个「为什么」。
高频追问速答
问:树模型需要填充缺失吗?
多数现代实现(XGBoost、LightGBM)原生支持缺失分支,样本自动走向增益更大的方向,可以不填充;但「缺失有业务语义」时补缺失指示列仍常有增益。老实现(sklearn 的树)不支持缺失,必须先填充——「看实现版本」是这题的正确开头。
问:怎么向面试官证明你的填充策略更好?
对照实验:同一模型、同一验证口径,比较不同填充策略的验证分数,外加业务合理性检查(填充值的分布是否扭曲了特征与目标的关系)。单说「我用中位数填充」不给证据链,只算及格。
问:异常值检测的多变量方法有哪些?
孤立森林(随机切分、异常点更易被隔离)、局部离群因子(相对邻居密度)、一类分类器(学正常模式)。选择信号是维度与数据量:高维大库用孤立森林,关注局部密度差异用 LOF。
表达纪律:清洗题的每个动作都配「在哪个数据集上估计」的说明,这是本节的最高频考点,也是生产事故的头号来源。
深水区:三个延伸追问
问:缺失指示列什么时候反而有害?
缺失模式纯随机且占比极低时,指示列接近常数列,只添噪声;它真正发光的场景是 MNAR 或缺失与目标相关的情形。指示列也是特征,也要过特征选择的审查——「自动加指示列」不是免检动作。
问:异常值处理能交给模型自己吗?
部分能:树模型对单点异常天然钝感(分裂只看排序),Huber 类损失对回归的异常残差限幅;但均值填充与线性模型没有这层免疫力。模型选择本身就是异常处理的手段之一,这条经常被忽略。
问:怎么监控线上的数据质量?
三个水位:空值率与取值分布的日环比、特征与目标的覆盖完整性、上游表的结构指纹(字段与枚举值清单)。数据质量监控是特征管线的烟雾报警器,成本极低、收益极高——工程岗面试里这是必带的加分项。
追加两问
问:缺失值处理要不要区分训练与推理的数据源差异?
要。训练期缺失常来自历史表结构变迁,推理期缺失来自线上采集失败——两者的机制可能完全不同,用训练期的填充逻辑去兜推理期的缺口会错配。上线前用推理期真实缺失样本回放填充路径,是特征服务上线检查的一部分。
问:怎么写一份数据质量报告让面试官认可你的清洗?
五要素:缺失画像(各列缺失率与机制判断)、异常清单(检测方法与处理决策)、口径变更记录(相对上游的任何修正)、样本影响评估(清洗前后样本量与目标分布变化)、可复现性(全部动作已管线化)。有报告意识的候选人,会让面试官默认他的实验数字也可信。
再补一问:填充值影响特征重要性排名吗?
会——填充段样本的特征值被拉到统一常量,树模型会低估该特征在填充密集区间的判别作用,重要性排名随之失真。做特征选择前,要么剔除填充占比过高的区间样本再评估,要么把填充占比本身当作该特征质量的一部分纳入审查。