5.3 特征选择:过滤、包裹与嵌入三式
5.3 特征选择:过滤、包裹与嵌入三式
本节摘要:特征选择三条路线:过滤式先按统计分数筛,快而粗糙;包裹式用模型效果反复试,准而昂贵;嵌入式让训练过程顺带选特征,两者的折中。本节讲三条路线的原理与代表方法、相关性度量的陷阱、以及「怎么证明你选的特征有用」这道压轴追问。
变换之后的特征集合往往还是冗长:共线性、噪声列、与目标毫无关系的幽灵特征都在其中。特征选择追问的深层考点是「维度与效果的权衡意识」——少而准的特征能降方差(呼应 1.2)、省推理成本、提高可解释性。三条路线的差异本质上是「用什么信号判断特征好坏」的差异。
主问题:三条路线一张网
主问题:「特征选择有哪些方法?各举代表并比较。」
标准答案
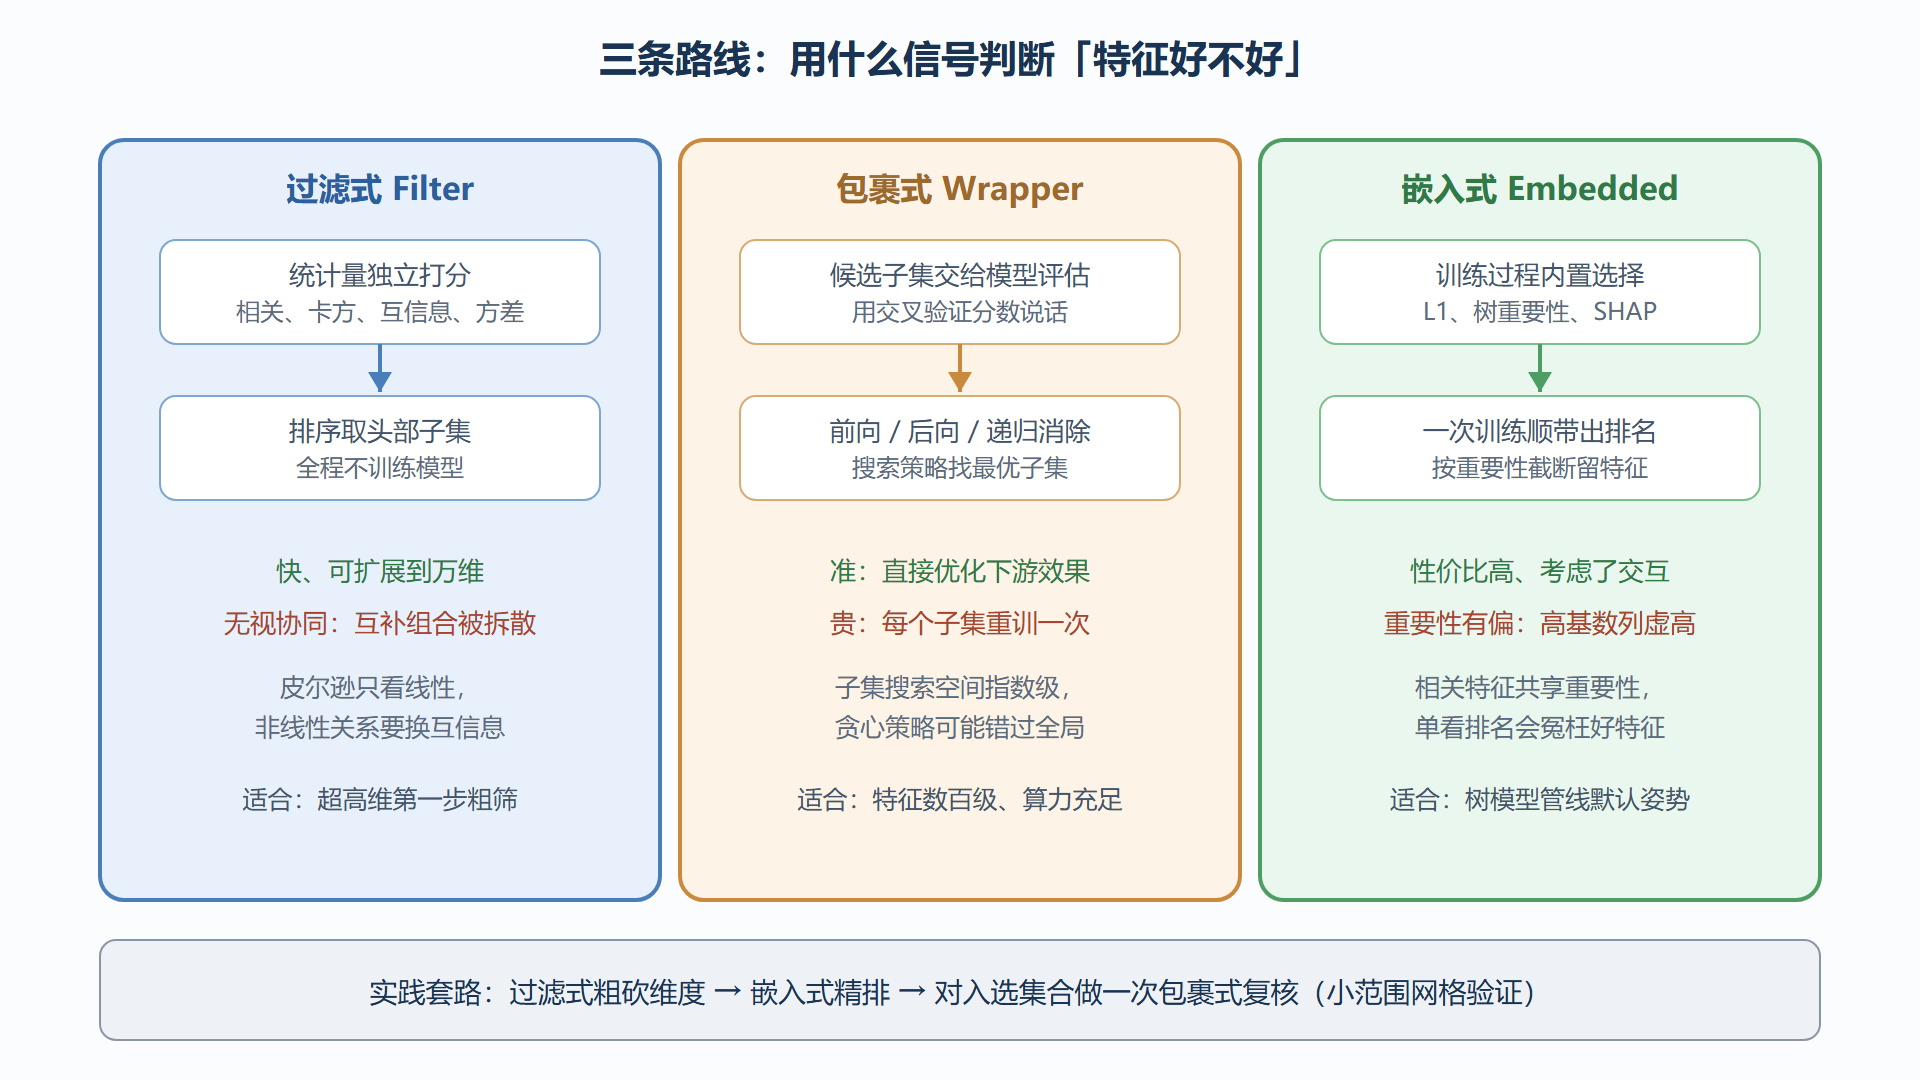
过滤式在训练模型之前用统计量独立打分:方差阈值先清零方差列,再按皮尔逊相关(连续对连续)、卡方检验(类别对类别)、互信息(非线性通用)排序取头。它快、与模型无关,但无视特征间协同,单看每个都弱、合起来很强的组合会被误杀。包裹式以模型验证效果为标准搜索特征子集,前向逐步添加、后向逐步剔除或递归特征消除,准确但对每次子集都要重训模型,计算昂贵且易过拟合验证集。嵌入式把选择融进训练:L1 正则把弱特征系数压到零,树模型的特征重要性、以及基于置换重要性与 SHAP 值的筛选,训练一次顺带收获排名。
一句话对比:过滤式看「特征与目标的关系」,包裹式看「特征组合对模型的效果」,嵌入式看「模型自己认为谁重要」。三者常用叠加姿势是先用过滤式粗筛砍维度,再上嵌入式精排。
图:特征选择三式的机制对照
追问一层:相关性为什么靠不住
追问:「为什么不能只用皮尔逊相关来选特征?」
参考答法给出三记重锤。第一,它只测线性单调关系:目标与特征是 U 形关系时,皮尔逊接近零,特征被冤杀,互信息或分箱后的秩相关能补这个洞。第二,它孤立地看单特征:两个各自弱相关、组合后强判别的特征(经典异或结构)全部落选;共线特征对里它还会留下「谁先来谁占位」的任意结果。第三,它对目标类型不敏感:分类任务直接套皮尔逊会忽略类别结构,卡方或互信息才是对口度量。收尾补一句正确的使用姿势:过滤式分数当粗筛的「及格线」,最终去留交给模型验证。
追问二层:怎么证明你的选择是有效的
追问:「你删掉了三成特征,怎么向面试官证明效果没有损失?」
这题考实验设计,参考答法是一套固定动作:固定同一划分与随机种子,跑一组对照——全特征基线、过滤后特征、过滤加嵌入精选特征,各重复多个随机种子报均值与方差;汇报三个维度:验证指标差距(希望不降或反升)、推理耗时与内存(通常显著下降)、稳定性(指标方差变小即选出的特征集更稳)。若特征是被业务方追问的,再补置换检验:把被删特征打乱重训,验证指标几乎不动,即证其冗余。能主动提到「多个种子与方差」的候选人凤毛麟角,这一句足以撑起「做过实验」的印象。
from sklearn.feature_selection import mutual_info_classif, SelectKBest from sklearn.model_selection import cross_val_score from sklearn.ensemble import RandomForestClassifier from sklearn.base import clone # 过滤式:互信息粗筛(非线性、无方向偏置) selector = SelectKBest(mutual_info_classif, k=40).fit(X_train, y_train) Xtr_k, Xva_k = selector.transform(X_train), selector.transform(X_val) # 对照实验:全量 vs 粗筛后的多种子验证 base = RandomForestClassifier(n_estimators=300, random_state=0) for label, Xa, Xb in [("全量", X_train, X_val), ("精选", Xtr_k, Xva_k)]: scores = [] for seed in (0, 1, 2): m = clone(base); m.set_params(random_state=seed) m.fit(Xa, y_train); scores.append(m.score(Xb, y_val)) print(label, "多种子均值:", round(sum(scores) / 3, 4))
代码里的对照组与多种子循环就是上一问的落地:特征选择的辩护词不是「我用了高级方法」,而是「同一口径下数字没掉、成本降了」。
易错点
- 在切分之后做特征选择:用全量数据算相关性或重要性再选列,验证集信息渗入选择过程,分数虚高——与填充、缩放是同一泄漏家族。
- 用树的重要性排序后断言因果:重要性高只说明「模型用了它」,混杂与偏倚照旧;高基数类别列在分裂不纯度指标里天然占便宜,置换重要性是更诚实的口径。
- 包裹式搜索用测试集当裁判:搜索过程把测试集信息磨平,最终分数失去泛化意义;裁判必须是独立验证折。
- 选完特征忘了重训与上线同步:线上特征服务里被删特征还在算,白费成本——选择结果要落进特征清单。
评分要点
及格:说出三式代表方法与基本取舍;良好:相关性三记重锤(线性偏置、无视协同、共线占位)答全,并能设计对照实验;优秀:置换重要性与 SHAP 的偏差讨论、「多种子报方差」的实验素养、跨集泄漏的统一纪律。特征选择题的终极答案是实验设计能力——它同时是 7.3 节项目深挖题的标准弹药。
下一节补完特征工程的最后一环:无中生有地造特征——交叉、聚合与时间窗,是竞赛与业务管线共用的增压器。
高频追问速答
问:特征选择和特征提取(降维)怎么选?
选择保留原始特征、可解释、可审计,适合合规与业务汇报场景;提取(PCA 等)压缩信息但产生不可解释的新变量。要向监管解释模型,选择几乎总是优先;纯效果导向且特征极度冗余时,提取有用武之地。
问:递归特征消除的成本怎么控制?
RFE 每轮全量重训太贵,工程上常用「训练一次拿重要性、批量砍尾部」的变体,或先过滤粗筛到几百维再 RFE 精修。搜索预算永远花在刀刃上,这是调参章纪律在特征侧的投影。
问:怎么发现「两类特征互相顶班」的冗余?
先做相关性或互信息聚类,把强相关特征分组,组内做竞争性选择(留重要性最高者或做组合检验);再用留一特征实验验证删减无损。顶班问题单看重要性排名永远发现不了。
表达纪律:选择题的终局是实验设计,面试官在等你说出「对照组、多随机种子、指标均值与方差」这套词汇。
一条被低估的纪律:选择结果的业务复核
机器选出的特征集要过一遍业务审判:是否有因果含义(还是纯投机相关)、线上是否能稳定供给、是否存在合规敏感字段(种族、性别代理变量)。投机特征离线好看、上线漂移,代理变量会引入公平性风险。特征选择不是纯统计动作,选出来的清单同时是一份业务与合规文件——能说出这句的人,面试官会默认你在真实业务里摸爬过。