5.4 特征构建:交叉、聚合与时间窗
5.4 特征构建:交叉、聚合与时间窗
本节摘要:特征构建是特征工程里最像手艺的部分:把领域知识翻译成模型可读的量——交叉捕捉联合效应,聚合压缩历史行为,时间窗刻画趋势与节奏。本节给出系统的构建手法清单、防泄漏的时间纪律,以及「特征从想法到上线」的验证闭环。
前三节在「删与改」,这一节在「造」。构建题在面试里的价值密度极高:它无法靠背诵糊弄——面试官随口一句「你这个业务里会造什么特征」,立刻分辨出真做过与背过的人。本节把手法系统化,但先说清一个立场:好的特征来自对数据生成过程的理解,工具只是翻译器。
主问题:造特征的手法清单
主问题:「除了原始字段,你会从哪里挖特征?」
标准答案
四类矿藏按序开采。其一,领域比率:客单价等于金额除以件数、负债收入比、点击率——业务里现成的比率几乎都是强特征;其二,交叉组合:类别乘类别(城市乘品类)、类别乘数值(品类下的消费额)、连续乘连续(收入乘工龄),捕捉单独存在时不显现的联合效应,树模型虽能自行分裂逼近,但显式交叉能省下树深并提升线性模型;其三,历史聚合:按实体分组统计均值、最大、方差、分位数——同一用户过去三十天的平均消费、同一商户今天的累计成交;其四,时间窗衍生:滑动窗口内的趋势斜率、环比波动、距上次行为的间隔时长,把「变化的速度与节奏」变成数字。
四类手法有一个共同的验收标准:每个新特征都要能讲出「它对应现实世界的什么」。讲不出业务含义的特征,与其说是工程,不如说是给过拟合撒种子。
追问一层:时间特征的纪律
追问:「用历史行为造特征,怎么保证不算到未来的数据?」
这是构建题里最凶险的追问,答案是一套时间纪律:任何聚合只能使用「当前样本时点之前」的数据,训练集与测试集要按时间切分(后段做验证),窗口统计的落点必须与线上推理时点对齐。经典事故是把「用户当月总消费」用在月中的样本上——全月数字包含了未来。更隐蔽的是「实体泄漏」:同一用户的多条样本被随机分进训练与验证两侧,聚合特征在两侧共享了同一来源,验证分数虚高;按实体分组切分才能测出真实泛化。这道题与第 6.1 节的时间序列交叉验证直接接壤,两处口径必须一致。
图:特征构建的四类矿藏与验证闭环
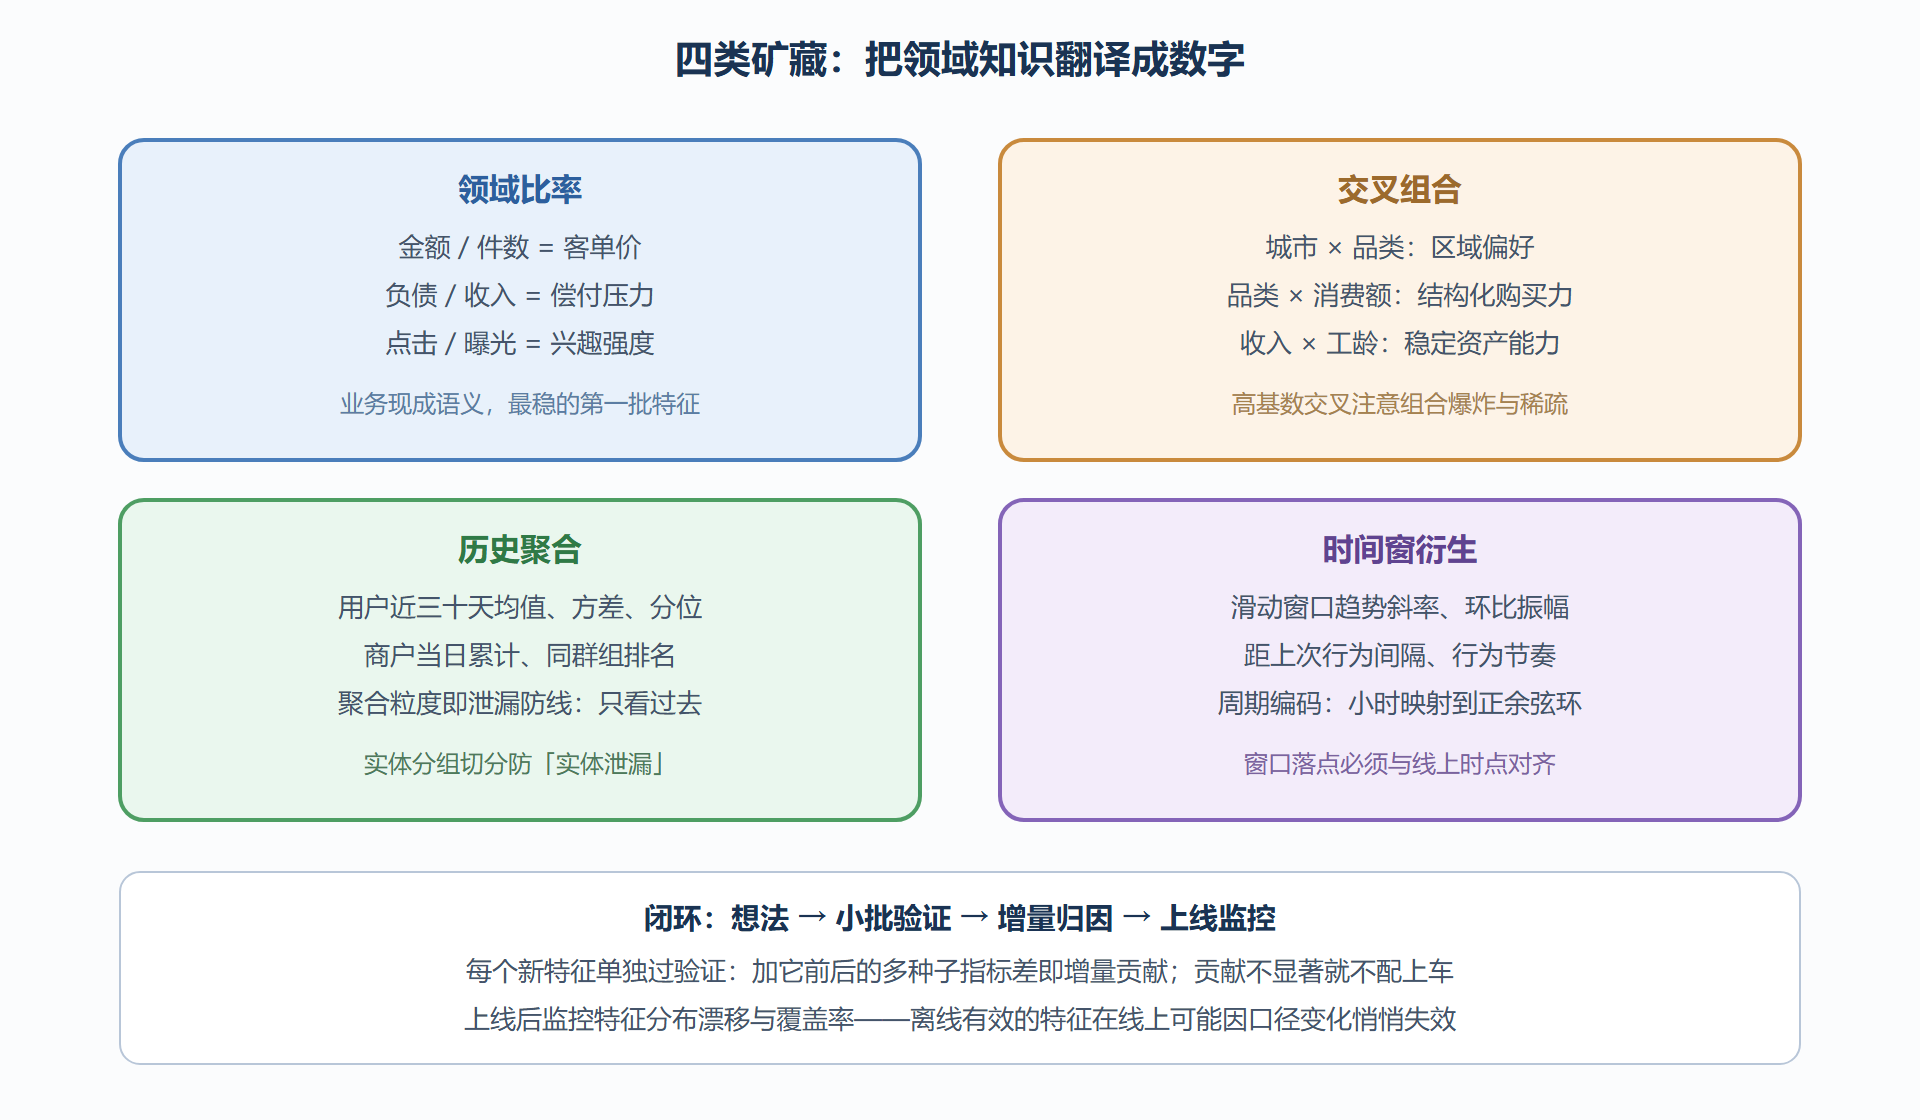
追问二层:交叉特征树模型能自己学,为什么还要手工
追问:「GBDT 不是能自动捕捉非线性与交互吗,人工交叉还有价值吗?」
这题考对模型能力的边界感。参考答法:树确实能通过连续分裂逼近交互效应,但逼近是有成本的——高阶交互需要更深的树、更多的数据,样本不足时学不出或学歪;显式交叉把领域先验直接喂给模型,等效于「帮树省下搜索预算」。在线性模型与 FM、深度推荐网络里,人工或自动交叉更是主力机制而非补充。反过来也要承认:低阶主效应充足时,盲目堆交叉只是增加过拟合面与维护成本。结论:交叉的收益与「交互强度高、数据相对不足」的程度成正比,这句条件化的结论值得背下来。
import pandas as pd def build_features(df, window=30): df = df.sort_values(["user_id", "ts"]) g = df.groupby("user_id") # 历史聚合:只统计窗口内(防未来),shift 保证不含当前行 hist = (g["amount"].transform(lambda s: s.shift(1).rolling(window, min_periods=3).mean())) df["avg_amt_win"] = hist df["amt_ratio"] = df["amount"] / df["avg_amt_win"] # 领域比率 df["city_x_cate"] = df["city"] + "_" + df["category"] # 类别交叉 # 周期编码:小时映射到环形,避免「23 点与 0 点距离远」的假象 df["hour_sin"] = np.sin(2 * np.pi * df["hour"] / 24) df["hour_cos"] = np.cos(2 * np.pi * df["hour"] / 24) return df
这段样板浓缩了三条纪律:shift 负责把「当前行」排除出统计、窗口语义显式化、周期特征用环形编码替代裸整数。
易错点
- 交叉组合不看基数:基数大的两列直接拼接,组合数爆炸且长尾组合样本稀疏,先截断头部或用目标编码处理组合本身。
- 时间窗统计包含当前行或未来行:验证分数「好得可疑」往往就是这里漏了,修正后掉分是正常现象而不是退化。
- 周期特征用裸整数:小时零与二十三在数值上最远、在时钟上相邻,正余弦环编码是标准修法;星期、月份同理。
- 造完不删:几百个衍生特征全量入模,噪声列互相稀释重要性;构建要与 5.3 的选择联动,造完必筛。
评分要点
及格:给出比率、交叉、聚合中任意两类实例;良好:四类手法齐备,时间窗纪律(只看过去、时点对齐、实体切分)完整;优秀:能讲「树模型与手工交叉的分工条件」,并把特征上线后的分布监控纳入答案。构建题的高分段属于能把业务语言与特征语言双向翻译的人——这也是 7.3 节项目深挖时最值钱的能力。
第 5 章至此走完数据入口的全程。下一章解决「怎么证明这套特征和模型真的行」:交叉验证的变体与陷阱,是全书防泄漏方法论的总闸门。
高频追问速答
问:特征交叉爆炸怎么控制?
三道闸:业务先验先行(只交叉有业务含义的组合);基数截断(组合类别取头部,长尾归其他);模型侧兜底(高阶交互交给 FM、深度网络或 GBDT 的隐式分裂)。交叉不是越多越好,每个组合都要过「讲得出业务含义」的审查。
问:时间窗特征在上线时怎么保证口径一致?
离线与在线共用同一套特征计算代码或同一特征平台,窗口的起点、终点、粒度全部参数化并对齐;上线前用回放流量做离在线一致性校验,比对特征值的分布与抽样误差。口径对不上,模型再准也是沙上楼。
问:周期特征除了正余弦还有别的编码吗?
可以把周期量转成「距参考点的时间差」(距月初天数、距上次行为小时数),或者直接离散化成分段变量。正余弦的独特点是保序环形距离,适合线性与距离模型;树模型对裸整数也不太挑剔——编码选择依然要回到「下游模型是什么」。
表达纪律:构建题每个特征都带一句业务翻译——「这个量度量的是现实里的什么」。翻译能力是本节的评分锚点。
深水区:两个延伸追问
问:特征存量大了以后怎么管理?
特征平台化:统一注册(定义、口径、所有者)、 lineage 追溯(每个特征能查到上游表与变换)、训练与线上同一套计算逻辑。特征复用的前提是口径唯一——同一特征两套算法是数据团队的慢性病。
问:怎么衡量一个新特征值不值得上线?
三个口径:增量指标(多种子对照的验证分数差)、成本口径(计算与存储开销、延迟增加)、稳定口径(线上分布漂移敏感度)。三口径全过才上车,缺任何一个都可能在半年后变成债务。