6.1 交叉验证:变体选择与防泄漏纪律
6.1 交叉验证:变体选择与防泄漏纪律
本节摘要:交叉验证的核心贡献不是「多算几次平均」而是「让每个样本都轮当一次裁判」。变体选择是本题的全部深度所在:分层 K 折防不平衡失真、时序切分防未来信息、分组切分防实体泄漏、嵌套验证防选择偏差。本节给出完整的变体决策与管线纪律。
这一章开篇就撞上全书出现频率最高的「事故题」:离线分数漂亮、上线效果拉胯,排查下来十有八九是验证设计作弊。交叉验证的追问链因此有固定剧本——先让你背 K 折,再让你选变体,最后用一个场景题看你能不能识别泄漏。前两章埋的三处伏笔(填充、缩放、目标编码)都在这里收网。
主问题:K 折到底在验证什么
主问题:「解释一下 K 折交叉验证,它比单次留出好在哪?」
标准答案
把训练数据切成 K 份不重叠的折,轮流以其中一份当验证集、其余合并当训练集,得到 K 个分数后取均值与标准差。它比单次留出的价值有两条:其一,每个样本都会被验证一次,分数不再依赖某次「手气好」的切分,方差更小;其二,均值之外还能报告标准差,对模型间的差异判断带上置信感——两个模型均值差不到标准差,不能急着下结论。代价是训练成本乘以 K,且它验证的是「超参配置」而非某个具体模型实例:最终上线前还要用全部数据按选定配置重训一次。
「验证配置而非实例」这句是资深感的标志:交叉验证选的是超参数,产出的是「该用什么配置」的结论,别忘了重训。
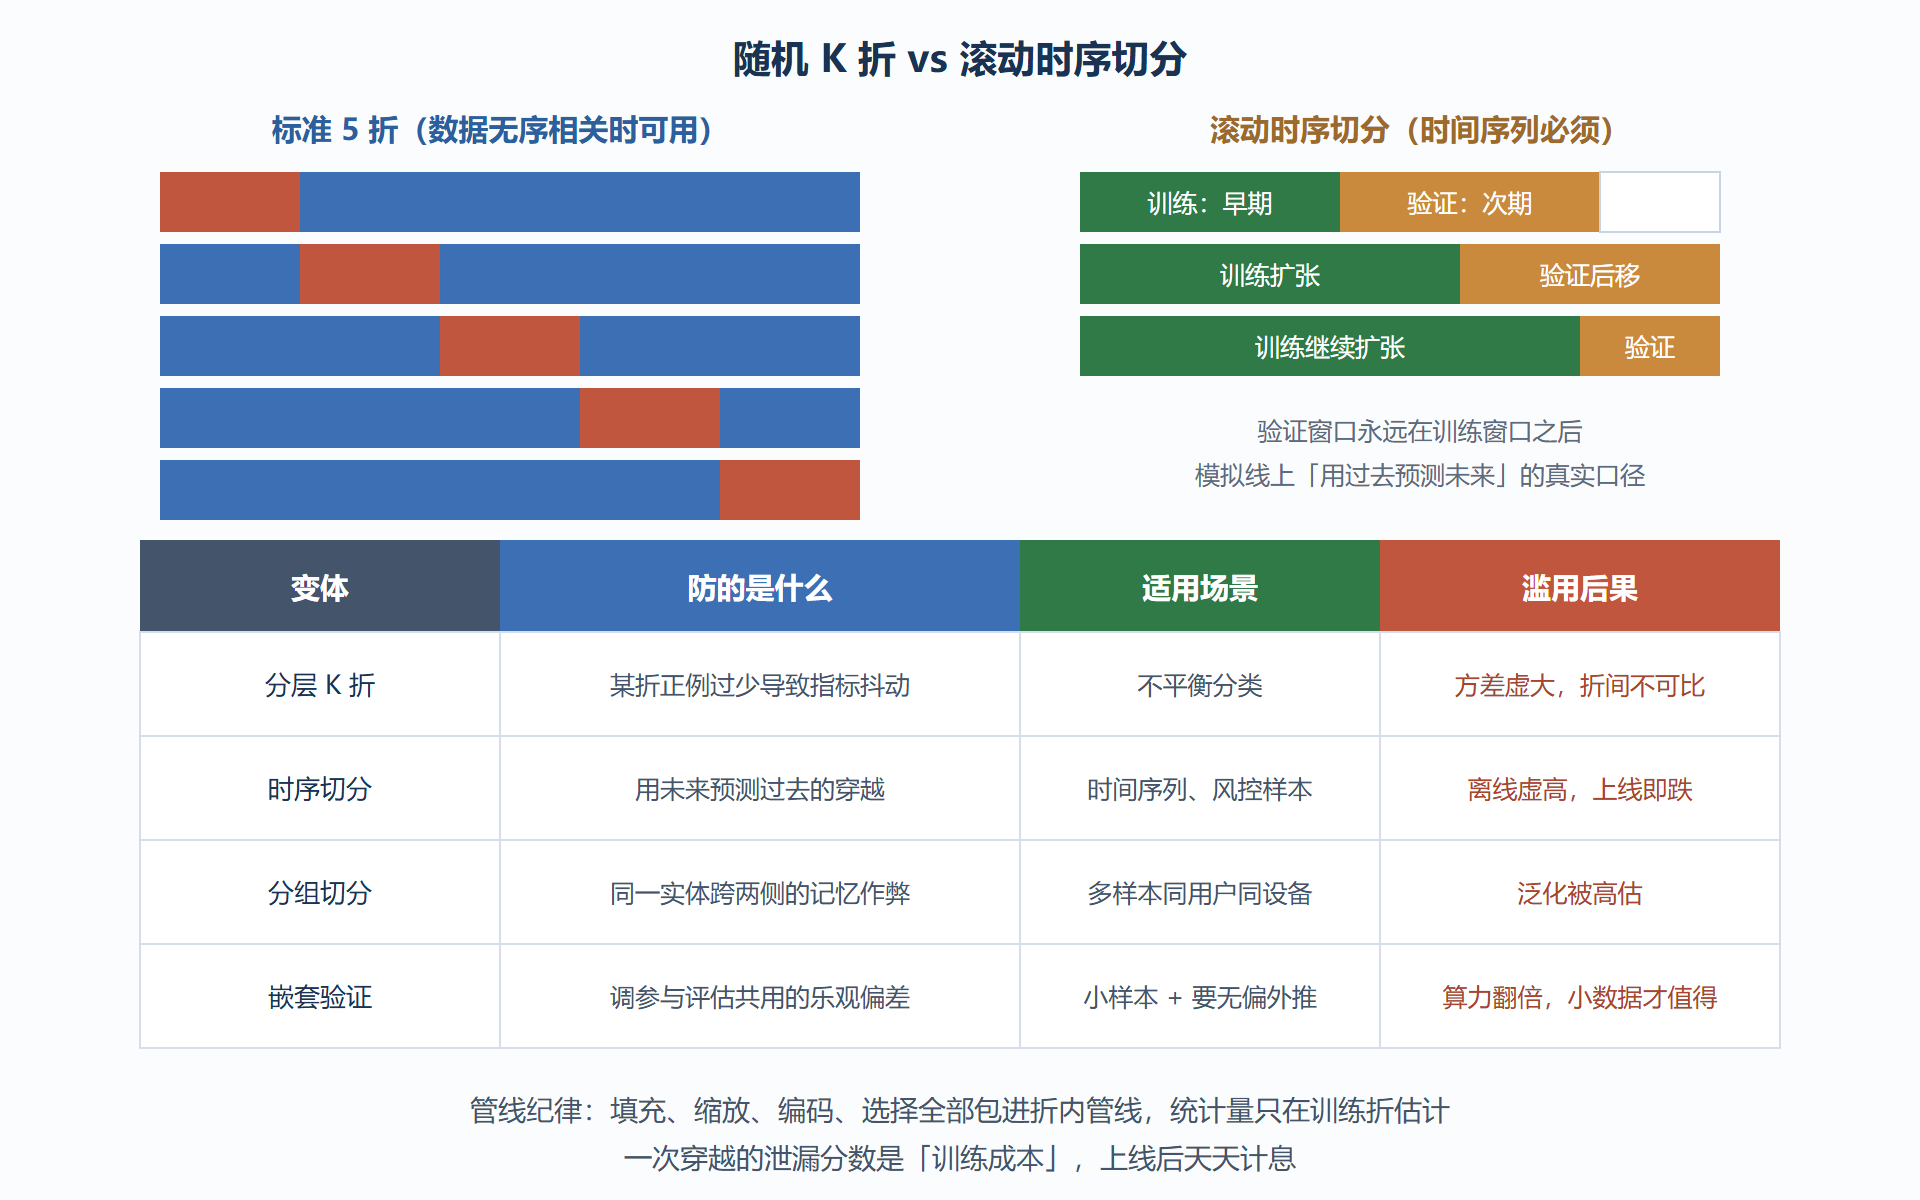
图:K 折交叉验证的切分结构与时序变体
追问一层:场景题——这个分数能信吗
追问:「风控模型随机 5 折验证 AUC 零点九二,上线掉到零点七,最可能是什么?」
面试官给的就是上一张图的滥用后果表。标准排查顺序:先查是否同一用户的多笔申请被随机分到两侧——分组泄漏会让模型在验证集里「认出老朋友」,AUC 虚高;再查时间穿越——验证折里有比训练折更新的时间点,而特征是全期统计的;最后查特征口径——训练用的历史聚合在线上拿不到同样窗口的数据。三查的顺序按出现频率排:实体泄漏与时间穿越占绝对多数。能立刻反问「样本与用户是不是一对多、数据有没有时间字段」的候选人,面试官基本可以确认他踩过或修过这个坑。
追问二层:嵌套交叉验证是什么、什么时候值得
追问:「调参也用验证集,评估也用同一个验证集,会不会乐观?怎么破?」
参考答法:会,这是模型选择偏差——超参是在验证分数上挑的,同一分数再被当成泛化估计必然乐观。嵌套验证的解法是内外两圈:外圈轮流出「外折」做无偏评估,内圈在外折的训练部分里做完整调参,外折上的分数才是诚实的泛化估计。代价是计算量乘上内圈折数,通常只在小样本、需要向论文或业务方给出严谨置信数字时启用;工业实践常用「独立保留测试集只碰一次」的廉价替代——纪律是把测试集当封存的证物,任何迭代决策都不许看它。
易错点
- 把交叉验证当「提升效果的方法」。它不提升任何东西,只是更诚实地估计;说「用交叉验证把 AUC 提高了」属于概念级错误。
- K 的选择无脑取十:K 大训练贵、折间相关性高;K 小方差大。样本充足时五折与十折差异有限,算力紧张时三折起步,方差大时报告标准差。
- 预处理在折外做全量拟合——第 5 章三连警告的根源,管线化(Pipeline)就是为把它变成不可能犯错。
- 时序数据用了随机 K 折还振振有词「交叉验证都这样」:数据有没有时间结构,决定用哪把尺子。
评分要点
及格:说清 K 折流程与「每样本当一次裁判」的价值;良好:四种变体各自防的自欺对得上号,管线防泄漏纪律完整;优秀:能现场做泄漏排查(实体、时间、口径三查),并用嵌套验证或封存测试集讲清模型选择偏差。这节的纪律是全书最常被引用的——后面每一道工程题的答案里,几乎都有它的影子。
分数可信之后,下一个问题是「还能再挤多少」:超参搜索的预算学,请看下一节。
高频追问速答
问:留一法(LOO)什么时候值得用?
样本极少(几十条)且模型训练便宜时,留一法榨干每一条样本的评估价值;样本一多成本爆炸,且单折训练集与全量几乎相同的特性会让方差估计失真。它是教科书方法,工业实践极少主力使用。
问:分层还能用在回归任务吗?
可以——把连续目标分箱后按箱分层,保证每折的目标分布相似。K 折的一切变体都围绕「让折与折同分布」这个目标展开,理解了这一点,遇到新场景可以自己发明变体。
问:重复交叉验证是什么,什么时候需要?
同一 K 折方案换多个随机种子重复多轮,报告分数的均值与跨轮方差,进一步压低切分运气的影响。样本少、模型间差距小、需要严谨比较时值得;常规迭代迭代它太贵。
表达纪律:凡报分数必带切分方式;凡比较模型必带方差。这两句口头禅能把你的可信度拉高一档。
深水区:三个延伸追问
问:样本不均衡加时间结构叠加时,验证怎么设计?
先保时间(滚动切分是硬约束),再在时间窗内做分层(每个窗口内保持类比例),最后检查实体不跨窗(分组约束)。三个约束叠加时验证集会变小,此时接受更宽的置信区间而不是偷偷放宽约束——纪律的价值在难守的时候才显现。
问:验证分数的方差很大说明什么?
三种可能:数据量不足(每折训练集差异大)、任务本身噪声大(标签不一致)、或模型对初始化敏感。处理顺序是先加重复次数看方差是否收敛,再检查标签质量,最后才怀疑模型。「先诊断再下药」的顺序感是这题的评分点。
问:交叉验证分数怎么换算成线上预期?
不能直接换算——交叉验证估计的是历史分布上的泛化,线上是动态分布加服务损耗。诚实的做法是:交叉验证管模型间相对比较,线上预期靠影子流量或小流量灰度实测;两套数字各管一段,混着报会被资深面试官当场指出。
收束:验证设计的四问检查单
给任何一次实验设计做收尾审查时,按四问走一遍:其一,数据有没有时间结构(有则滚动切分是硬约束);其二,样本之间有没有实体关联(同用户同设备多态样本须分组切分);其三,类别是否倾斜(分层保比例,指标换 PR 系);其四,有没有在切分之外做过任何全量统计(缩放、编码、填充、选择、降维,逐一排查)。四问全过,你的分数才有资格进汇报材料——这节是全书防泄漏方法论的总闸门,值得把检查单背成本能。
再补一个真实场景的收尾演示:广告转化模型的团队用随机七折验证 AUC 零点八五,上线后转化成本劣化,排查发现同一设备的多条曝光与转化记录被随机拆进训练与验证两侧,设备指纹成了「免检通行证」;改为按设备分组切分后,离线 AUC 掉到零点七四——那才是模型的真实水平。离线的十三点跌落没有让模型变差,只是让评估变诚实了。这个案例把本节所有纪律串成一件事:验证设计的每次妥协,都会在上线日连本带息地讨回。